CGGA数据库实操:从下载到OS曲线、Cox回归、时间依赖ROC,一套代码跑通
- 2026-10-29 03:31:20
本号由统计之光团队老师所创,有技巧有思路有解读,欢迎关注!10年医学科研指导经验,1v1指导超5000人发表SCI👆
之前我们讲了CGGA是什么、有哪些数据、哪些科室用得上。这一篇直接上手:从官网下载临床表和表达矩阵,整理成可分析的数据框,再跑OS曲线、单因素Cox森林图和时间依赖ROC。代码用R,基因以LOX为例;把函数里的gene="LOX"改成你的目标基因,整套流程可以直接复用。
本文假设你会基本R操作,知道什么是数据框、因子和函数。代码不是黑箱:每段都说明输入、输出和需要检查的地方,你可以按自己的基因和临床问题调整。
在CGGA官网的Download页选择mRNAseq_693和mRNAseq_325,分别下载临床表(clinical)和RSEM基因水平矩阵(RSEM-genes)。
CGGA.mRNAseq_693_clinical.20200506.txt
CGGA.mRNAseq_693.RSEM-genes.20200506.txt
CGGA.mRNAseq_325_clinical.20200506.txt
CGGA.mRNAseq_325.RSEM-genes.20200506.txt
临床表共13列,列名自带注释,例如Censor (alive=0; dead=1)、Radio_status (treated=1;un-treated=0)。不同版本的列名可能变化,读入后先用names(clin)核对,不要盲目按列号取。693和325是两个独立队列,样本ID没有重叠,适合做训练—验证;但两套RNA-seq的测序平台和批次不同,不能直接合并。
两者都是成人弥漫性胶质瘤,693样本量更大、常用于训练,325常作验证;但这不是硬性规定。关键是先明确研究问题:如果做原发胶质瘤的预后模型,两个队列都只取Primary;如果研究复发,另当别论。下载时临床表和表达矩阵要能按CGGA_ID对上;文件名日期不同不一定代表样本不同,但混用前要核对样本ID和注释版本。
下面这个函数做四件事:读入文件、重命名关键列、提取目标基因、统一因子水平。
library(survival)library(survminer)library(timeROC)library(ggplot2)library(dplyr)library(broom)read_cgga <-function(clin_file, expr_file, gene ="LOX") {clin <-read.delim(clin_file, check.names =FALSE, stringsAsFactors =FALSE)# 按20200506版列序重命名;换版本请先核对列名names(clin)[2] <-"PRS"names(clin)[8] <-"Censor"names(clin)[9] <-"RT"names(clin)[10] <-"Chemo"names(clin)[11] <-"IDH"names(clin)[12] <-"Codel"names(clin)[13] <-"MGMT"expr <-read.delim(expr_file, check.names =FALSE, stringsAsFactors =FALSE)stopifnot(gene %in%expr$Gene_Name)vals <-unlist(expr[expr$Gene_Name ==gene, -1], use.names =FALSE)gene_df <-data.frame(CGGA_ID =colnames(expr)[-1],expr =as.numeric(vals))dat <-merge(clin, gene_df, by ="CGGA_ID")dat$expr_log2 <-log2(dat$expr +1)dat$Grade <-factor(dat$Grade, levels =c("WHO II", "WHO III", "WHO IV"))dat$Gender <-factor(dat$Gender, levels =c("Male", "Female"))dat$IDH <-factor(dat$IDH, levels =c("Wildtype", "Mutant"))dat$Codel <-factor(dat$Codel, levels =c("Non-codel", "Codel"))dat$MGMT <-factor(dat$MGMT, levels =c("un-methylated", "methylated"))dat$RT <-factor(dat$RT, levels =c(0, 1), labels =c("No", "Yes"))dat$Chemo <-factor(dat$Chemo, levels =c(0, 1), labels =c("No", "Yes"))dat <-subset(dat, PRS =="Primary"& !is.na(OS) & !is.na(Censor) & OS > 0)dat}dat693 <-read_cgga("CGGA.mRNAseq_693_clinical.20200506.txt","CGGA.mRNAseq_693.RSEM-genes.20200506.txt")write.csv(dat693, "CGGA_693_LOX_analysis.csv", row.names = FALSE)整理好的分析表可单独导出,后续换模型不用重复整理。
几个关键点:
· OS单位是天;Censor=1表示死亡,0表示存活。
· 只保留原发样本,避免复发样本混杂。693例中符合“原发+OS/Censor完整”的为404例。
· FPKM跨度大,用log2(FPKM+1);Cox和ROC主要用连续型expr_log2,分组用于KM曲线和分组HR。
· 如果基因名找不到,先查别名或Ensembl ID。
· 少数基因名可能对应多行注释,先用table(expr$Gene_Name)确认目标基因只有一行;多行时取均值或最长转录本。
读入后先做三件事:第一,核对样本ID,确保临床表和表达矩阵的CGGA_ID能一一对应;第二,看缺失情况,尤其是OS、Censor、IDH、1p/19q、MGMT;第三,确认因子参考水平。参考水平决定HR的方向:Grade以WHO II为参照,IDH以Wildtype为参照,Codel以Non-codel为参照,Group以Low为参照。参考水平换了,HR的解释也跟着换。
统计之光提供生信分析全流程医学SCI指导:关注一点菜单栏【SCI指导】一【一对一】定制学习方案
按693队列的中位表达分组,切点为0.692,低/高表达各202例。
cutoff <-median(dat693$expr_log2, na.rm =TRUE)dat693$Group <-factor(ifelse(dat693$expr_log2 > cutoff, "High", "Low"),levels =c("Low", "High"))fit <-survfit(Surv(OS, Censor) ~ Group, data =dat693)survdiff(Surv(OS, Censor) ~ Group, data =dat693)p <-ggsurvplot(fit, data =dat693,pval =TRUE, conf.int=FALSE, risk.table =TRUE,xlab ="Time (days)", ylab ="Overall survival",legend.title ="LOX expression",palette =c("#2E86AB", "#E63946"))pdf("OS_LOX_693.pdf", width =7, height =6)print(p)dev.off()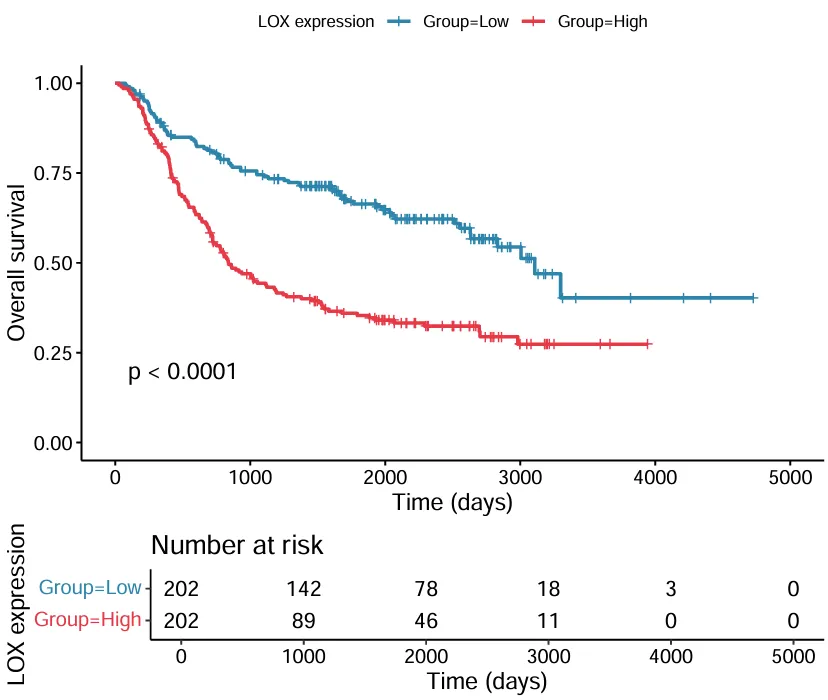
isk.table=TRUE会给出每个时间点的风险人数。中位数分组简单、可复现,但不是最优切点。KM曲线看的是随时间累积的生存概率,log-rank检验比较整条曲线,不是某一个时间点。中位生存时间指生存概率降到50%的时间;如果曲线一直高于50%,中位OS会显示NA,这时应报告5年生存率而不是中位OS。风险表要一起看,随访后期风险人数很少时,曲线尾部的波动不可靠。
单因素Cox一次看一个变量,输出HR和95%CI。因子变量会按参考水平展开,例如Grade以WHO II为参照。
vars<-c("Age", "Gender", "Grade", "IDH", "Codel", "MGMT", "RT", "Chemo", "Group")uni <-bind_rows(lapply(vars, function(v) { fit <-coxph(as.formula(paste0("Surv(OS, Censor) ~ ", v)), data =dat693)tidy(fit, exponentiate =TRUE, conf.int=TRUE) %>%mutate(Variable =v, n =fit$n) }))write.csv(uni, "univariate_cox_693.csv", row.names =FALSE)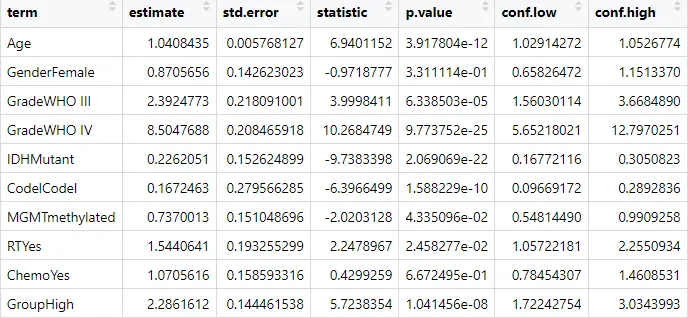
HR=1表示无差异;HR>1表示风险升高,HR<1表示风险降低。95%CI不跨1,通常对应P<0.05。连续变量Age的HR是“每增加1岁”的风险比,不是每增加10岁;如果要按10岁报告,先把Age除以10,或写清单位。分类变量的HR是相对于参考水平,例如Grade IV vs II的HR 8.50,不能解释为“Grade IV比Grade III高8.5倍”。
这些是单因素结果,没有校正混杂,HR不能直接理解为独立效应。要回答“独立预后价值”,需要多因素模型,并检查比例风险假定:
multi <-coxph(Surv(OS, Censor) ~ Age +Grade +IDH +Codel +MGMT +RT +Chemo +Group,data =dat693)summary(multi)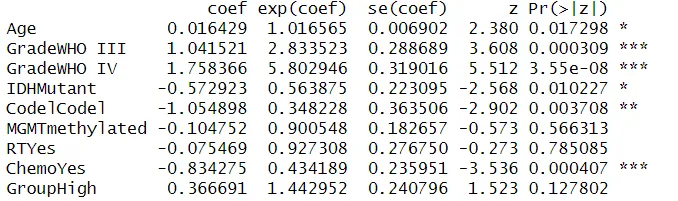
如果cox.zph的P<0.05,说明比例风险假定不成立,可考虑分层Cox或时间依存协变量,不要硬解释。
生存数据有删失,普通ROC不适用,要用时间依赖ROC。timeROC的marker是连续型表达量,times按天设置。
oc <-timeROC(T =dat693$OS, delta =dat693$Censor,marker =dat693$expr_log2,cause =1, weighting ="marginal",times =c(365, 1095, 1825), iid =TRUE)pdf("ROC_LOX_693.pdf", width =5, height =5)plot(roc, time =365, col ="#E63946", title =FALSE, lwd =2)plot(roc, time =1095, col ="#2E86AB", add =TRUE, lwd =2)plot(roc, time =1825, col ="#F4A261", add =TRUE, lwd =2)legend("bottomright",legend =paste0(c("1-year", "3-year", "5-year"), " AUC=",sprintf("%.3f", roc$AUC)),col =c("#E63946", "#2E86AB", "#F4A261"), lwd =2, bty ="n")dev.off()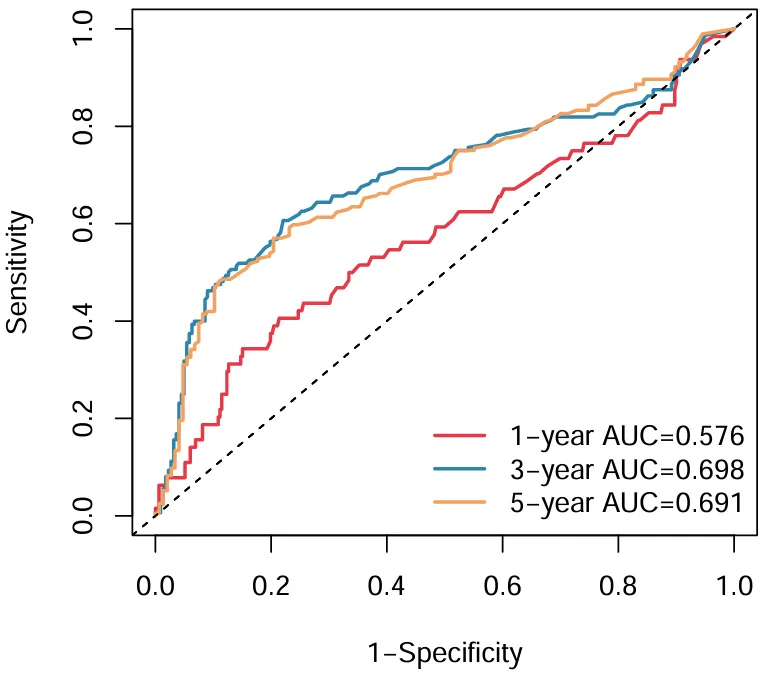
普通ROC把“是否事件”当成二分类,但生存数据里有人随访结束时仍未发生事件,直接丢掉这些样本会偏倚,将其当做阴性也会偏倚。时间依赖ROC在每个时间点重新定义“到该时间点是否发生事件”,并利用删失前的信息,所以更适合生存数据。
本文的Censor是0/1,timeROC对象里AUC字段叫AUC;如果终点含竞争风险,字段名会变成AUC_1。示例AUC:1年0.576、3年0.698、5年0.691。AUC只反映区分度,0.5相当于随机,0.7左右可接受,0.8以上较好;它不代表校准,也不代表临床净获益。单基因、未校正的AUC通常不会很高,这是正常的。如果AUC低于0.5,先检查marker方向,不要急着换基因。1年、3年、5年的选择要跟临床问题一致;如果随访不足5年,5年AUC不稳定。
1.两套RNA-seq平台不同,合并前做批次评估;用ComBat时保留批次协变量,不能把批次和分组完全混在一起。
2.原发和复发不要混。复发是另一个研究问题,混在一起做生存分析会引入混杂。
3.缺失值要报告。693中IDH缺51例、1p/19q缺70例、MGMT缺151例;单因素模型各自删除缺失,n不同,不能只写“n=693”。
4.WHO版本要写清。主队列按2007/2016版注释,做2021版整合诊断要自己用IDH、1p/19q和组织学换算;IDH和1p/19q是推断结果,不是FISH。
5.切点要在训练集定,验证集固定。不要在全队列找最优切点,再用同一批数据检验。
6.多重检验要控制。不要筛几千个基因后只报最小的P;预设定假设,或做FDR校正。
另外两点:Cox模型要检查cox.zph;ROC的AUC不是临床效用,真要谈临床价值,还需要校准曲线和决策曲线分析。代码复现方面,论文里写清下载日期、数据版本、R包版本,并把sessionInfo()放进补充材料。
这套流程可以复用到其他基因或者生存终点:版本配对→清洗→训练集定切点→OS/Cox/ROC。数据库分析只能提出假设;要下生物学结论,还需要实验验证和前瞻性队列。
想做生信发文却无从下手?数据分析卡壳没人带?别焦虑!统计之光提供生信分析一对一全流程教学。从思路构建到代码实操,手把手教你跑通全流程,让发文章不再是难题!
生信发表案例展示
生信分析一对一全流程:选题沟通→数据挖掘/准备→数据清洗→统计分析→写作指导→初稿批注→语言服务→投稿指导→返修指导📚
零基础友好,有基础也能进阶高阶实战,全程收获量身匹配的成长!
统计之光提供生信分析全流程医学SCI指导:关注一点菜单栏【SCI指导】一【一对一】定制学习方案
往期精彩
1
2
3

