企业自建本地大模型:下载免费,活着最贵
- 2026-10-29 01:36:30
很多企业算自建大模型的账,只算了“买卡的钱”。真正的大头,在模型跑起来之后。
这两年,不少企业启动本地大模型项目时,都有一个相似的起点:模型可以免费下载,GPU 买回来就能跑,似乎比按 token 付费的云 API 更“可控”。
这个判断只对了一半。下载是免费的,让模型持续活着、不落后、不出事,才是最贵的部分。自建本地大模型不是一次性采购,而是一项持续运营。很多预算表在“建”这一栏做得很认真,却在“运”这一栏留了空白。
一、硬件只是入场券,运营才是主账单
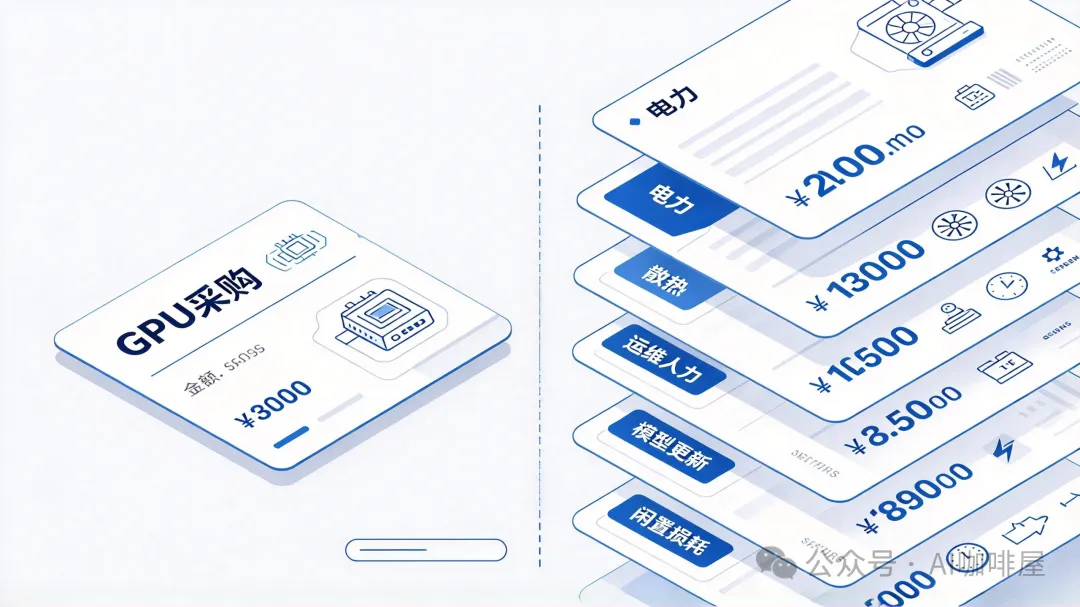
自建本地大模型最普遍的误判,是把 GPU 采购当成主要成本。
Gartner 2025 年的一份报告指出,企业自建大模型推理环境的 TCO 中,硬件只占 42%,剩下的是运维、电力和闲置损耗。一项覆盖 47 个企业开源 AI 部署的研究发现,组织对真实成本的低估幅度达到 3.4 到 5.8 倍;部署时间从计划的 6 个月拉长到 14–22 个月;进入运营阶段后,团队规模需要增加到初始部署的 2–3 倍。
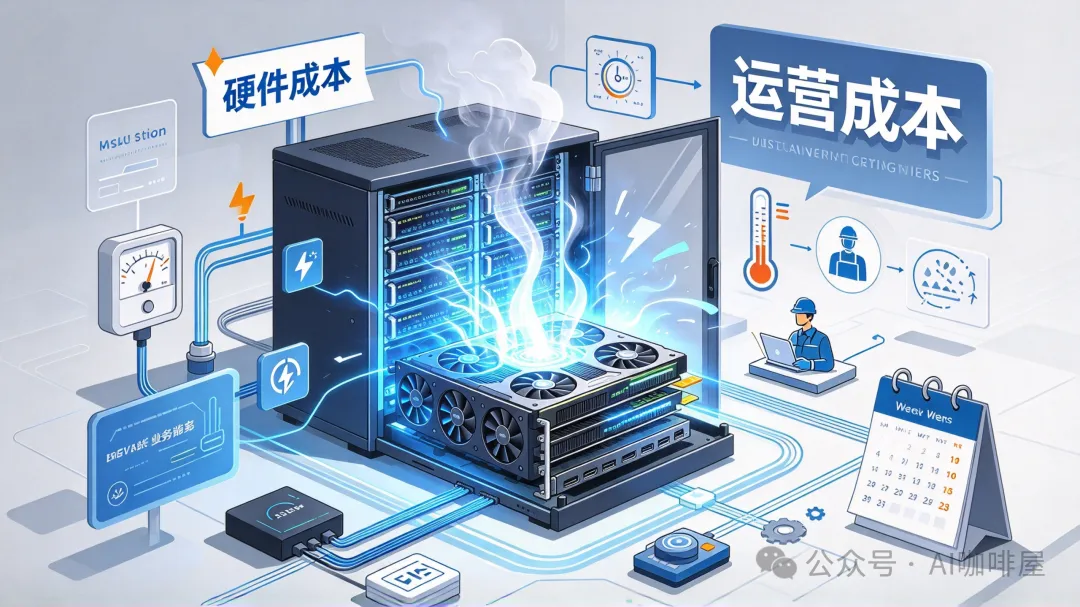
具体的隐性成本清单会让人清醒:一台满载的 8 卡 GPU 服务器功耗轻松突破10kW,而传统企业机房的单机柜供电通常只有 3–5kW,机房改造甚至液冷系统是绕不开的前置条件。再加上年度电力、散热、专职 MLOps 工程师,以及驱动更新、安全补丁、硬件故障处理等持续消耗,运营开销在三年内可以累积到初始部署成本的 2.3 倍。
如果预算只按“买卡的钱”来做,几乎注定会在上线后的第一到第二年面对缺口。
二、云厂商替你扛的,自建后全回到自己身上
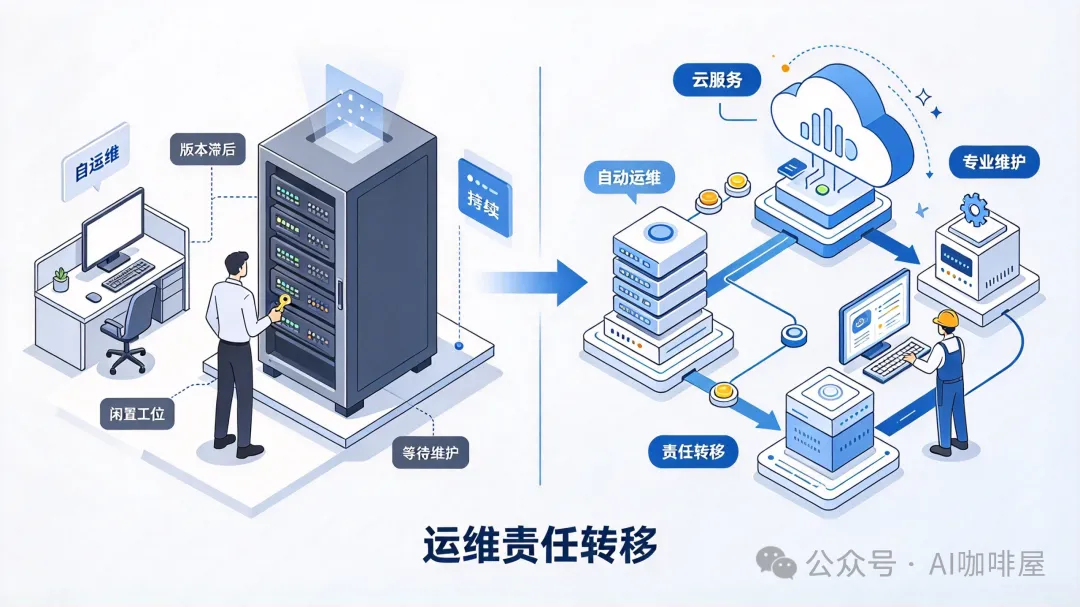
使用云 API 时,监控、模型更新、安全漏洞响应、故障切换,主要由服务商承担。一旦转为本地部署,这些责任原封不动地转移回企业自己身上。
这种责任转移带来的后果,往往不是技术故障,而是组织能力的真空。
一个典型而普遍的失败路径是:引入时依赖一位“懂 AI 的能人”完成搭建,运维也集中在同一个人身上,缺乏文档和备份机制;这个人一旦离职或转岗,系统就进入无人更新的状态——模型停留在旧版本,安全补丁缺失,最终无人使用。
行业数据也印证了这一结构性风险:AI 项目 70–85% 的失败,首要原因不是开发阶段,而是部署之后失控的运营成本与运维负担;高达 73% 的企业 AI 部署失败,是因为标准可观测性工具无法追踪模型漂移、GPU 利用率或多模型编排。自建本地大模型,等于主动把最难的这部分留给了自己。
另一个常被忽略的信号是闲置。VentureBeat Intelligence 的调研显示,79% 的企业 GPU 算力至少有一半时间完全闲置,且这一比例在三个月内稳定在 77%–81% 的高位。硬件买回来了,却没有持续跑满,固定成本照样发生。
三、最贵的不是电费,是“只有一个人会”
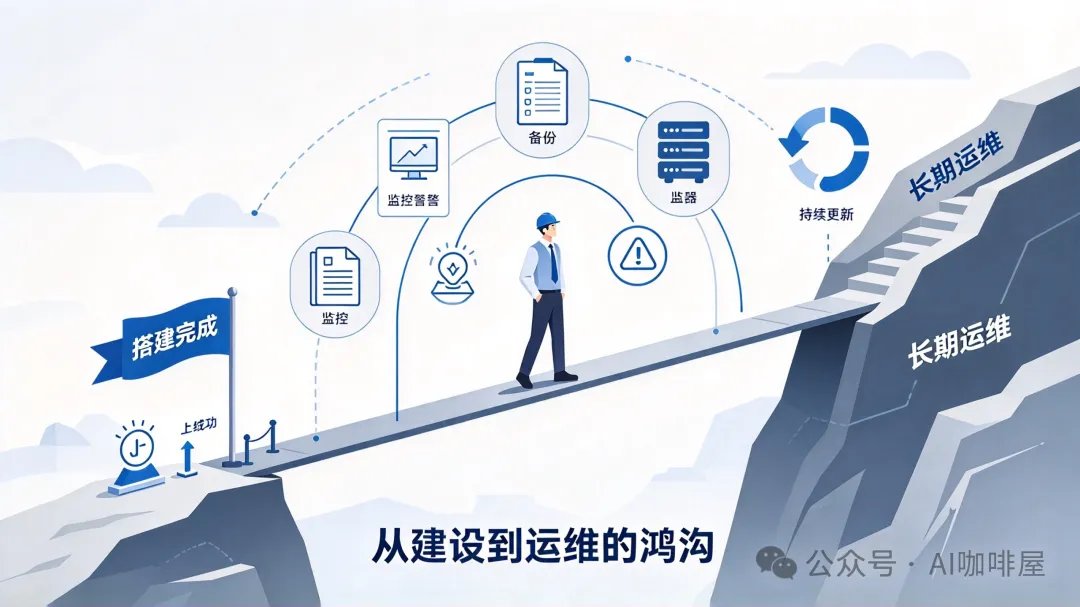
自建本地大模型的风险清单里,电费和硬件故障是显性的,真正隐蔽的是属人化。
一个能搭起环境的人,不等于一个能长期运维的团队。模型版本要跟进,推理性能要压测,安全补丁要评估,合规审计要留痕,故障要能回滚。这些动作需要的是 MLOps、GPU 调度、Kubernetes 集群管理、模型性能监测与漂移检测等能力的组合,与传统 IT 运维的技能边界几乎不重叠。精通这些领域的人才本就有限,企业很难组建并留住一个完整团队。
有案例显示,某头部券商耗时 8 个月、投入超 300 万元的私有化项目,推理延迟从 POC 阶段的 800ms 飙升至生产环境的 4.2 秒,被迫暂停全量上线。大模型一体机市场也有类似观察:部分厂商重硬件交付、轻后续运维,设备交付后缺少模型持续更新服务,“硬件到位,业务却跑不起来”,满血版一体机普遍要 120 万到 150 万元。
这些问题的共同点不是“技术选错了”,而是把“能建”当成了“能运维”。
四、自建不是不能做,但要同时满足三个条件
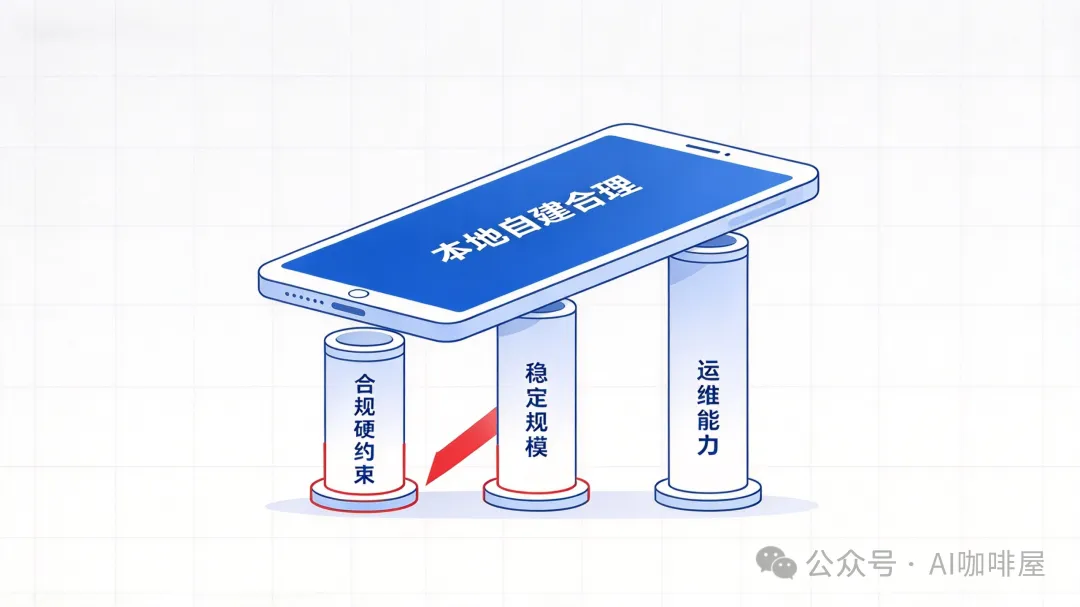
自建本地大模型并非一律不合理,但它成立的条件比大多数企业意识到的更苛刻,通常需要同时满足以下三项,而不是只满足一条:
第一,合规是硬约束,而非偏好。数据完全不能离开内网,例如受特定监管约束的金融核心数据、部分医疗数据,或涉及敏感个人信息的场景。在这种情况下,成本比较让位于合规底线。
第二,用量达到可观且稳定的规模。研究分析显示,与商业 API 的盈亏平衡点大致在每天 200 万–300 万 tokens 的稳定推理量,且前提是 GPU 利用率维持在较高水平;也有研究指出,开源模型只有在日推理量超过 5000 万 tokens 时,才可能在成本上与商业 API 持平。用量波动大或长期偏低时,云 API 的按量计费反而更经济。
第三,已有 GPU 基础设施和运维团队。已经在运行 GPU 工作负载的企业,增量部署大模型的边际成本显著低于从零起步;完全没有相关积累的企业,同时补齐硬件、机房、MLOps 人力的总投入,往往超出自建所能带来的收益。
三者缺位时,自建往往不是一条更可控的路,而是一条把云厂商替你承担的风险重新收回自己手里、并且用更高成本去承接的路。
写在最后
自建本地大模型真正合理的判断框架,不是“我们能不能买得起 GPU”,而是:
合规是否真的要求数据必须在内网、稳定用量是否足以摊薄固定成本、组织是否已经具备承接长期 GPU 运维和模型更新的持续能力。
下载模型不要钱。让它持续活着、不落后、不出事,才是最贵的部分。把“运”的账算进去,自建的范围自然会收窄到它真正应该覆盖的那一层。
数据来源:Gartner 2025 年报告;47 个企业开源 AI 部署研究;VentureBeat Intelligence 调研;公开行业案例。

