附件版本一致性测试:串起上传、预览与下载的验证链路
- 2026-10-04 12:57:45
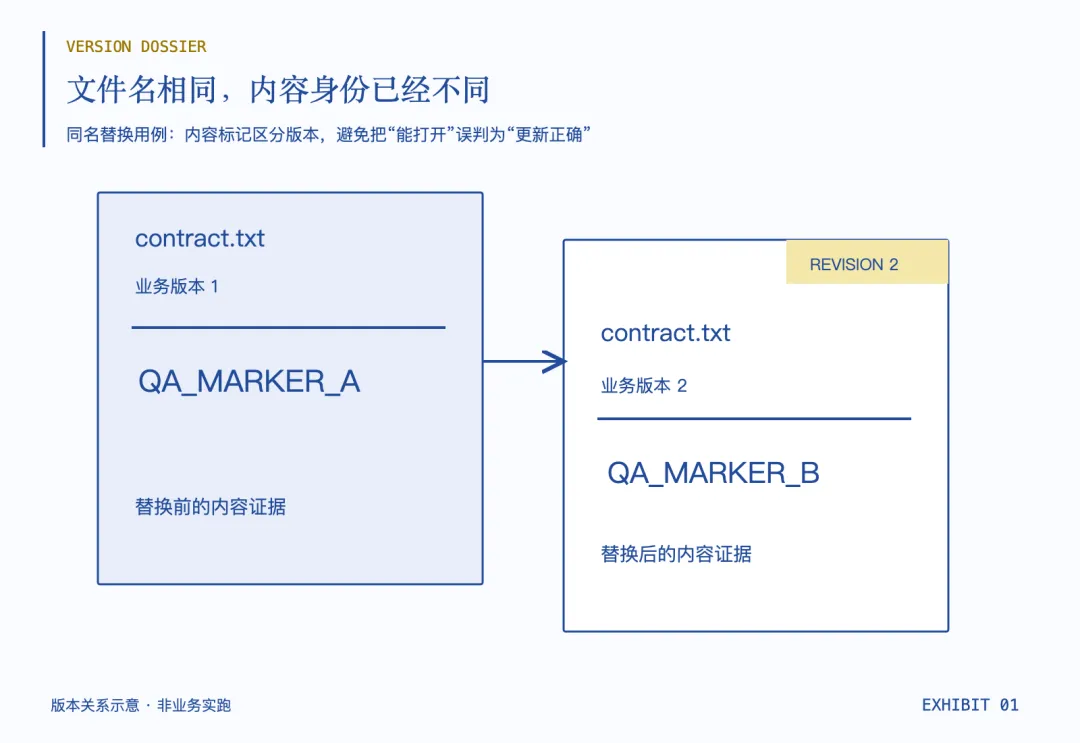
同事上传了一份新合同,页面上的文件名没有变化。预览能打开,下载也成功,于是附件替换的用例通过了。
直到业务人员发现:预览里还是旧条款,下载下来的却是新合同。
这类问题在合同、简历、报表、审批材料里都可能出现。单看“上传成功”“预览成功”“下载成功”,三个步骤都没错,组合起来却把两个版本伪装成了一份文件。
QA 不只是要测文件能不能打开,而是要测:当前记录、原文件、预览产物和下载结果,是否指向同一个业务版本。
下面是一套教学用的验证路径。没有连接你的业务系统,也没有声称某个产品存在这些缺陷。
不要先清缓存,先让两个版本无法混淆
准备两个同名文件,是有意保留真实风险,而不是测试数据管理失误。
第一个 contract.txt 内容是 QA_MARKER_A,第二个同名文件内容是 QA_MARKER_B。测试时先上传 A,再通过产品提供的替换操作上传 B。
一个不够好的候选用例会检查文件名仍是 contract.txt,预览区域可见,下载事件触发。它根本不能区分 A 和 B。
QA 修订后的要求应该是:替换完成后,预览明确属于 B;下载原件的内容属于 B;如果预览仍在转换,页面不能把未标识的 A 当作当前预览展示。
文件名和下载 URL 都不适合充当版本证据。同名可能是正常业务;URL 改了不代表内容更新;URL 不变也不一定代表内容没更新。
还有一个边界:预览经转码后,字节哈希通常不应与原件相等。 原件下载可以按“原样返回”的产品契约比较 SHA-256;PDF 转图片、Office 转 PDF 等预览,应比对内容标记和来源版本,不能用错误的哈希断言把合法转换判成失败。
具体怎么使用 Playwright 验证替换链路
优先用团队现有的浏览器自动化环境。准备一个独立测试记录、允许上传和替换的测试账号,以及不会涉及真实客户材料的文件。
下面的模板要求产品支持 TXT 上传和文本预览。如果只支持 PDF,就准备两个有不同可见标记、同名的合规测试 PDF,并把预览断言改成产品实际可观察的内容或来源版本。不要假设 PDF 内嵌查看器一定能用普通 DOM 文本定位。
先创建教学文件:
mkdir -p fixtures/v1 fixtures/v2printf'QA_MARKER_A\n' > fixtures/v1/contract.txtprintf'QA_MARKER_B\n' > fixtures/v2/contract.txt将以下用例放进现有测试项目。它假设上传选择后立即提交;如果产品还有“保存”按钮,需要补上真实保存动作和完成条件。上传附件、替换附件应映射到 file input 的标签,而不是随便一个外观相似的按钮。
import { test, expect } from'@playwright/test';import { readFile } from'node:fs/promises';import { createHash } from'node:crypto';consthash = (data: Buffer) =>createHash('sha256').update(data).digest('hex');test('替换后预览与下载属于新附件', async ({ page }, testInfo) => {const url = process.env.QA_ATTACHMENT_PAGE;if (!url) thrownewError('需要独立测试记录的 QA_ATTACHMENT_PAGE');await page.goto(url);await page.getByLabel('上传附件', { exact: true }) .setInputFiles('fixtures/v1/contract.txt');awaitexpect(page.getByTestId('attachment-name')) .toHaveText('contract.txt');awaitexpect(page.getByTestId('preview-content')) .toContainText('QA_MARKER_A');await page.getByLabel('替换附件', { exact: true }) .setInputFiles('fixtures/v2/contract.txt');awaitexpect(page.getByTestId('preview-content')) .toContainText('QA_MARKER_B');awaitexpect(page.getByTestId('preview-content')) .not.toContainText('QA_MARKER_A');const pending = page.waitForEvent('download');await page.getByRole('button', { name: '下载原件', exact: true }).click();const download = await pending;expect(await download.failure()).toBeNull();const target = testInfo.outputPath('downloaded-contract.txt');await download.saveAs(target);const uploaded = awaitreadFile('fixtures/v2/contract.txt');const received = awaitreadFile(target);expect(hash(received)).toBe(hash(uploaded));});执行时显式指定测试记录:
QA_ATTACHMENT_PAGE='https://your-test-host/your-isolated-record' \npx playwright test tests/attachment-version.spec.ts \ --project=chromium --workers=1 --retries=0 --trace=on这个地址是占位符,需要换成你有权限的测试环境。登录态、baseURL 和 chromium 项目沿用原配置。模板遇到预览断言失败会停止,不会继续采集下载结果;要形成“预览 A、下载 B”的完整现场,应在不改变附件状态的前提下另行补采下载证据,不能认为一次失败运行已经自动拿到了两侧材料。执行会改变该测试记录的附件,结束后按团队现有的数据清理流程处理,不要猜一个删除接口自动调用。
上传方法见Playwright 文件上传文档,下载监听与保存见下载文档。上面的 file input 操作只覆盖浏览器上传链路,不证明手机相册选择器、小程序宿主选择面板也测过了。
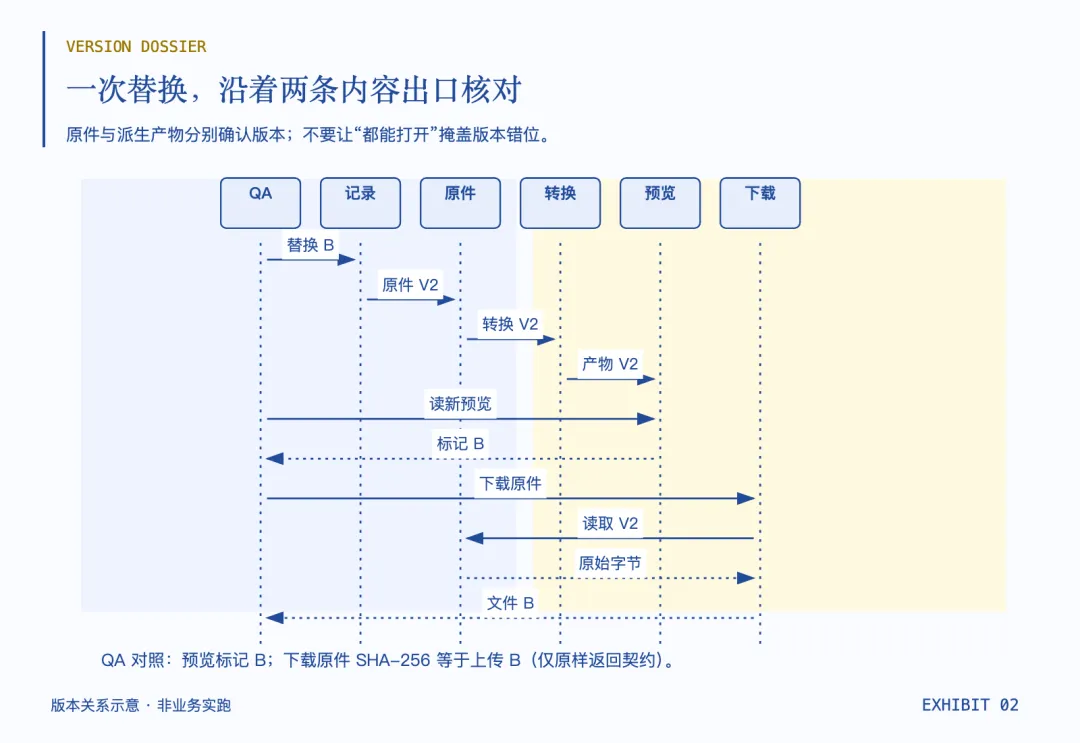
一次失败,应该沿着哪个版本继续查
假设用例发现预览是 A、下载是 B。不要马上让 AI 生成“清缓存重试”的操作。
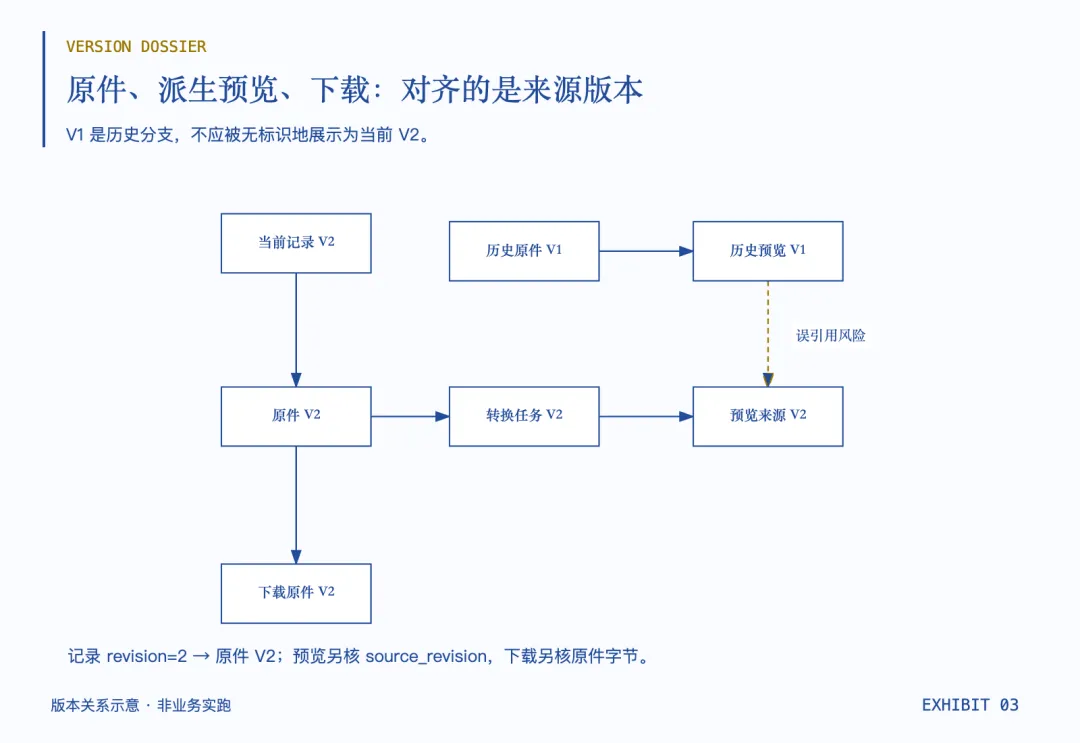
先收集当前记录的 attachment_id、业务 revision、原对象标识、预览任务的 source_revision,以及下载实际解析到的对象标识。字段名因系统而异;拿不到就记录缺失,不要根据文件名补出来。
教学反例可以这样理解:当前记录已经指向 revision 2,下载原件确实来自 revision 2,但预览产物的来源仍是 revision 1。这时已经能确定“不一致”,还不能确定“CDN 有问题”。
可能是新转换任务没有创建,也可能任务完成了但页面仍引用旧产物,还可能原始预览引用正确而缓存响应过期。下一步应根据手上证据区分这些分支,而不是把所有问题都叫缓存。
给 Copilot Agent 的任务可以限定为:
目标:找出当前附件、预览与下载第一次出现版本不一致的位置。输入:脱敏后的记录信息、替换请求、预览任务信息、下载证据。先列事实与缺口,再选择一项最有区分度的只读查询。每个版本判断都要引用字段或内容标记。不得清缓存、重传文件、重新生成预览或修改数据库。证据不足时输出“无法区分的候选原因”和所需证据。最终生成缺陷草稿,不能自动宣称根因已确认。这里 AI 负责连接跨服务线索、选择下一条调查动作、更新假设;QA 负责确认版本契约、允许的转换过程和业务影响。工具调用应限制在已授权的只读接口,审批设置与敏感材料脱敏不能靠一句提示词代替。
“最终能更新”还不够,中间态也要有解释
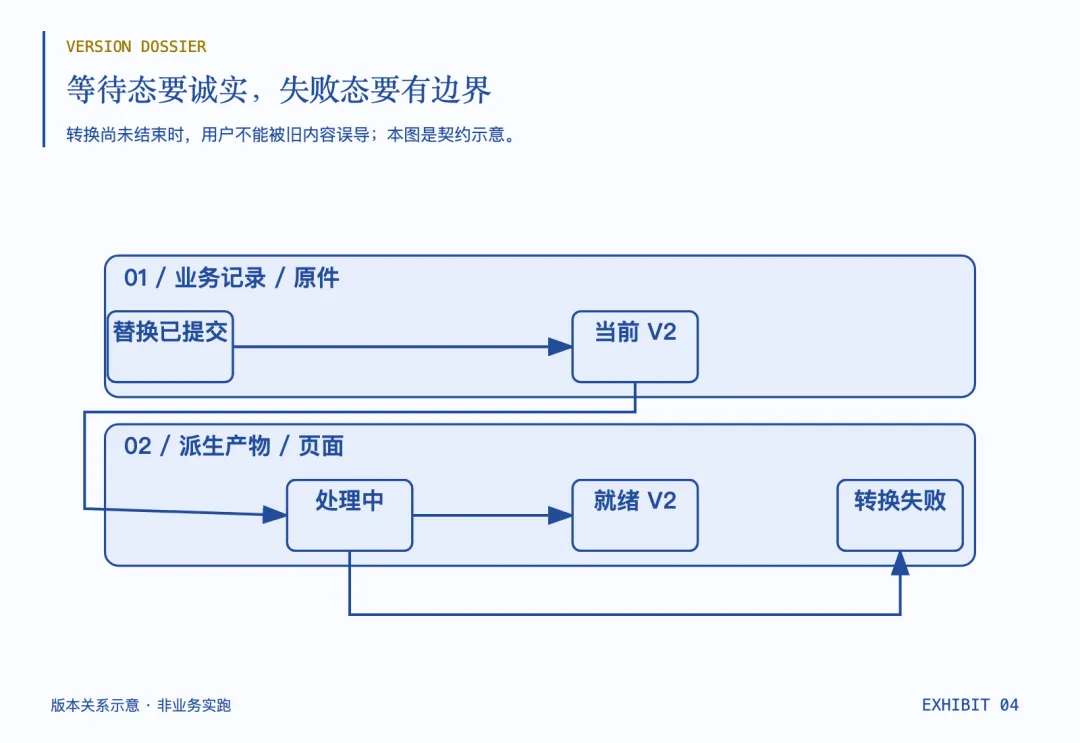
上面的自动化模板只检查最终就绪结果,不覆盖整个转换等待过程。它不能证明“没有短暂展示旧版本”。
如果产品允许异步转换,QA 还要和产品明确:等待期间显示“处理中”,还是展示带明确旧版本标签的历史预览?替换失败后如何恢复?新预览生成失败时,下载原件是否仍应返回新文件?
测试环境如果有经过授权的转换暂停或延迟钩子,可以把系统停在等待态,检查页面表达后再放行。没有这种能力,可以先记录人工观察和真实任务时序,但不能据此声称已经穷尽中间态。
这是另一个不应交给 AI 自行决定的业务契约。它不能为了让页面看起来可用,就建议一直展示旧预览;也不能不问产品就要求一律隐藏历史版本。
清缓存可以作为诊断动作,但必须在保存现场之后。清完恢复,只能说明“改变缓存条件后现象消失”,不等于已经证明唯一根因,更不等于所有用户都不会再遇到。
三种接入深度,按现有能力选
只有页面权限时,先用内容标记验证预览和原件,提交“可确认的不一致”和时间范围。这已经比“附件打不开”更可复现,不必等待完整可观测平台。
有测试环境只读查询权限时,再补齐记录版本、转换任务来源与下载对象,把责任边界缩小。字段必须来源于真实接口或存储契约,不要让 AI 生成看似合理的数据库表名。
系统已有版本链路日志时,把 Agent 接在授权查询工具之后,让它按证据选择下一跳。最终产物仍是待审核的诊断报告,不是自动重建文件、覆盖附件或删除历史记录。
第一条最小用例在环境、账号和定位器齐全后可以安排二三十分钟试跑。这是实施建议,不是本文已经验证的耗时或提效比例。
最后交付的不是一张成功截图
一份可行动的缺陷记录应说明:哪个业务记录、替换前后内容标记、当前 revision、预览来源、下载来源、观察时间,以及哪些链路尚未拿到证据。
如果系统承诺下载的是原件,附上本地输入与下载文件的哈希;如果下载会加水印或转格式,就改用相应契约,不能继续要求字节完全相等。
还要写清是“预览最终错误”“等待期间误导用户”,还是“下载指向旧版本”。这三种问题的修复点与风险不一样。
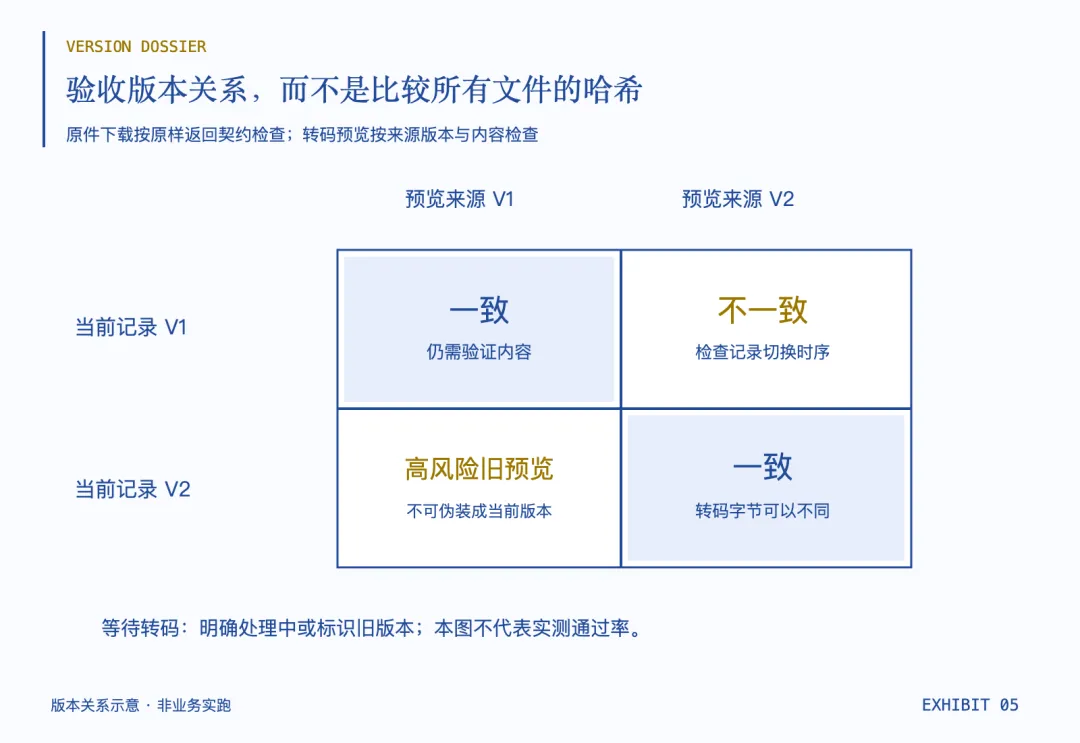
本文的浏览器示例使用 TypeScript 和 Node.js 内置哈希能力;服务端是 Java、Go 或 Python,都不要求迁移语言。已有 Java 测试体系可以用对应 Playwright 绑定与标准摘要库,保留“版本关系”这一判断标准即可。
真正需要升级的,不是上传脚本有多少行,而是验收对象:从“几个入口分别可用”,变成“用户看到、下载和操作的,确实是同一版材料”。AI 应该帮助 QA 把这条关系查清,而不是更快地清掉最有价值的现场。

