下载 28MB 的数据库客户端,能连 100+ 种库:dbx 实测
- 2026-10-18 03:22:17
我数了一下自己为了「看眼数据」这件事装过多少东西。
最早用 Navicat,后来换 DBeaver,中间试过 TablePlus。DBeaver 功能是真的全,问题也真的大:一次启动要等它把 Java 运行时拉起来,内存占用跟着表越开越多,装的时候还得确认机器上有没有合适的 JRE。
需求其实很小:连上库,看一眼表,跑一条 select,把结果导出来。为了这点事背着几百兆的运行时,不划算。
dbx 打的就是这个位置。它的 README 第一句是「25 MB, zero runtime bloat」,副标题直接点名:不要 Java JRE、不要 Python venv、不要内嵌 Chromium。
01 一句话定位:它凭什么这么小
| Rust | |||
| 要 | 不要 | ||
| Apache-2.0 | |||
| 2.66 万 | |||
| 无 |
DBeaver 是 Java 写的,所以绕不开运行时;TablePlus 是原生但核心闭源、免费版有连接数限制;dbx 是 Rust 写的单文件程序,Apache-2.0 全开源。
但「25 MB」这个数字我要修正一下,因为实测对不上。
我下载了官方 Release 里的 Windows x64 安装包 DBX_0.6.43_x64-setup.exe,实际是 28.16 MB;另一个便携版压缩包 37.2 MB,解开之后里面是一个 74.86 MB 的 DBX.exe。也就是说:
- 28MB 是安装包的下载体积
(README 里说的「约 25MB」应该是按这个口径); - 75MB 是解压后单个可执行文件的真实大小
。
这个差别值得说清楚,因为「免安装、拷走就能用」的场景下,你要拷的是 75MB 那个。不过它的核心卖点依然成立——这 75MB 里没有内嵌 Chromium,也没有 Java 运行时,全部是 Rust 编译出来的原生代码。对比一下:光是 Chromium 内核就超过 100MB,一个 JRE 也能到 40MB 以上。
装法有三条路,Windows 上最省事的是包管理器:
winget install t8y2.dbx # 或者 scoop bucket add dbx https://github.com/t8y2/scoop-bucket scoop install dbx想跑在浏览器里、或者给团队共用,也可以直接 Docker 起:
docker run -d --pull=always --name dbx -p 4224:4224 \ -v dbx-data:/app/data \ t8y2/dbx:latest官方在文档里还特别写了,国内拉镜像可以用 CNB 的地址 docker.cnb.cool/dbxio.com/dbx:latest。
02 实测:把 Web 版跑起来,建第一个连接
我这次实测的是它发布的浏览器静态版(dbx-web_0.6.43_x86_64-browser-static.zip,35.1 MB,解开是一个自带前端资源的 93.4 MB 可执行文件)。选它是因为这个版本不依赖桌面环境,能在一台没接显示器的机器上完整跑起来。
启动之后浏览器打开 http://127.0.0.1:4224,直接进主界面——左侧是连接树,右侧是仪表盘,底部标着版本号和 GitHub 入口。整个界面从加载到可用是连贯的,没有那种「先白屏再慢慢渲染」的过程。
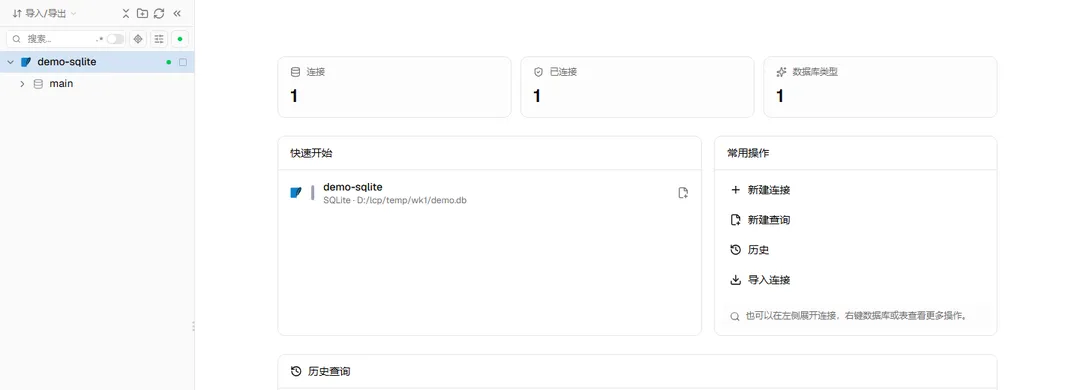
图片说明:dbx Web 版主界面,左侧连接树、右侧连接统计与快速入口。
点「新建连接」,弹出来的向导按类别分成了九组:关系型数据库、数仓分析、国产数据库、轻量数据库、文档/缓存/检索、图谱/向量、时序数据库、消息队列、注册与配置。
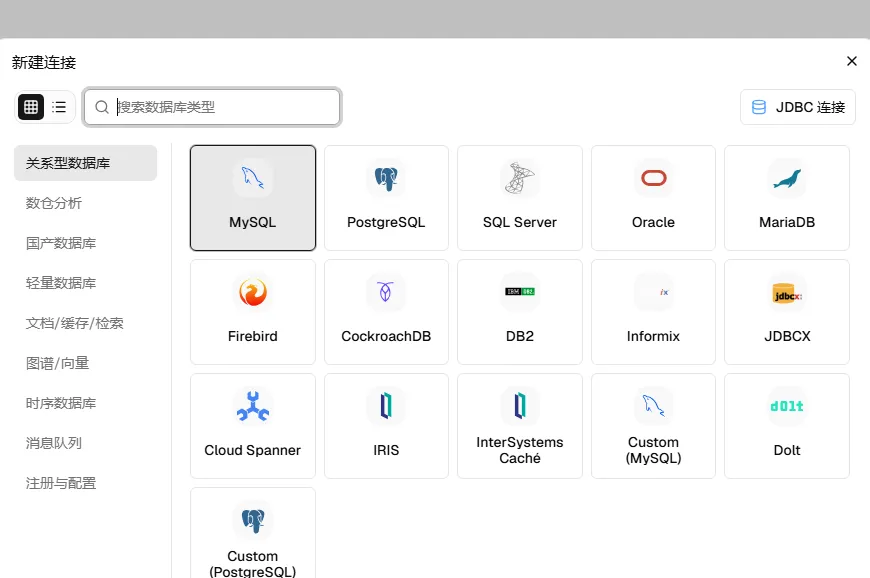
图片说明:新建连接向导的九个分类,当前展示关系型数据库分组。
这里有个我没想到的细节:国产数据库被单独拎出来做了一整个分类。达梦、金仓、瀚高、优炫、海量、金篆这些都能直接选。很多同类工具要么完全没有,要么藏在一堆「Other」里面。
搜索框里输入 sqlite,过滤出目标,下一步进表单。字段给得挺克制:URL 可以留空,主要是填「文件路径」和连接名。我填了一个自己造的测试库路径。
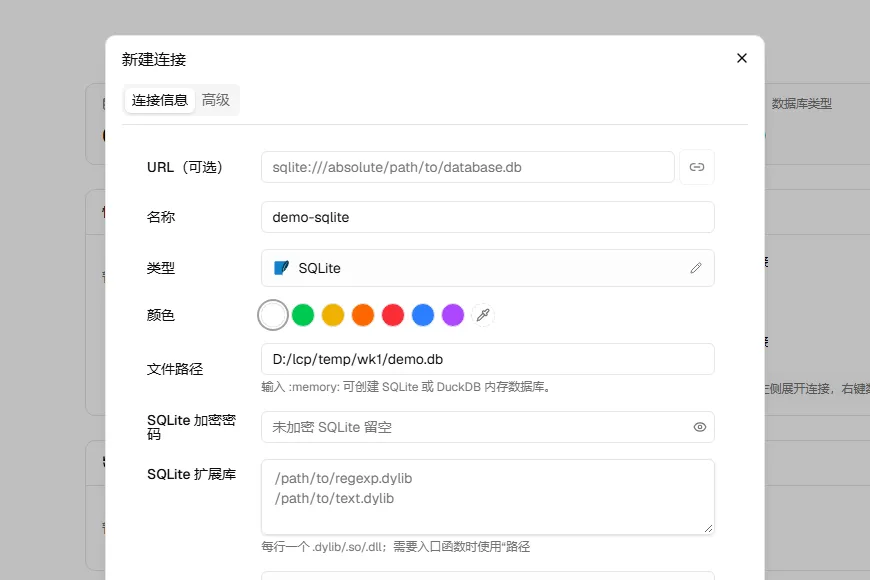
图片说明:填完 SQLite 文件路径后点「测试」,左下角出现「连接成功」,数据库信息栏同步变为「已测试 SQLite」。
点「测试」那一刻返回了「连接成功」。这个反馈设计比「点了没反应、只能直接保存试」要好——错了当场知道,不用等到保存之后才发现是路径打错了。
03 实测:跑第一条真实 SQL
连接建好,会出现在左侧树里,展开能看到 main 库。点顶部「新建查询」开一个查询页签,写 SQL 执行。
我用的是一条带连表聚合的语句:
select c.name as customer, c.city, count(o.id) as orders, round(sum(o.amount), 2) as total from customers c left join orders o on o.customer_id = c.id group by c.name, c.city order by total desc;执行之后底部状态栏显示:共 4 行(总计 4 行),9 ms。
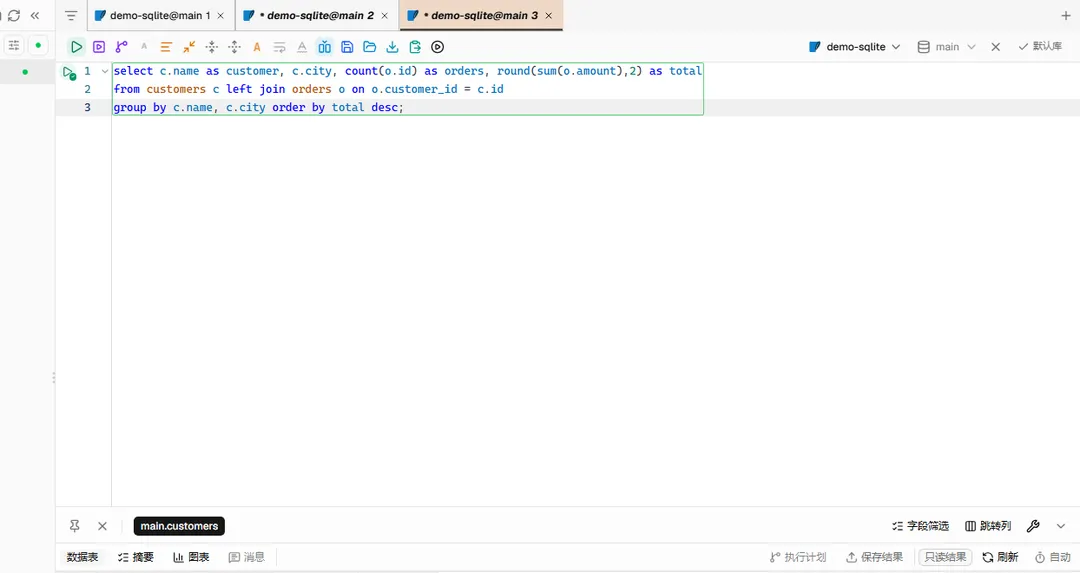
图片说明:连表聚合查询的执行结果,状态栏显示共 4 行、耗时 9 ms。
这个结果页值得单独说几点。
第一,数据表的质感是够的。列头带排序箭头,行号在左侧,数值列右对齐,小数位没有变成一长串浮点尾巴。这些都是小事,但恰恰是「能不能日常用」和「只能偶尔看一眼」的分界线。
第二,SQL 预览功能在。结果区上方有一排按钮:数据表 / 摘要 / 图表 / 消息,右边还有「执行计划」「保存结果」「只读结果」「刷新」。「只读结果」这个开关很实用——查线上库时把结果集锁住,避免手滑改到数据。
第三,它的编辑器是 CodeMirror 6,带元数据感知的自动补全。对几十张表以上的库,补全的价值比什么都大。
04 实测:命令行里复用同一个连接
dbx 还有一个独立发布的 Rust 写的 CLI(dbx-cli-win32-x64.zip,里面一个 29.63 MB 的 dbx.exe),版本号走的是另一条线——当前是 0.4.118。
有意思的地方在于:CLI 读的就是 Web 端建好的那份连接配置,不需要重新配一遍。
$ dbx.exe --version 0.4.118 $ dbx.exe connections list --json { "connections": [ { "name": "demo-sqlite", "type": "sqlite", "host": "D:/lcp/temp/wk1/demo.db", "port": 0 } ] }接着直接在终端里查:
$ dbx.exe query demo-sqlite --json \ "select c.city, count(o.id) n, round(sum(o.amount),2) amt from customers c left join orders o on o.customer_id=c.id group by c.city order by amt desc"返回结构化的 JSON,带 columns、rows、row_count,能直接喂给脚本。它还提供 dbx schema describe 看单表结构、dbx context 拉一张表的完整上下文、dbx dbml 把整个库导成 DBML 建模语法:
$ dbx.exe dbml demo-sqlite Table customers { id INTEGER [pk] name TEXT city TEXT tier TEXT joined TEXT }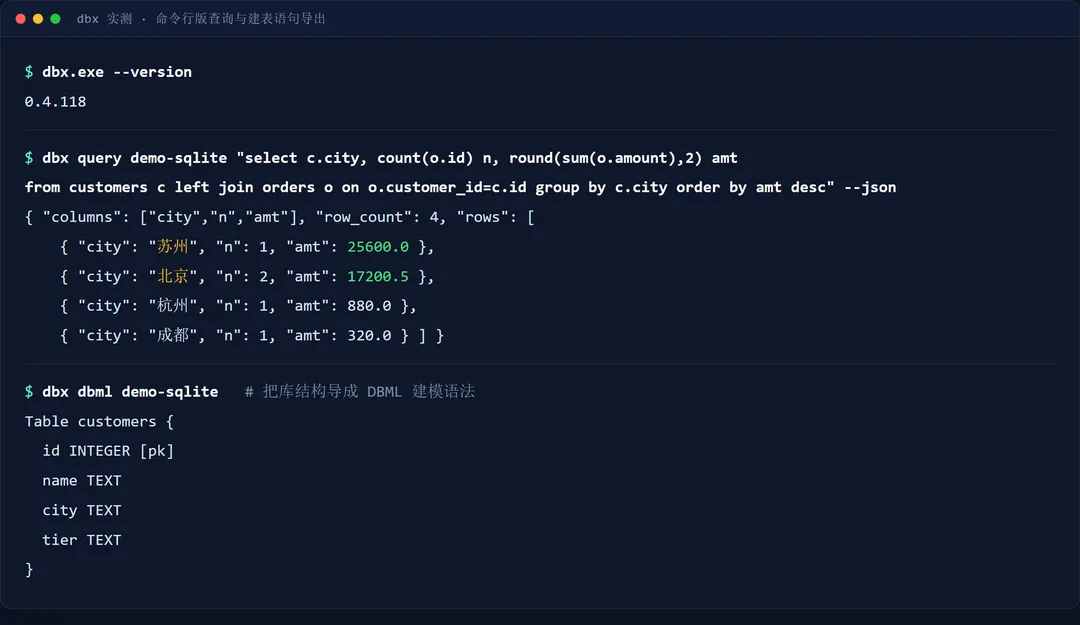
图片说明:CLI 实测输出,查询返回 JSON、dbml 命令导出库结构。
导 DBML 的时候它顺手提示了两条警告,说 SQLite 不支持表和列注释、也不上报外键元数据,所以关系和描述都推不出来。这种「做不到就说做不到」的提示,比默默出一份缺斤少两的结果强。
最后一项,也是它最特别的功能:内置 MCP Server。加一段配置,Claude Code、Cursor、Windsurf 这类 AI 编程助手就能直接查你配好的数据库:
{ "mcpServers": { "dbx": { "command": "npx", "args": ["-y", "@dbx-app/mcp-server"] } } }权限在 DBX 设置里分三档:只读、数据读写、完全访问。这个设计挺清醒——让 AI 摸数据库本身就危险,默认给只读、往上放权要手动操作,比"一次授权全部打开"稳妥得多。
05 数一下它到底支持多少种库
「100+ 数据库」这个宣传语,我用 CLI 自己去数了一遍。
$ dbx.exe capabilities --json { "directQueryTypes": [ ... ], # 10 个 "bridgeRequiredTypes": [ ... ] # 59 个 }- 直连不依赖额外驱动的 10 种
:PostgreSQL、Redshift、MySQL、Doris、StarRocks、Manticore、SQLite、rQLite、KWDB、QuestDB; - 需要通过桥接层连的 59 种
:Redis、MongoDB、ClickHouse、SQL Server、Oracle、达梦、金仓、瀚高、OceanBase、TiDB、TDengine、Snowflake、DB2、SAP HANA、Teradata、Neo4j…… 两边加起来,命令行能认的库类型是 69 种。
再从图形界面看一次。顶部「驱动管理」里有一排可安装驱动,右上角写着「全部 56 / 已安装 0 / 未安装 56」,每个驱动标了版本号和体积——达梦 2.3MB、金仓 1.8MB、Databricks SQL 32.9MB、SAP HANA 2.0MB。
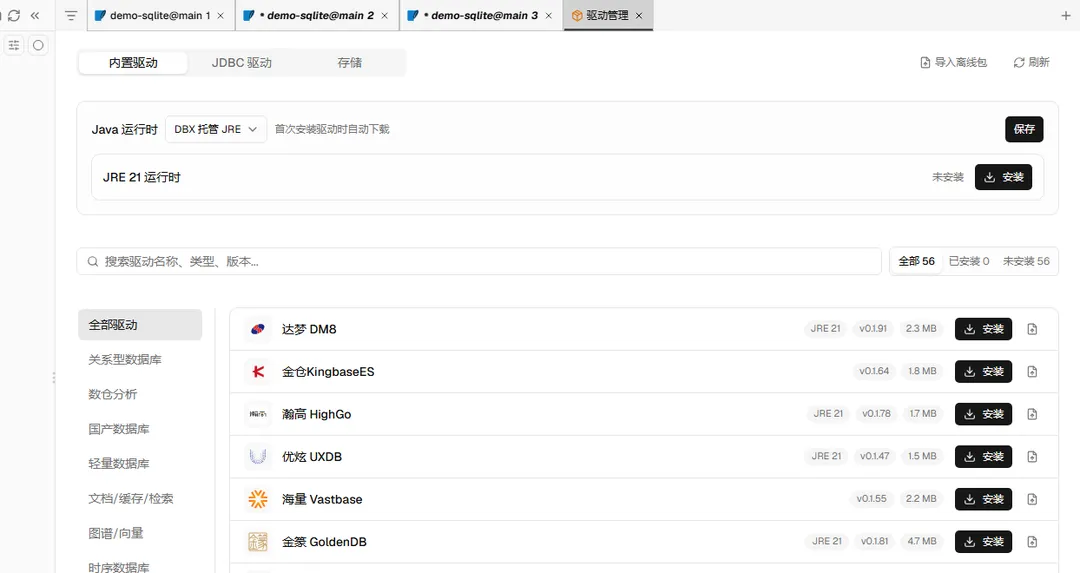
图片说明:驱动管理页显示 56 个可安装驱动,含达梦、金仓、瀚高、Databricks、SAP HANA 等,并列出 Java 运行时安装入口。
所以关于「100+」这个说法,我的核对结论是:
- 能在界面里直接选到的库类型
:连接向导九大分类 + 56 个可安装驱动; - 命令行明确列出的
:69 种; - 两者都不是「100+」的直接证据
。README 里那句「100+ databases」应该把 agent-based 的 JDBC 通用连接、以及一些实验性驱动都算进去了。
这不是造谣,但也别按字面理解成「一百多个都能开箱即用」。真正开箱即用的是直连那 10 种;需要额外装驱动的要联网下载;需要桥接的得先跑一个 sidecar 进程。
顺带说一个值得注意的点:那个驱动管理页上,有一半驱动带「JRE 21」标记,页面顶部还提示「首次安装驱动时自动下载 JRE 21 运行时」。也就是说——dbx 主程序不要 Java,但连某些库(达梦、金仓、OceanBase 这类)时,它会自己去拉一个 JRE。
「不要 JRE」的准确含义是:你不用预装。但用到需要 JDBC 的库时,运行时还是会被下到本地。这一点在宣传语里是看不出来的,但它对「能不能在完全离线的内网里用」影响很大。
06 什么时候别用它
按严重度排。
第一,项目还很年轻,版本号在 0.6。 主程序当前 v0.6.43,而 CLI 走的是完全独立的版本线 0.4.118。两条线分别更新,插件系统、MCP 协议也都在演进。如果你的团队需要长期稳定的工具链,先评估再上。
第二,部分能力依赖联网。 像上面说的 JRE 21 自动下载、驱动商店、插件中心,都要联网。完全离线的生产内网环境,得先把依赖备齐,不然会卡在「连不上、驱动也装不上」。
第三,JDBC 之外的深度特性差异大。 直连的 10 种库支持最完整;走桥接的 59 种里,各引擎的能力并不一致——比如文档里明确写了 SQLite 不支持表注释、不上报外键,所以 ER 图、字段血缘这些功能在 SQLite 上基本是空转。换库之前先确认你要用的那个特性在当前引擎上有没有实现。
第四,它不是运维平台。 dbx 是客户端,不做监控、不做告警、不做权限体系。团队需要的是「谁能查哪张表」这种管控时,该上的是数据平台,不是换个客户端。
第五,MCP 那条路要自己把关。 把数据库通过 MCP 暴露给 AI 助手,等于让模型能直接对生产库发语句。默认只读、需要就开、开完记得关,别图省事直接给「完全访问」。
第六,体量的心理预期要调整。 宣传的 25MB 是下载体积;便携版解压后是 74.86 MB,Web 版解压后是 93.4 MB。依然远小于带 Chromium 或 JRE 的同类方案,但不是「一个 25MB 的小文件」那么轻。
07 总结评价
推荐指数:⭐⭐⭐⭐☆(4.5/5)
扣分集中在两点:版本还在 0.x、部分能力依赖联网下载。功能完成度和「不臃肿」这条主线,在我用过的数据库客户端里是排前面的。
一句话评价:如果你想找一个不要 JRE、不塞浏览器内核、还能被 AI 编程助手直接调用的数据库客户端,dbx 是目前少有的选择——它的取舍很清楚:不要什么,比要什么更明确。
适用人群:
日常要在十几种不同数据库之间来回切的后端 / 数据开发 对客户端体积和启动速度敏感、机器配置一般的 想让 Claude Code、Cursor 直接查自己数据库的 需要在国产数据库(达梦、金仓、瀚高等)上做日常查询的
不适用人群:
需要长期稳定版本、对升级节奏有严格管控的团队 完全离线、无法下载驱动和运行时的内网环境 需要的是数据权限管控平台,而不是一个客户端的人 深度依赖某个特定数据库高级特性、且不能接受能力差异的
阅读时长约 9 分钟
资料来源:
dbx 项目仓库:https://github.com/t8y2/dbx (Apache-2.0,Rust,26,624 星 · 2026-10-14 复核) dbx Release / v0.6.43:https://github.com/t8y2/dbx/releases/tag/v0.6.43 dbx CLI / packages-v0.4.118:https://github.com/t8y2/dbx/releases/tag/packages-v0.4.118 对比数据:DBeaver 仓库 https://github.com/dbeaver/dbeaver (Java,Apache-2.0,52,053 星 · 2026-10-14 复核) 本文实测环境:Windows 11,实测对象为 dbx Web 版(浏览器静态包)与官方 CLI 二进制
星标数是快照值,会随项目热度变化,上表已标注复核日期。
📌 回复关键词 【dbx】,领取本文的对比清单与 Docker 部署配置模板。
📮 往期精选:想批量处理图片的可以看 ImageMagick 那篇;想把手边闲置机器用起来的,等我们的自托管监控那一期。
💬 你现在日常查库用的是哪个客户端?有没有被启动速度劝退过?留言区聊聊。
如果这篇对你有用,点个赞和在看,转给那个还在等数据库客户端启动的同事。

