8160亿个参数,免费下载.Meta把一个顶级AI的“脑子”挂上了网
- 2026-10-18 03:26:38
欢迎关注公众号,并设星标,不错过每一篇精彩文章~🌟昨晚,Meta 把 816B 参数的 Muse Spark Open 权重放上了 Hugging Face。这件事看起来离我们很远,但它可能会决定,未来几年 AI 到底握在谁手里。
【推荐】年终长文15000字:学习的终结(The End of Learning)
昨晚睡前刷手机,刷到一条消息,愣了大概三秒钟。
Meta 把一个叫 Muse Spark Open 的模型的权重,挂到网上了。免费下载。
你可能对这句话没什么感觉。我翻译一下:这相当于一家公司研究出了目前全世界最聪明的“脑子”之一,然后把它的构造图、全部细节,原封不动地放到了网上,谁都可以下载,装进自己的机器里。
这个脑子有多大呢?8160亿个参数。上下文窗口一百万 token,差不多是你一次性喂给它十几本长篇小说,它都记得住,还不带忘的。能看图、能听音频、能读文档,主打的就是帮你干长活——读一个庞大的代码库,规划怎么改,动手改,改错了自己发现、自己返工。
Meta 自己的话说,这是“美国迄今最强的开源权重模型”。
先说说我为什么愣了三秒
因为就在几个月前,圈子里还在流传一个判断:开源模型这条路,Meta 可能不走了。
他们今年的旗舰模型 Muse Spark 系列是闭源的,只提供 API,你想用,付钱。当时不少人说,那个曾经把 Llama 权重白送全世界、逼得全行业卷生卷死的 Meta,变了。毕竟开源是个赔本买卖——训练这么个东西据说烧掉的钱以十亿美元计,权重一挂网,别人拿去就能用,你图什么?
结果人家不光没放弃,还放了个更大的。
而且这次放出权的细节挺有意思:Meta 专门做了优化,让这个模型能跑在两台 Mac Studio 台式机上。对,就是你能在苹果官网下单的那种桌面电脑,两台拼起来,一个 T 的统一内存,就能在家里跑一个 8160 亿参数的模型。Meta 还真拿这套配置测了:让模型全程在本地给一个开源 App 写代码、修 bug、加新功能、跑完整编译,一次云端都没碰。
“我们相信未来属于每一个人,其中包括在自己家里运行先进模型的自由。”Meta 在公告里是这么写的。
这话有点理想主义,但你要是知道这句话背后站着的是谁,就知道它不完全是情怀。
谁在害怕这个“免费”
你想想,谁最不希望顶级 AI 的权重免费流出来?
是那些靠 API 收钱的公司。你订阅一个 AI 服务,每个月几十几百块,本质上你是在租用别人脑子里的知识。而开源权重模型的意思是:你可以把这个脑子整个搬回家,不用交月费,不用怕哪天涨价,不用怕哪天服务突然停了——就像前两天 DeepSeek 宕机了五个小时,全球一堆依赖它的开发者干瞪眼。如果模型在你自己机器上,就没有“宕机”这回事。
这也是为什么这条新闻下面的讨论里,中国公司被反复提起。现在的开源江湖,DeepSeek、Kimi、Qwen 这些中国模型一直是领跑者,好几份基准测试里,Kimi K3 的代码能力甚至压过了这次 Meta 放出的模型。美国这边一直有人焦虑:“我们最强的模型怎么都在别人家的开源社区里?”Meta 这次挂网,某种程度上就是美国开源阵营的一次集体回血——同一天英伟达也开源了一个 1200 亿参数的多模态模型,跟商量好了似的。
神仙打架,对我们这些普通人来说,倒未必是坏事。模型厂商卷得越狠,我们用到的能力就越便宜。这两年最直观的感受就是:你今年免费或者花很少的钱用到的 AI,比两年前全世界最顶级的还要强。这不是哪家公司大发善心,是竞争卷出来的。
但我也想泼一点冷水
“开源”两个字,别脑补成“免费随便用”。
这次 Meta 用的是自家的 Muse Model License,带商业限制条款。个人玩、学习、研究,随便;但你要是想拿它做成产品大规模商用,得看条款脸色。另外这模型的个头你也看到了,8160 亿参数,官方数据说本地跑起来最少需要 700GB 显存的卡。两台 Mac Studio 那套配置,算下来小二十万人民币。
所以“人人都能下载”和“人人都跑得动”是两回事。真正立刻受益的,是全世界的公司、实验室、开发者——他们可以拿这个脑子做底座,用自己的数据改造出千千万万个垂直领域的专属模型,而不用再被 API 卡脖子。
这其实是开源模型真正的价值:不是你我家里的电脑能跑多牛的 AI,而是整个世界造 AI 的门槛,又被拉低了一截。
写在最后
我有的时候会觉得,我们这一代人正在围观一场特别壮观的比赛:一边是“把最强的东西锁起来,按月收费”,另一边是“把最强的东西放出去,让所有人站在它上面盖房子”。
这两条路没有绝对的对错。锁起来的公司账上更体面,放出去的生态更繁荣。但从历史经验看,浏览器、安卓、Linux——最后真正改变了所有人生活的,往往是那些被放出来的东西。
昨晚那个 8160 亿参数的“脑子”挂上网的那一刻,全世界某个角落里,可能已经有团队把它下载下来,开始训练一个专治某种罕见病读片的模型,或者一个只服务小语种的语言模型。
这些事情不会出现在明天的热搜里。但三五年后回头看,改变可能就是从昨晚那个免费下载按钮开始的。
信息来源:Meta Research 官方博客、Meta Developer 文档、Unite.AI、The Deep View 等公开报道(2026 年 10 月 15-16 日)。
(点击标题可阅读完整内容)
1. 前言:为“学习”立传写史
2. 附录:学习简史年表
3.中国人不再能模仿的技术
4. 数学只是一种语言游戏,却为何如此有用?
5. ChatGPT会如何影响我们?
6. 人类通过语言来学习
7. 数学仅仅是一种语言
8. 乔布斯、盖茨为何不让孩子用手机?
9. 读图时代,为何会出现阅读危机?
10. 人类转向读图时代
11. 互联网教育为何失败?
12. 发现儿童
13. 追求学历的真实追求
14. 基因组决定一人,连接组定义一人
15. 基因不是神灵
16. 基因决定,还是教育万能?
17. 输在起跑线的恐惧
18. 一条叫“智商”的幽灵
19. 左右脑的传说
20. 数学与语文完全不同?
21. 数学能力的大脑建构
22. 脑科学的“神话”
23. 人类为何发明数字及文字?
24. 机器人也要通过语言来思考吗?
25. 人类文明史上最重要的发明

欢迎关注公众号,并设星标,不错过每一篇精彩文章~🌟
想读书,读书难,不读书,让AI来替我们读。
作者花了一周时间,“训练”了一个《学习简史》机器人。
有关《学习简史》的内容,你都可以直接问它了。
附:访问方法图解(《学习简史》机器人)
1.直接关注本公众号“学习简史”(各种方法都可以)
2.在公众号菜单中点击“机器人”
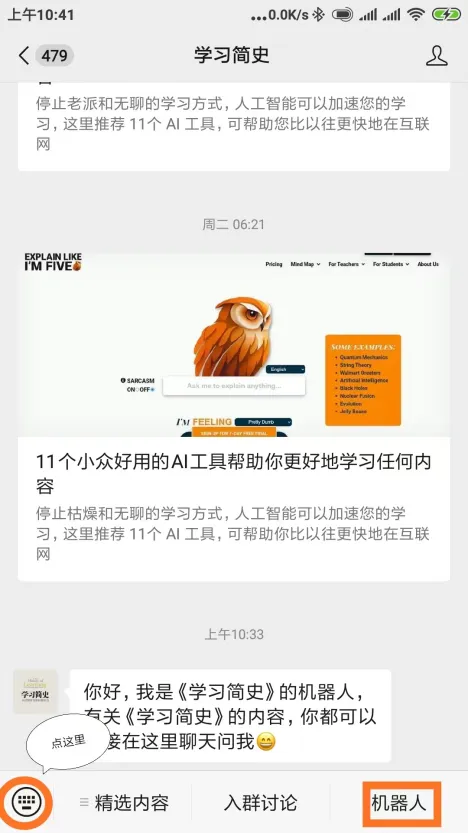
3.直接在这里聊天问它了
想读书,读书难,不读书,让AI来替我们读。
试一试,看看怎么样?

