公众号文章批量下载工具:数海丹心出品,公众号全部文章一次性批量下载,六种格式一次存好
- 2026-10-12 05:10:35
TECH INSIGHT
群里念叨了一个多周的公众号批量下载工具:数海丹心出品,微信 3.X 能抓,六种格式一次存好
社区群里的大佬们念叨这个工具,不是一天两天了。
科技 · 产业 · 人
深度观察
本文看点
01
01 群里念叨了一个多周的活儿
02
02 群里那句原话
03
03 它到底做了什么
01
01 群里念叨了一个多周的活儿
之前做了一个工具实现输入一个或多个文章链接即可实现公众号文章下载
群里很多大佬都询问是否有批量下载的工具,我经过一个周的研究终于实现了公众号文章的批量下载
做自媒体的,想把同行公众号里几年的爆款扒下来,攒成自己的选题库; 做老师的,想把学科号里的干货整批存成 PDF,做成校本资料; 做运营的,要盯住竞品号的每一次更新,还得留档; 做行政的,要给单位的公众号做存量归档,一年一年往下存; 做档案的,手里那些该长期保存的往期文章,总得有个正经的去处; 做记者的,翻老号找素材,一页一页手动另存实在受不了; 做医生的,想把自己号里发过的科普文章按年份存好,以后出合集。
这些人干的活儿八竿子打不着,卡的却是同一件事:公众号的历史文章,没有官方批量导出。
一个号做了三五年,几百上千篇,只能一篇篇点开、一篇篇另存; 想存成 PDF,还得再走一遍打印。存到第一百篇的时候,人已经麻了。
所以这一期,我把公众号文章批量下载工具做出来了。 从我在群里应下这件事,到中间试错、推翻、重来,前后折腾了一个多周。
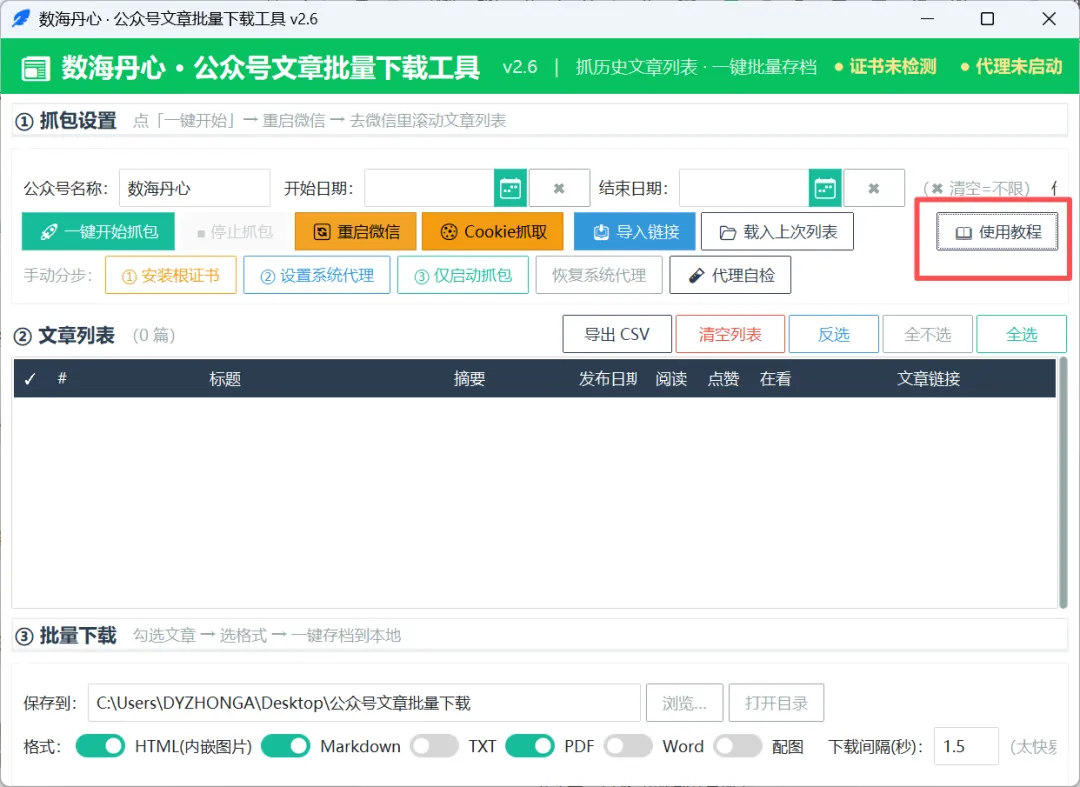
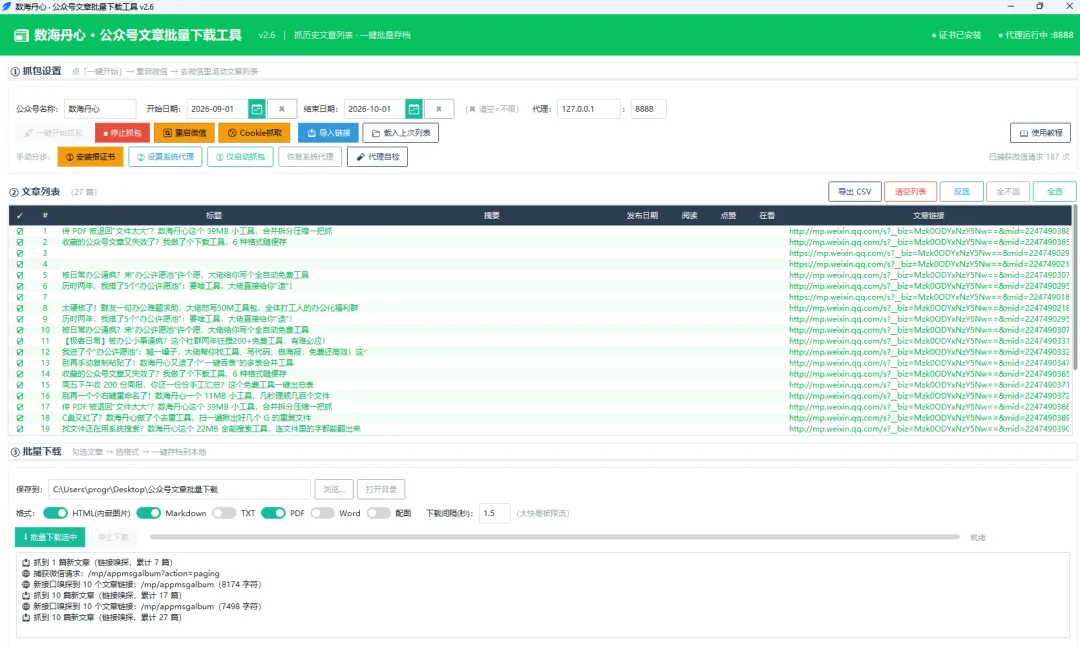
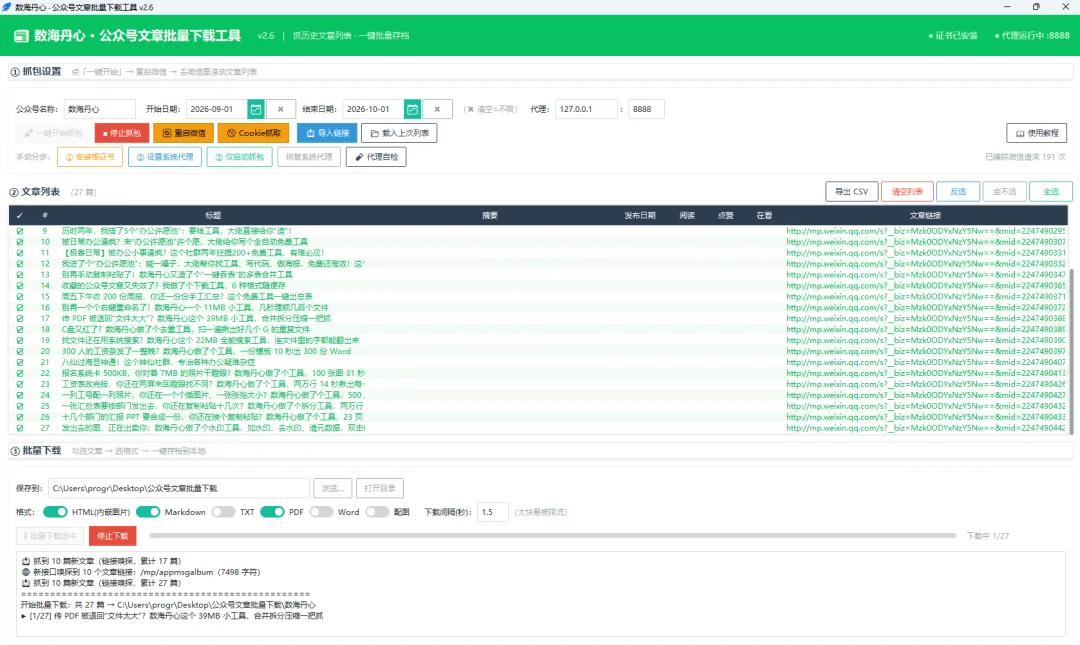
它干的事很直白:把一整个号的历史文章列表抓进表格(标题、摘要、发布日期、阅读数、点赞、在看), 勾选之后一键批量下载成 HTML、Markdown、TXT、PDF、Word、图片 六种格式, 每篇文章单独建一个文件夹,存到本机。一个 EXE 双击就跑,不装 Python,全程本地。
不过在用之前,有两件事我得说在前头,能帮你省掉大半天的白折腾。
先说版本:抓包模式只认微信 3.X 及以下
这个工具的抓包模式,支持的是微信电脑版 3.X 及以下。下载地址:
https://weixin.qq.com/updates?platform=windows&version=3.9.12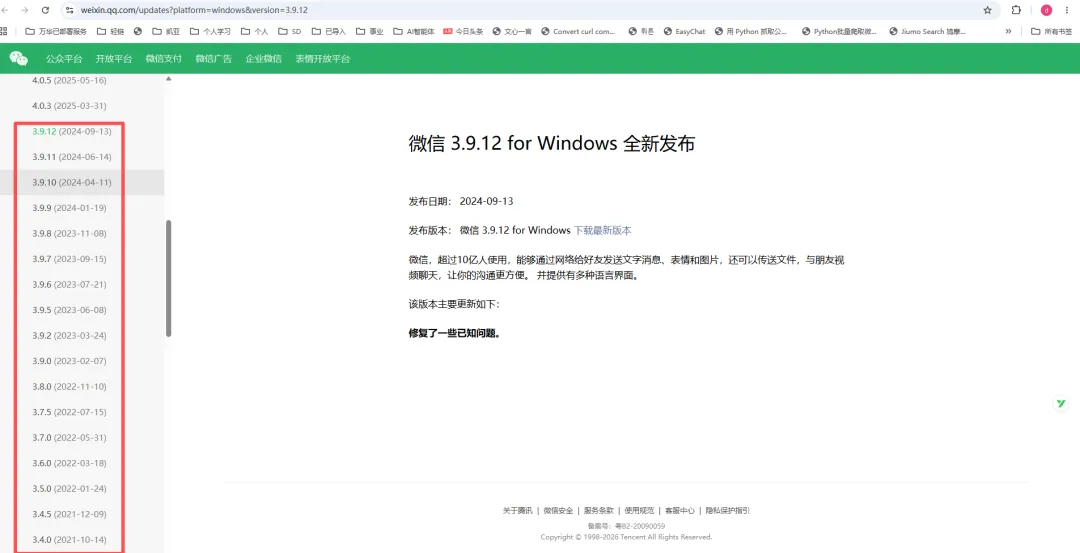
微信 4.X(进程名是 Weixin.exe,2025年之后的新版)抓包是抓不到文章列表的。 原因不复杂:新版公众号主页把文章列表挪进了微信自己的加密通道, 本地代理根本拦不到那份数据 —— 你在日志里能看见微信在请求别的接口, 就是始终不见那份文章列表。
工具不会让你对着空表格干等。它有看门狗:有微信流量、但滚了一分半钟表格还是空的, 就主动弹一句提示,说明新版主页的列表不走系统代理、抓包拦不到,建议改用 Cookie 抓取。
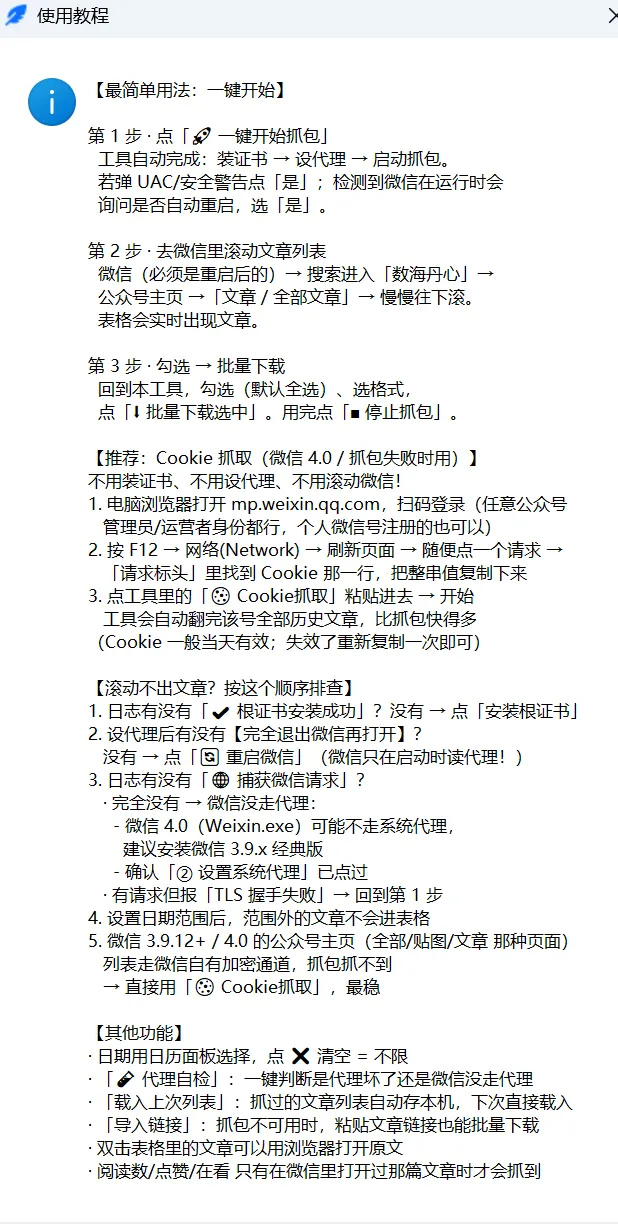
所以微信 4.X 的用户有两条路:装一个微信 3.9.x 经典版, 或者直接走 Cookie 抓取 —— 那条路不挑微信版本,下面会讲。
具体步骤:
再说滚动:列表出不来,就点开文章
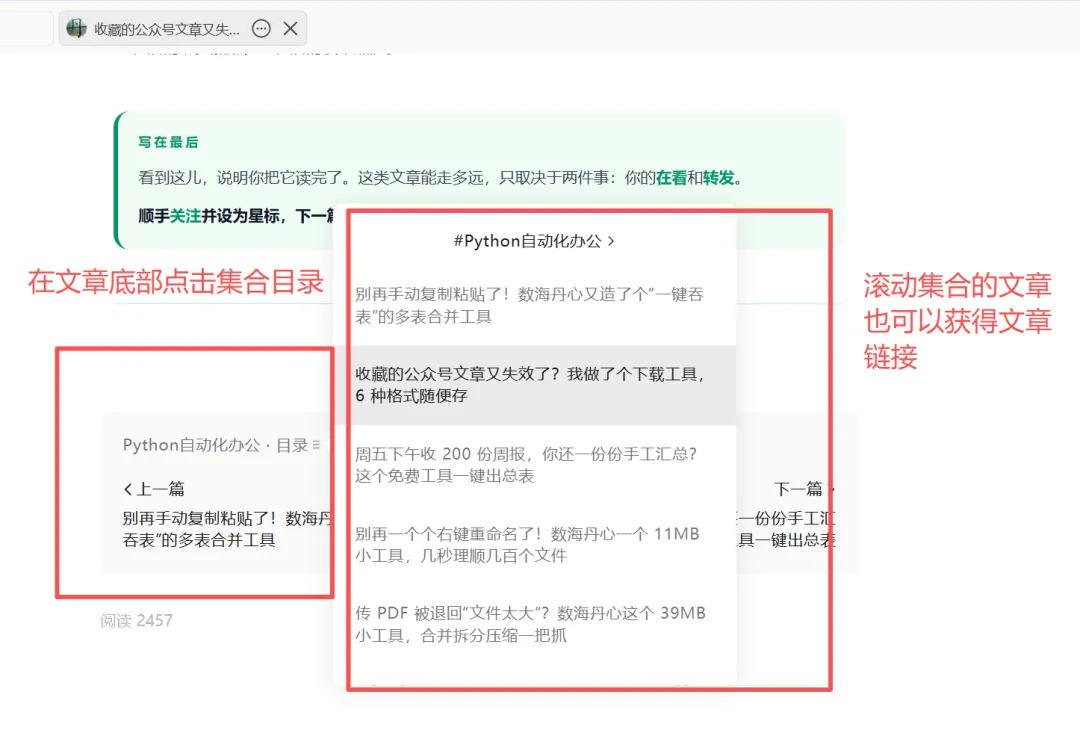
抓包模式下,正常流程是在公众号主页里慢慢往下滚,滚一屏,表格里就多一批。 但有时候滚了半天,表格里还是空的。这时候别停在那儿干等,做两个动作:
一是直接点开一篇文章。 你点开的那一篇,会出现在工具的表格里。将你感兴趣的文章全部点一遍即可实现将这些文章列入列表中。
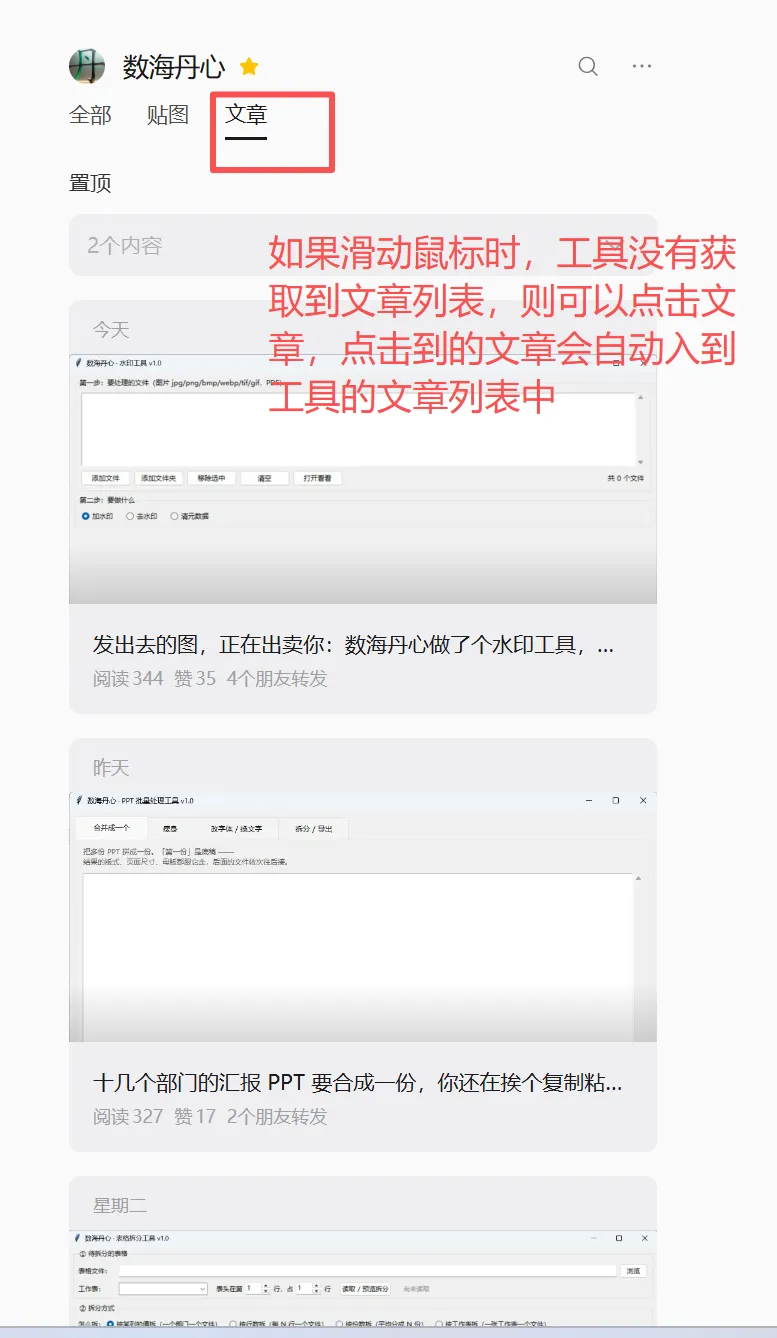
二是进「合集」,滚动这个合集。 合集页面同样能把文章列表喂进表格。
为什么点开就有了?因为这个工具的列表是「见到链接就收」的: 不管微信走的是哪个接口、返回的是 JSON 还是二进制, 只要通信里出现了 mp.weixin.qq.com/s? 这样的文章链接,工具就把它捞出来放进行里。 所以点开哪篇、那篇就进列表,是它原理之内的正常表现,不是碰巧。
02
02 群里那句原话
需求是从群里攒出来的,问的都差不多。
有人问:一个人做的号,做了五六年,上千篇文章,怎么才能一次性全存下来。 也有人问:公司要交接,前同事运营的公众号,历史文章得留档,难道要一篇篇截图。
这两个问题其实是同一个:公众号没有官方的批量导出, 而真正需要留档的场景,恰恰是最不能一篇篇手动存的场景。
需求很清楚。所以这一个多周,我基本都在解决同一件事: 怎么让工具在各种微信版本、各种主页改版之下,都尽可能把列表拿到手。 最后落成了两条通道 —— 能抓包就抓包,抓不动就走公众平台的正规接口。
03
03 它到底做了什么
打勾的都是真跑出来的,不是宣传词:
01
✅ 两种抓取方式。 抓包模式(本地代理截微信)和 Cookie 抓取(粘贴公众平台的 Cookie,直接调接口翻页)。后者免证书、免改系统代理、不用在微信里滚,不挑微信版本。
02
✅ 六种格式。 HTML(图片内嵌)、Markdown、TXT、PDF、Word、配图,勾哪些就下哪些。
03
✅ 整个号的历史列表进表格。 标题、摘要、日期、阅读数、点赞、在看,一列列排好,能全选、反选、导成 CSV。
04
✅ 万能链接嗅探。 微信 3.9.12 之后的新版主页,文章列表装在 protobuf 二进制里。工具不再挑响应格式 —— 只要文本或二进制里出现文章链接,就直接提取。
05
✅ 自动补标题。 嗅探出来的条目只有链接没有标题,工具会后台逐个打开文章页,把真实标题回填进表格(限速,防拦截)。
06
✅ 导入链接兜底。 抓包实在不灵时,粘贴一批文章链接照样能批量下载,下完自动用真实标题命名文件夹。
07
✅ 载入上次列表。 抓过的列表自动存在 %APPDATA%\ShuHaiDanXin\lists\,下次直接载入,不用重复滚一遍。
08
✅ 一键开始。 装根证书、设系统代理、启动抓包三步合一;用完点停止,退出时自动恢复系统代理,不会让你上不了网。
09
✅ 单文件 EXE。 双击就跑,不装 Python,不用登录。
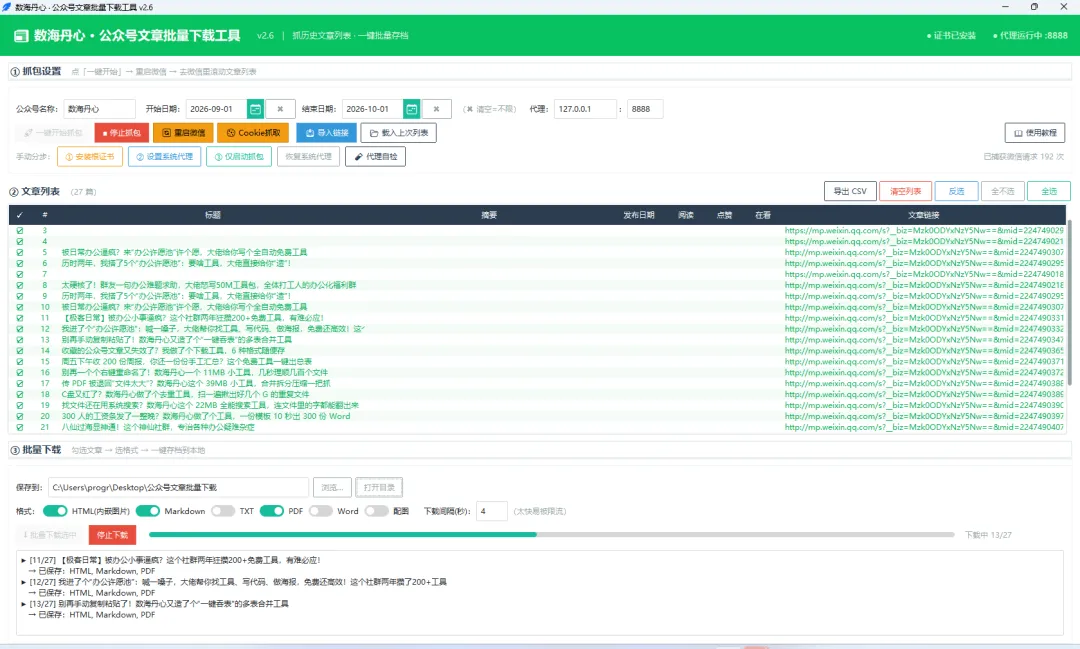
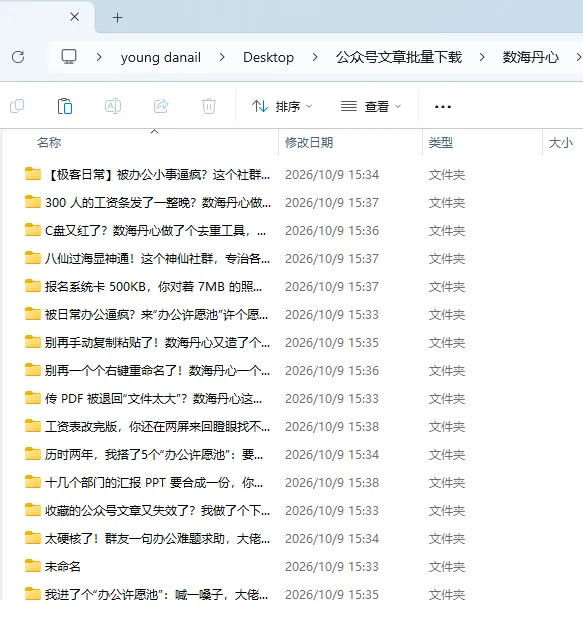
用起来就是:点一键开始 → 重启微信 → 去公众号里滚动 → 回工具勾选 → 批量下载。
04
04 它凭什么值得你信任
一、两条通道,一条不通就走另一条
这是这一个多周里最大的一个决定。抓包不是万能的 —— 微信一改版,列表就可能从系统代理上消失。 所以工具里并排放着第二条通道:Cookie 抓取。
它的原理是另一套:你在电脑浏览器上打开公众平台扫码登录, 把浏览器请求头里那一整串 Cookie 复制给工具, 工具就直接去调公众平台的接口,把那个号的历史文章一页一页翻完。 不装证书、不改代理、不用在微信里滚,一分钟翻完几百篇,而且不挑微信版本。
两条路都摆在界面上,不藏着。抓包通了就用抓包;抓包不通,工具自己会提示你换 Cookie。
二、几个必须说清楚的边界
工具再好,也有它做不到的事,这几条我一并说白:
01
阅读数、点赞、在看这三个数,只有在微信里真正打开过那篇文章时才抓得到 —— 微信的统计接口是打开文章那一刻才请求的。抓包时你没点开过,这一列就是空的,不是工具坏了。
02
抓包模式认微信 3.X 及以下;微信 4.X 的列表数据不走系统代理,抓包拦不到,请走 Cookie。
03
请大家控制节奏。 批量下载建议间隔 1.5 秒以上,别高频猛抓 —— 对服务器客气一点,也是对自己账号客气一点。
04
下载下来的内容,版权归原作者所有,请只作个人存档和学习交流,别用于商业转载或二次分发。
三、自测不是走过场
这一期的自测是四套脚本,交付前全部真跑了一遍:
| test_pipeline.py | ||
| test_mpapi.py | ||
| test_v25.py | ||
| gui_smoke.py |
33 加 18 加 32,一共 83 项检查,全部通过,零失败,界面冒烟也过了。 打包出来的 EXE 是 45,911,601 字节,双击启动之后跑了 20 秒仍然正常存活, 不是打完包就点不开的那种。
四、跟前几期的划界
这个系列里,碰公众号文章的还有更早的一期:收藏的公众号文章又失效了?我做了个下载工具,6 种格式随便存 —— 把一批现成的链接喂进去,批量下载。
这一期多走了一步:它自己去找。 你只要给一个号名和一段日期范围, 或者粘贴一串 Cookie,它就把那个号的历史文章列表给你翻出来。 手里已经有链接的,用它照样能下;手里什么都没有的,才是它真正派上用场的时候。
五、尺寸也交代一句
这个 EXE 是 45,911,601 字节。不是它虚胖 —— 这台机器上有一层终端安全软件, 会拦体积偏小的未签名小程序,所以打包脚本里是故意留了体积的。
05
05 怎么拿到
关注数海丹心公众号 → 后台回复「进群」→ 工具在群文件里,免费领。
群里有几百款做好的工具,也有一群人天天拿它磨自己的活儿。有需要的,进群说一声就行。
工具不会更改源文件内容,使用失误造成的影响概不负责。
写在最后
看到这儿,说明你把它读完了。这类文章能走多远,只取决于两件事:你的在看和转发。
顺手关注并设为星标,下一篇更新第一时间见。
END

