具身模型曙光初现,1-10加速落地(附下载)
- 2026-11-22 20:56:44
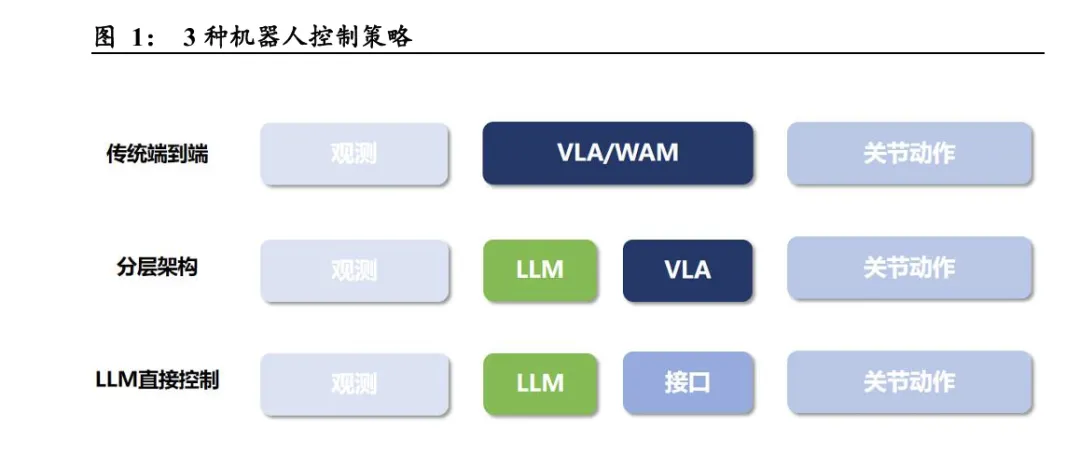
[Table_Summary] 具身模型:大语言模型入局,落地加速。具身模型方面,具身模型是面 向物理世界交互的基础模型范式,目标是打通感知-认知-规划-动作闭环, 将网络空间的大模型知识落地到机器人实体(人形、机械臂、足式)。传 统机器人控制依赖任务专用小模型、固定控制器,泛化能力弱;而具身 模型以多模态基础模型为底座,融合视觉、语言、本体感知、触觉、轨 迹动作数据,形成两种主流路线:端到端 VLA 视觉-语言-动作模型、世 界模型+分层Agent(大小脑)。具身模型从早期LLM简单做任务拆解, 演化到 VLA 端到端、世界模型、分层Agent 多路线并行。当前技术仍 处在实验室原型向真实场景验证过渡期,通用物理智能尚未实现。Astra 等大语言模型的加入,极大提升了模型的泛化性。具身模型存在较大的 问题便是:复刻人类动作的效果已达到90%以上的成功率,但是一旦面 对复杂多变的环境和物体,失败率立刻飙升。而Astra在叠衣服、拿碗、 数字排序等动作表现出极高的泛化性。但另一方面,Astra在精度和速度 上表现较弱。一方面是精度不足:结合Robocurve、RoboDojo在精细操 作的测评表现,明显发现 Astra 的性能并不突出。比如在针对叠衣服的 操作中,直接用Astra控制的成功率只有40%,而使用Astra+pi0.5的方 式则能达到100%。26 年以来,随着具身数据的规模化以及模型架构的 不断创新,业内逐步涌现具备较好泛化性的具身模型,这些具身模型部 署到真机中,已经具备一定的实操能力,且能规模化复制。但由于数据 量仍不足、模型架构存在各种小问题,导致具身模型尚未完全出现所谓 的“Gpt时刻”。展望未来,我们认为,垂类大模型预计在26-27年出现, 通用大模型则预计在28-29年出现。具身数据方面,26-27年的具身模型 在走22-23 年语言模型的路径。按照scaling law,预训练阶段的大规模 数据投喂,将推动模型的性能提升,语言模型证明了这一规律,具身模 型在26年以来遵循这一做法,逐步加大对模型的训练量,并逐步开始看 到泛化性涌现的迹象。主机厂、模型厂陆续发布各自规模化的具身数据 集&目标规划非常宏大。标志着行业从过去发demo比拼,转换成数据基 础设施竞赛,谁能率先积累高质量的大规模的数据集,或能率先取得具 身模型的突破。相比于2025年每个厂商各自大概数百小时的数据集,各 大厂对于 26 年的目标均是百万小时,这本身意味着今年数据基建肯定 会继续大力投入。若按照今年各头部厂商的目标,行业数据(不含仿真) 最高达数千万小时。
1. 具身模型:大语言模型入局,落地加速
1.1. 模型架构&路线:产业进化加速
人形机器人要实现在工业+家庭场景的落地,核心是如何能自主应对各种任务和环 境,而具身模型在其中起到了决定性作用。具身模型是面向物理世界交互的基础模 型范式,目标是打通感知-认知-规划-动作闭环,将网络空间的大模型知识落地到机 器人实体(人形、机械臂、足式)。传统机器人控制依赖任务专用小模型、固定控制 器,泛化能力弱;而具身模型以多模态基础模型为底座,融合视觉、语言、本体感 知、触觉、轨迹动作数据,形成两种主流路线:端到端 VLA 视觉-语言-动作模型、 世界模型+分层Agent(大小脑)。 具身模型从早期LLM简单做任务拆解,演化到 VLA 端到端、世界模型、分层Agent 多路线并行。当前技术仍处在实验室原型向真实场景验证过渡期,通用物理智能尚 未实现。人形机器人产业化瓶颈不仅是本体硬件,更是具身模型在开放世界、长任 务、人机安全、跨本体泛化上的能力边界。未来方向是融合多模态大模型、世界动 力学预测、情景记忆、低层动作专家,构建兼顾通用性、安全性、实时性的混合具 身智能架构。 26 年以来,随着具身数据的规模化以及模型架构的不断创新,业内逐步涌现具备较 好泛化性的具身模型,这些具身模型部署到真机中,已经具备一定的实操能力,且 能规模化复制。但由于数据量仍不足、模型架构存在各种小问题,导致具身模型尚 未完全出现所谓的“Gpt时刻”。展望未来,我们认为,垂类大模型预计在26-27年出 现,通用大模型则预计在28-29年出现。
1.3. 具身数据:模型进化的根基
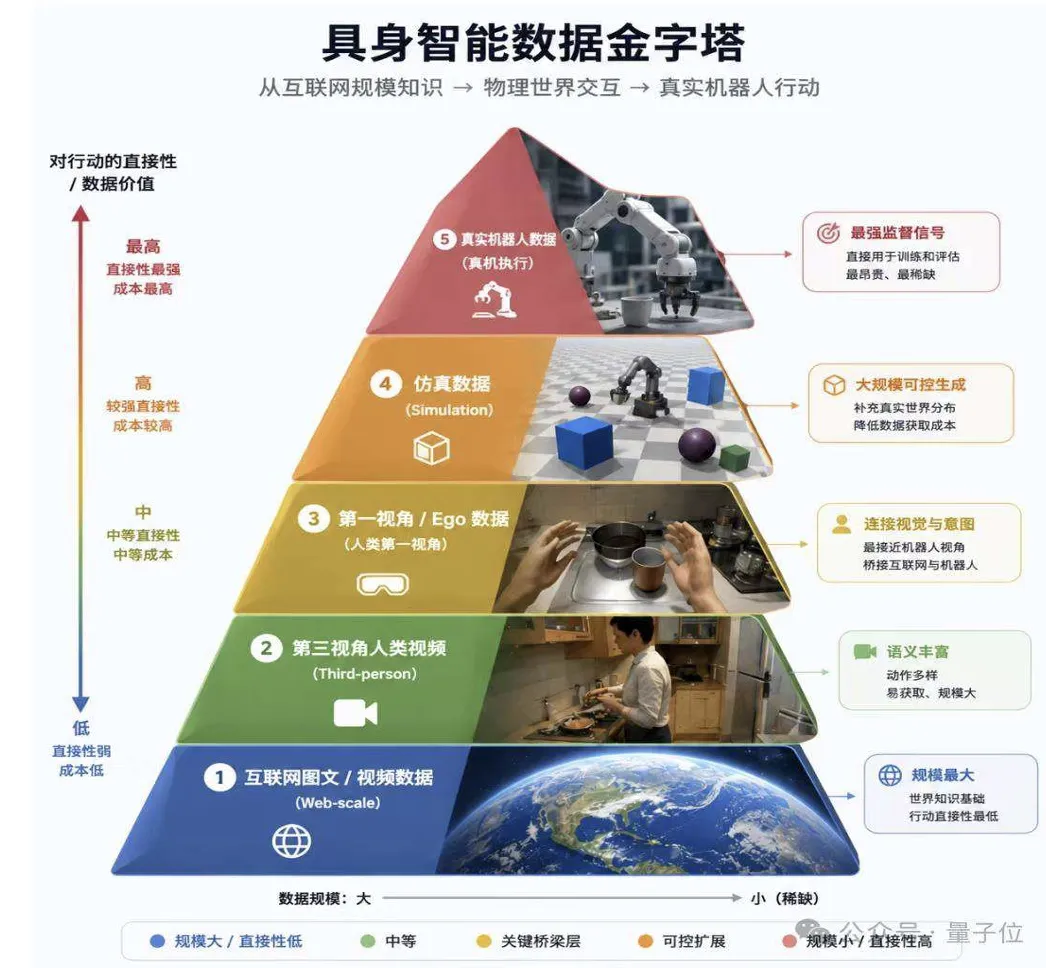
模型训练:26-27年的具身模型在走22-23年语言模型的路径。按照scaling law,预 训练阶段的大规模数据投喂,将推动模型的性能提升,语言模型证明了这一规律, 具身模型在 26 年以来遵循这一做法,逐步加大对模型的训练量,并逐步开始看到 泛化性涌现的迹象。 大模型的最终目标是实现强泛化,让搭载模型的终端成为通用性智能体。而参考 VLM、LLM等语言大模型,实现强泛化的路径便是scaling law,即通过配比参数、 算力和数据,实现模型性能的提升,“大力出奇迹”。同样的,在具身领域,学界和 产业界一直探索如何实现具身模型的泛化,直到25年底GEN-0的出现,证明了当 数据训练量达到一定规模,具身模型同样会出现泛化性,即scaling law规律同样适用于具身模型。
顶级具身基座模型的相继尝试,进一步证明了这一规律。26年以来,包括pi 0.7、 GEN-1、GENE-26.5、Helix-02 等,均使用了大量的数据,比如GENE-26.5为20万 小时、GEN-1为50万小时、Helix-02为100万小时,并且均出现了泛化性。 至于多少小时是一个临界点(scaling law),结合“2025年11月,Generalist AI Team 发布 GEN-0,用 27万小时真实物理交互数据、7B参数的智能阈值突破、证明机器 人可预测性的Scaling”,可暂时判断,27万小时是“稳定进入 Scaling Law” 的公认 门槛、50万小时是商业级部署的节点、百万小时被反复提及为 “具身智能成熟” 的 目标区间。
2. 相关公司充分受益
此报告完整内容与行业资料合集,可扫码进入星球社群查看
(本文仅供参考,不代表我们的任何投资建议。如需使用相关信息,请参阅报告原文。)