下载视频、保存网课、语音转文字,开源工具 Omniget 都能做
- 2026-11-11 06:19:09
想把一套网课存到电脑里,最好连视频、字幕和附件一起收好,打开就能按章节看。谁愿意学一门技术之前,先研究半天怎么下载呢?
开源桌面工具 Omniget 把这些繁琐操作全收进了一套界面:B站教程、YouTube 访谈、受支持平台的网课都能下载;保存下来后,还能把音视频转成带时间戳的文字稿,拿来搜索、做笔记。
它还专门给 AI 留了接口。如果你想让 Codex、Claude Code 帮忙整理视频,下载、查进度和本地转写这些准备工作,都可以直接通过 MCP 工具让 Agent 调用。
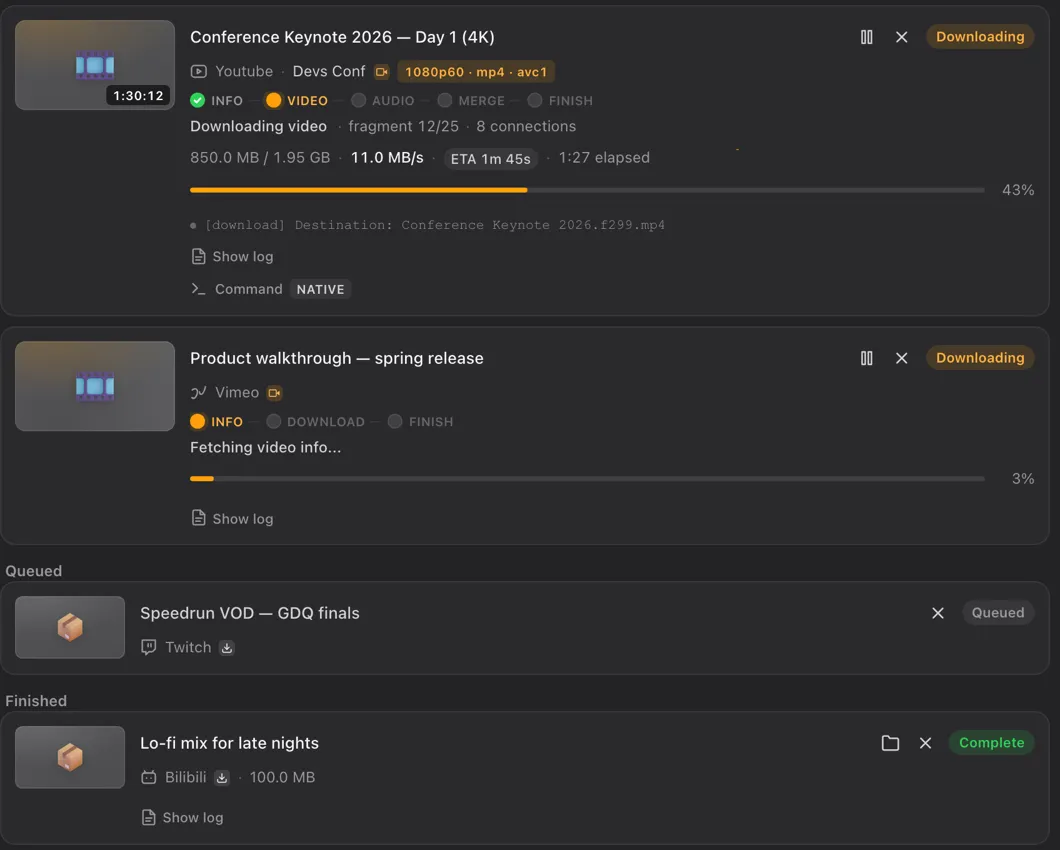
▲ 项目官方界面,支持任务暂停、分集展开与格式管理(3800+ Star)
一套课程,连章节和附件一起保存
Omniget 的日常用法很直白:粘贴链接,查看标题和可选画质,再提交下载。想存一批资料,可以一次加入多个链接,或者直接粘贴播放列表,不必守着每个视频点一遍。
如果平时主要看 B站,可以重点看看收藏夹、稍后再看和弹幕导出这些专项适配;保存目录、清晰度和字幕语言等偏好可以预先设好,后续任务自动沿用。
课程下载又多考虑了一步。对于 Udemy、Coursera 等平台,它会列出完整课程目录,让你勾选要保存的章节,连同视频和随堂附件一起下载,并保持章节序号连续。以后打开文件夹,至少不用先玩一遍“这一节到底排第几”的拼图。
遇到需要登录的页面,它的浏览器扩展就派上了用场:与本地客户端配对后,把当前网页的登录凭据同步过去,省去手动抓取 Cookie 的麻烦(当然,下载权限依然取决于你自己的账号等级,受 DRM 保护的内容也会按平台规则跳过)。
它宣传的“1800 多个网站”,主要来自底层成熟的 yt-dlp 引擎,Omniget 则在顶层补齐了可视化队列、依赖自动管理和分集整理。成熟引擎负责下载,应用负责梳理体验,这种分工很务实。
给长视频留一份能检索的文字稿
存好视频以后,下一个常见需求是找内容:嘉宾提到的那个工具叫什么?老师在哪一节解释过这个参数?单靠记忆拖动进度条,往往很费时间。
Omniget 内置了基于 Whisper 的本地语音转写。初次使用下好模型后,就能直接在电脑本地把音视频转成文字和带时间轴的字幕文件,整个识别过程不需要上传外部服务器。
比如一场长达两小时的技术访谈,想了解关于成本控制的段落,只要在文字稿里搜关键词,就能对着时间轴精准定位回看;整理笔记时也能直接引用原话,不用听一句、按一次暂停、再手敲一遍。
这对访谈、演讲和讲解类课程很合适。如果碰到代码演练或架构拓扑,文字稿适合快速索引定位,画面细节再回看原片,图文配合使用比单留一个视频文件好用得多。
让 AI 接着整理这些本地资料
如果你已经在日常使用 Codex 或 Claude Code,还可以开启 Omniget 的 MCP 服务,把下载入队、进度查询与本地转写作为标准工具挂载给 Agent。
借助这套能力,可以轻松搭起一条资料处理流:让 Agent 自动保存公开的技术演讲、转成文字,再按特定主题提取笔记,并标注原话和对应时间戳。Omniget 负责做好下载和转写,归纳与阅读理解交给 AI,前后分工清晰。
开源生态里还有一款同类工具 VidBee,同样支持本地转写、AI 摘要和订阅下载。如果只是平时顺手存个短片,两款软件都很好用;但如果看重成套网课的分章附件归档,或者准备用 MCP 让编程 Agent 联动音视频管线,Omniget 的专项适配会更顺手一些。
把课程章节按顺序收齐、附件归置好,再给长视频留下一份可检索的文字底稿。收集的资料能真正被检索、被 AI 用起来,这类工具才算真正帮上了忙。
项目地址:https://github.com/OpenSelena/omniget

