RNA-seq分析教程(一):数据下载与预处理
- 2026-10-11 08:03:51
🔬 欢迎来到我们的专栏——生信数据分析「手把手系列」!
接下来我们会持续推出本专栏,内容覆盖 RNA-seq、单细胞测序、pooled CRISPR screening、single-cell CRISPR 筛选、ATAC-seq、scATAC-seq 及多组学分析等。在每个系列中,我们将带你从原始数据下载 → 数据处理 → 统计分析 → 可视化绘图,完整走一遍生物信息学数据分析的流程。我们希望通过这个专栏系列,带你从“跑通代码”到“理解分析逻辑”。无论你是刚入门的生信新手,还是希望系统梳理分析思路的科研工作者,这里都会有你能直接上手、学得明白、用得上的实战内容。
本期是我们「手把手系列」第一篇——RNA-seq 分析教程(一)!
介绍:RNA测序(RNA sequencing, RNA-seq)是一种基于高通量测序技术的转录组研究方法,用于全面分析细胞或组织中所有转录本的表达情况。与传统的基因表达分析方法(如微阵列技术)相比,RNA-seq具有灵敏度高、检测范围广、无需事先知道基因序列等优点。通过RNA-seq,可以定量分析基因表达水平,识别新转录本、可变剪接事件、基因融合、单核苷酸变异(SNP)以及RNA编辑等。RNA-seq广泛应用于基础研究、疾病机制研究、生物标志物发现以及药物靶点筛选等领域,已成为现代功能基因组学研究的核心技术之一。
本教程将从RNA-seq测序获得的原始数据(Raw Data)出发,系统地讲解如何进行转录组数据的预处理与分析。内容涵盖原始测序数据的质量控制、序列比对、表达量定量、差异表达分析以及后续的功能注释和可视化等关键步骤。通过本教程,读者将掌握一整套标准化的生物信息学分析流程,为深入理解基因表达调控机制、挖掘生物学意义提供有力支持。教程适用于初学者,也为有一定基础的研究人员提供实践参考。
本期将带领大家了解常用的公共生物信息数据库,掌握如何检索和筛选符合研究需求的RNA-seq数据。内容包括NCBI GEO(Gene Expression Omnibus)、ENA(European Nucleotide Archive和国家基因组科学数据中心(NGDC,National Genomics Data Center)等主流数据库的基本使用方法,以及如何通过条件筛选、关键词查询等方式定位感兴趣的样本或项目。此外,本章还将介绍RNA-seq原始数据的下载方法及常用工具的使用,为后续的数据处理与分析打下基础。
教程:
1.公共数据库介绍
在转录组学研究中,公共数据库为研究者提供了丰富的RNA-seq数据资源,极大地促进了数据共享与重复利用。常用的公共数据库包括:
1.1 NCBI GEO
链接:https://www.ncbi.nlm.nih.gov/geo/
是由美国国家生物技术信息中心(NCBI)建立和维护的一个重要的公共数据库平台,旨在存储、整理和共享全球范围内生成的大规模基因表达数据。自2000年创建以来,GEO 已成为转录组学研究中最常用的数据来源之一,广泛服务于基础研究、疾病机制探讨、生物标志物筛选等多个领域。GEO 支持多种高通量实验数据的提交与存储,主要包括RNA-seq、微阵列(Microarray)、ChIP-chip、MeDIP-chip 等技术平台生成的表达数据。其数据覆盖范围广泛,涉及多种物种、不同组织、发育阶段、疾病状态以及各类处理条件,极大地方便了研究者对生物学问题的系统探索和大数据挖掘。
1.2 ENA
链接:https://www.ebi.ac.uk/ena
ENA:是由欧洲生物信息研究所(EMBL-EBI)负责维护和运营的国际公共核酸序列数据库,旨在为全球科研社区提供一个高质量、可持续的数据存储与共享平台。其平台设计结构清晰,数据标准严格,检索功能强大,用户可根据项目编号、样本信息、测序平台、物种名称、文献引用等多种方式进行精准搜索。
1.3 国家基因组科学数据中心
链接:https://ngdc.cncb.ac.cn
国家基因组科学数据中心是由中国科学院生物物理研究所和国家生物信息中心共同建设和运营的国家级生物信息数据库平台,隶属于中国科学院。该中心旨在整合、存储和共享大规模组学数据,包括基因组、转录组、表观组、代谢组等,服务于生命科学和医学研究。
1.4 其他数据库
在癌症研究领域,除了常规的公共数据库外,还有一些针对性更强、专门用于肿瘤研究的数据资源平台。典型代表包括 TCGA(The Cancer Genome Atlas)、ICGC(International Cancer Genome Consortium)以及 CCLE(Cancer Cell Line Encyclopedia)等。
TCGA :是由美国国家癌症研究所(NCI)和国家人类基因组研究所(NHGRI)联合发起的大型癌症组学项目,涵盖 30 多种癌症类型。其数据广泛应用于肿瘤分子分型、生存预测、生物标志物挖掘等研究方向。
ICGC :是一个国际合作项目,旨在系统性地绘制多种癌症类型的基因组变异图谱。ICGC 提供的测序数据涵盖不同国家和种族背景的癌症患者,补充了 TCGA 在种群多样性方面的不足,对研究全球范围内的肿瘤异质性具有重要意义。
CCLE:则专注于癌症细胞系数据的整合,收录了数百种来源于不同组织类型的癌细胞系,提供其基因表达谱、突变信息、药物敏感性等数据。该数据库为肿瘤机制研究、药物筛选和个体化治疗策略开发提供了理想的体外模型参考。
这些癌症专属数据库不仅数据质量高、注释完善,而且在生物信息分析工具和可视化平台方面也有良好支持,极大地方便了科研人员对癌症相关生物学问题的深入挖掘与系统分析
2. 公共数据检索(以NCBI GEO数据库为例)
在阅读相关文献时,研究者通常会在“数据可用性(Data availability)”部分找到RNA-seq数据的GEO编号,通常是由“GSE”三个字母打头,衔接几位数字编号,比如“GSE116250”。
该编号是GEO数据库中数据集的唯一标识符。确认编号后,可以访问NCBI GEO官网,在首页的搜索框中输入该编号(如GSE116250)进行查询。
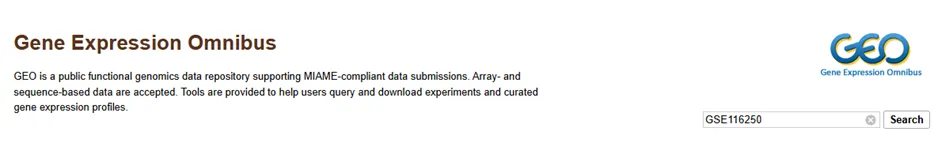 系统会直接跳转到对应的数据集页面,研究者可以在页面中查看数据详情,包括建库方式、测序平台和样本信息等。
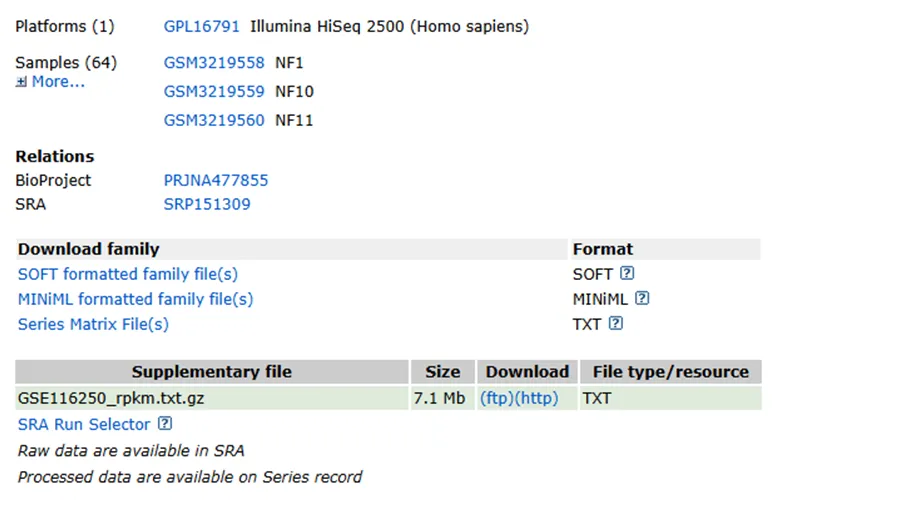
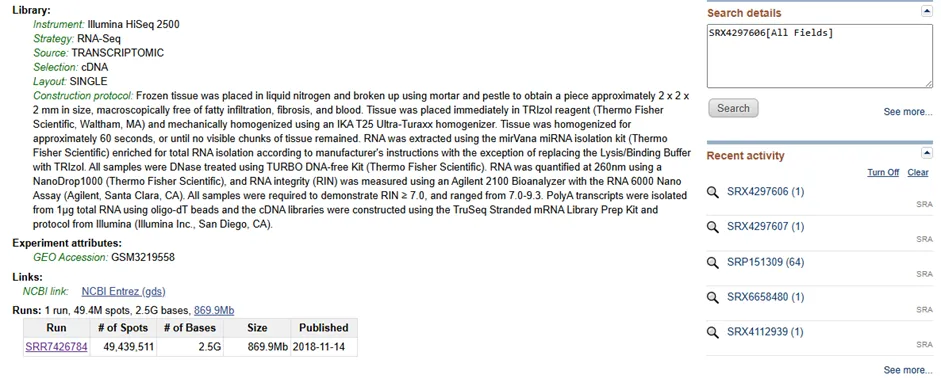
通过点击样本编号(如GSM3219558),可以查看该样本的详细信息页面。向下滚动页面,即可找到对应的SRA序列号,点击进入后,能够查看该样本的建库流程及测序实验设计的详细说明。需要特别注意的是,该样本采用的是单端测序(Single-end sequencing)策略,这一信息对于后续的数据处理和分析具有重要意义。
3. 公共数据下载
在本地或集群服务器中(Linux环境),可首先创建包含目标SRA编号的列表文件。
$ vi SRR_Acc_List.txt
$ cat SRR_Acc_List.txt
SRR7426784
SRR7426785
SRR7426786
SRR7426787
SRR7426788
SRR7426789
SRR7426804
SRR7426806
SRR7426807
SRR7426808
SRR7426810
SRR7426811
随后使用 SRA Toolkit 中的 prefetch 工具批量下载对应的测序数据。
nohup prefetch -X 50G -O . $(<SRR_Acc_List.txt) &
下载完成后,系统将根据每个SRA编号生成对应的文件夹,文件夹内包含一个以 .sra 为后缀的文件。该文件是NCBI用于存储高通量测序原始数据的专有格式。
SRR7426784.sra
SRR7426785.sra
SRR7426786.sra
SRR7426787.sra
SRR7426788.sra
SRR7426789.sra
SRR7426804.sra
SRR7426806.sra
SRR7426807.sra
SRR7426808.sra
SRR7426810.sra
SRR7426811.sra
后续通过SRA Toolkit中的fasterq-dump将 .sra 文件转换为常用的 FASTQ 格式,以便开展进一步的生物信息学分析。该工具支持多种参数选项,主要分为三类:
·当不确定测序数据为单端还是双端时,推荐使用 --split-3 参数,能够自动根据数据类型进行拆分;
·若已确认为双端测序(Paired-end sequencing),可使用 --split-files 将两个读分别输出为 _1.fastq 和 _2.fastq 文件;
·亦可选择 --split-spot,将双端数据合并为单个 FASTQ 文件,其中每对读以“一个测序片段”记录方式存储。
根据具体的测序策略和分析需求选择合适参数,有助于保证后续分析的准确性与一致性。
fastq-dump --gzip --split-3SRR7426784.sra
fastq-dump --gzip --split-3SRR7426785.sra
fastq-dump --gzip --split-3SRR7426786.sra
fastq-dump --gzip --split-3SRR7426787.sra
fastq-dump --gzip --split-3SRR7426788.sra
fastq-dump --gzip --split-3SRR7426789.sra
fastq-dump --gzip --split-3SRR7426804.sra
fastq-dump --gzip --split-3SRR7426806.sra
fastq-dump --gzip --split-3SRR7426807.sra
fastq-dump --gzip --split-3SRR7426808.sra
fastq-dump --gzip --split-3SRR7426810.sra
fastq-dump --gzip --split-3SRR7426811.sra
运行上述fastq-dump --gzip --split-3 命令后,将为每个 SRR 号产生一个或多个压缩的 FASTQ 文件,具体形式如 _1.fastq.gz、_2.fastq.gz 或 .fastq.gz,取决于该测序数据是单端还是双端,以及是否存在非配对或质量被过滤的 reads。
SRR7426784.fastq.gz
SRR7426786.fastq.gz
SRR7426788.fastq.gz
SRR7426804.fastq.gz
SRR7426807.fastq.gz
SRR7426810.fastq.gz
SRR7426785.fastq.gz
SRR7426787.fastq.gz
SRR7426789.fastq.gz
SRR7426806.fastq.gz
SRR7426808.fastq.gz
SRR7426811.fastq.gz
下一章,我们将介绍如何对产生的.fastq.gz 数据进行质控(如去除低质量序列和接头污染)。后续还会继续介绍如何比对到参考基因组/转录组,最后对比对结果进行表达量定量,以得到基因的表达矩阵。
小结:本章内容带大家了解了生物信息学主要的几个数据库,包括美国的NCBI GEO、欧洲的ENA和我们国家的国家基因组科学数据中心。以NCBI GEO的一个公共数据集作为例子,向大家介绍了如何寻找和下载所需的数据,并对数据格式进行转化以便后续分析。
最后,生信分析是孰能生巧,想让操作过程变得简单易控,还需要大家勤加练习和总结!
本章所用到的工具:
SRA Toolkit: https://github.com/ncbi/sra-tools
—————End—————
🧬 关注我们(派致生物),我们会持续分享生信分析干货,包括:单细胞测序及多组学分析,常规转录组分析,CRISPR 筛选与功能分析,高分文章解析,数据库与工具推荐等。
🌟 同时提供科研服务:单细胞测序、CRISPR筛选及生信分析、数据挖掘支持
✨ 助力科研人员高效出图、挖掘数据、发表文章,欢迎咨询!
📩 联系方式:
邮箱:info@pregen.cn
微信咨询: 小红书:
📌 更多案例解析、流程示意和工具分享,欢迎关注我们的小红书👆。

