156亿估值的美国独角兽,正在偷偷“下载中国AI”
- 2026-09-26 18:27:17
156亿估值的美国独角兽,正在偷偷“下载中国AI”一家估值156亿美元的美国法律科技公司,毛利率从50%跌到-50%。CEO做了一个让硅谷炸锅的决定:把核心技术底座,换成中国模型。Harvey,美国法律AI领域的头部玩家,客户包括全球顶级律所。今年3月,它更新了AI智能体功能,客户使用量激增。按理说这是好事。可是不久后,财务团队就发现了一个可怕的事实:毛利率从年初的约50%,一路跌到了6月的-50%。原因很简单:Harvey的底层依赖OpenAI和Anthropic的闭源模型,按调用量付费。用户用得越多,Harvey付给美国AI巨头的钱就越多。收入在涨,利润在蒸发。 
Harvey做了一个决定。8月,它发布了自己的法律AI模型Tenet。技术报告里写得清清楚楚:Tenet以中国月之暗面的Kimi K3为基础,通过法律数据和专家数据后训练而成。一家美国法律科技独角兽,把自己的核心技术底座,换成了中国模型。这不是孤例。这是一场正在硅谷悄悄发生的地壳运动。01 毛利率被吸干之后,他们开始“抄底”中国模型Harvey的遭遇并非个案。AI Agent创业公司Lindy,25名员工,创始人Flo Crivello在X上发了一条帖子,引发了876K次浏览:“推理成本是我们最大的支出,远超员工薪资总额。”Lindy做的是AI办公助手,用户让Agent自动处理邮件、安排会议、录入CRM。每一个操作都要调用大模型。用得越多,烧得越快。Crivello算了一笔账:如果推理成本能降低2到5倍,“将会带来翻天覆地的变化”。他花了6到9个月评估各种开源模型。去年,开源模型“根本就没那么接近”。3个月前,“几乎完成了”。最终,Lindy把生产环境的全部模型流量,从Anthropic切换到了DeepSeek V4。迁移工作量暴涨了100倍,但一年节省了数百万美元。 更关键的是,在邮件分类和回复等核心场景中,DeepSeek的表现甚至超越了原来的模型。“用Claude比发工资还贵。” 这句话正在成为越来越多海外AI创业公司的共同心声。02 那些“长”在中国底座上的海外模型如果你以为海外公司只是“调用API省钱”,那就低估了这件事的深度。Cursor,全球最贵的AI编程工具,今年3月发布编程模型Composer 2。技术报告明确写道:该模型以Kimi K2.5为基础,在代码数据上继续预训练,再通过大规模强化学习优化。5月推出的Composer 2.5,仍以Kimi K2.5为基础。Cosine,英国AI初创公司,用Kimi K2.6训练出专门维护遗留代码的Lumen Outpost。后训练让Kimi K2.6在Vibe-Bench上的表现从22.7%提升到29.4%。Thinking Machines Lab,前OpenAI CTO米拉·穆拉蒂创办的公司,发布首款模型Inkling。技术说明写得极其坦诚:混合专家架构“主要沿用DeepSeek V3” ,后训练冷启动使用了Kimi K2.5生成的数据。Multiverse Computing,西班牙公司,发布Quasar 1.1 438B模型,官网明确标注:基于智谱GLM-5.2开放权重开发,通过压缩技术改造。这家公司在社交媒体上把这个成果称为 “欧洲最强AI模型”。Aikido Security,比利时网络安全公司,发布安全模型Altar,基于智谱GLM-5.3开发。公司写道:“我们选择GLM-5.3作为起点,是因为它是我们安全评测中表现最强的模型之一。”Harvey的法律模型Tenet,基于Kimi K3,依托约1750个法律工作智能体环境迭代优化,历时约2个月。专项训练后的Tenet,完整完成法律实务任务的数量接近原始Kimi K3的两倍,在合同起草、审查和谈判中提升约20%。 
一个清晰的模式正在浮现:中国企业研发通用基础模型,欧美企业用开放权重做压缩、行业后训练和产品化,然后以“本土模型”的身份在当地市场亮相。03 为什么是“中国底座”,而不是“美国底座”?答案藏在两组数字里。第一组:价格 OpenRouter数据显示,中国开源模型的价格普遍比Anthropic和OpenAI的旗舰产品便宜60%到90%。DeepSeek V4 Flash每百万Token输入0.09美元、输出0.18美元,而GPT-5.5同期定价是输入5美元、输出30美元。输出端的差距超过100倍。第二组:能力 Kimi K3的表现接近Anthropic最先进的模型,但成本“低得多”。在第三方分析机构Artificial Analysis的数据中,K3单次推理的平均任务成本约0.94美元,不到Claude Opus 4.5的一半。价格差在100倍量级,性能差在个位数百分比。 对于任何一家需要规模化调用模型的创业公司来说,这道选择题的答案,不需要犹豫。04 这不是“抄”,这是全球AI产业链的重新分工有人会说:这不就是“抄”吗?恰恰相反。这是开放权重模型生态的正常运转方式。MIT License、Apache 2.0协议——这些中国模型发布时使用的开源许可证,明确允许任何人下载、修改、商用、再发布。Cursor没有“偷”Kimi的代码,它是在Kimi公开发布的权重之上,用自己的代码数据和强化学习流程,训练出了一个更适合编程场景的模型。 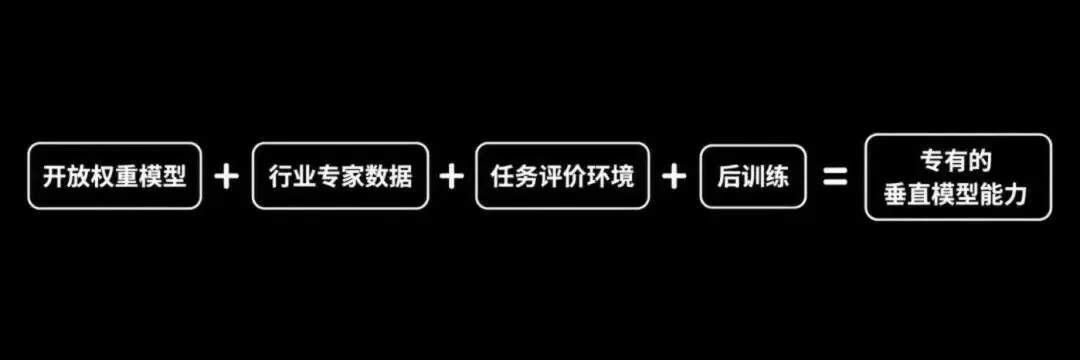
这是开源生态的设计意图,不是漏洞。过去一年,中国模型出海的首要目标是“让海外开发者用起来”——开放权重、降低价格、进入Hugging Face和OpenRouter。当模型在海外形成规模后,一个新的问题浮出水面: 如何从“被使用”变成“被依赖”?答案正在浮现:通过开放权重,成为海外企业产品的“技术底座”。在Hugging Face上,中国开源模型的累计下载量已居全球首位。在OpenRouter的调用量排行榜上,前五名由中国企业包揽。当一家海外公司的核心技术栈里嵌着中国模型时,它就不再只是一个“用户”,而是一个深度绑定的生态参与者。写在最后Harvey的毛利率从50%跌到-50%,然后又靠Kimi K3重新转正。Lindy的推理成本曾经超过全员工资,切换DeepSeek后一年省下数百万美元。Cursor、Cosine、Thinking Machines——这些硅谷和欧洲最聪明的AI创业公司,正在把中国模型写进自己的技术报告。中国AI的出海,正在从“卖Token”升级为“做底座”。过去,我们说“中国模型便宜”。 现在,海外公司的技术报告在说:“中国模型是起点。”这不是一场零和博弈。 中国企业提供通用基础能力, 海外企业做垂直后训练和产品化。 这是全球AI产业链的自然分工, 也是开放权重模型生态最健康的运转方式。当硅谷开始“下载中国AI”, 真正的问题不是谁抄了谁, 而是——下一个被写进技术报告的底座,会是谁。 参考信息: 1. 又一家!“美企放弃美国模型,转用Kimi K3” 观察者网/网易 2026-08-23 https://m.163.com/dy/article/L4VI8PPH051481 US.html 2. 初创公司自研AI模型升温:从编程工具蔓延至金融科技 Digital Today 2026-09-22 https://www.digitaltoday.co.kr 3. 一批海外模型“长”在中国开源底座上 北京日报 2026-09-24 https://news.bjd.com.cn/2026/09/24/11973063.shtml 4. Harvey‘s first in-house model for legal work is here The Next Web 2026-08-23 https://thenextweb.com 5. OpenAI-backed legal tech firm pivots to Chinese Kimi K3 open-weight model The Star 2026-08-29 https://www.thesta r.com.my 6. 这家Agent公司从Claude切到DeepSeek v4:一年省下数百万美元,迁移工作量却是预期的100倍 InfoQ 2026-06-25 https://www.infoq.cn/article/KfCaAKEXqDsmrDCxr4P1 7. Der Grund, weshalb ein amerikanisches Unternehmen sich für 100 %ige Integration von DeepSeek entscheidet 36氪 2026-06-30 https://eu.36kr.com/de/p/38742842727289 68 8. American AI is expensive. Some startups are turning to cheap Chinese models NPR 2026-07-15 https://www.npr.org 9. Composer 2技术报告 Cursor官方博客 2026-03-27 https://cursor.com/de/blog/composer-2-technical-report 10. Cursor滑跪!开源技术报告:Kimi基模如此微调可击败Claude 36氪 2026-03-27 https://eu.36kr.com 11. Introducing Lumen Outpost Cosine官方博客 2026-05-13 https://cosine.sh/blog/introducing-lumen-outpost 12. Training for Vibe: A Structured Approach to AI Behaviour Cosine官方博客 2026-05-13 https://site.cosine.sh 13. Mira Murati‘s Thinking Machines draws from Chinese rivals in debut AI model 金融时报 2026-07-17 http://app003.ftchinese.com/interactive/287538/en 14. 借鉴中国AI技术,前OpenAI CTO推出全新开源大模型 环球网/腾讯新闻 2026-07-16 https://news.qq.com 15. 沿用DeepSeek架构,美国大模型开始抄中国作业 钛媒体 2026-07-21 https://m.tmtpost.com 16. “欧洲最强模型”,陷入“套壳”中国开源模型争议 新浪看点/北京日报 2026-09-19 https://k.sina.com.cn/article_1893892 941_70e2834d020023kl6.html 17. “欧洲最强”大模型遭群嘲:宣传帖“放得下欧洲旗帜,却不提源于中国模型” 新浪财经 2026-09-18 https://finance.sina. com.cn 18. Aikido Altar: open-weight AI for sovereign security Aikido官方博客 2026-09-21 https://www.aikido.dev/blog/aiki do-altar-open-weight-ai-sovereign-security 19. 比利时网络安全公司基于GLM-5.3推出Altar 称其为安全评测中最强模型之一 搜狐 2026-09-22 https://www.sohu.com 20. Belgium’s Aikido launches cybersecurity AI model as demand for local tools grows The Star 2026-09-21 https://www.thestar.com.my 21. 智谱,榜单登顶!马斯克“点赞” 上海证券报/搜狐 2026-09-22 https://www.sohu.com/a/1079564162_120988576 22. OpenRouter:智谱AI旗下GLM-5.3-Flash当日调用量增超七成,位列第一 澎湃新闻 2026-09-22 https://www.thepaper. cn 23. Token太贵,中国开源模型一夜之间霸榜了 36氪 https://www.36kr.com 24. 中国开源权重模型在开发者平台用量反超美国闭源模型,周度token处理量达其3倍 Digital Today 2026-07-20 https://www.digitaltoday.co.kr
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:wyl860211@qq.com 。

