基因家族鉴定(进阶 02)|命令框下载转录组数据:SRA Toolkit 从 prefetch 到 FASTQ
- 2026-11-23 00:54:30
一、调出命令框
按住 Win 键不放、再按 R,输入 cmd 回车——黑窗口就是命令框(图1)。先挪到 Toolkit 的 bin 目录(本机装在 E 盘,你按你的安装路径来):
cd /d E:\大创项目\sratoolkit\sratoolkit.3.0.7-win64\bin
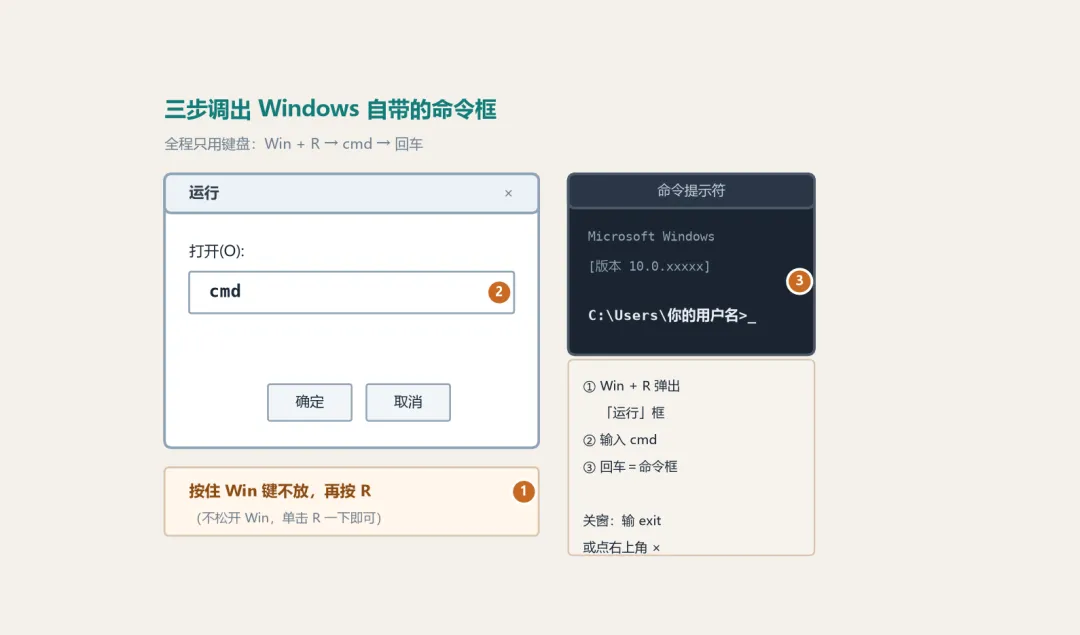
运行框与命令框为界面示意;按键与命令为 Windows 实际行为
二、prefetch 拉包
单条下载:prefetch SRR8249029。
批量下载:把 SRR 号一行一个存成清单,prefetch --option-file SRR_Acc_List.txt(随文 14 行清单,对应七个发育期)。
两个本机实测出来的坑:一是 --max-size 的单位是 KB 不是 MB,写 --max-size 1000 只有 1 MB(提示语原话:Maximum file size download limit is 1000KB,图2);二是它卡线卡得死——本机 G2 样本的 .sra 是 781 MB,写 --max-size 800000(正好 781 MB)它照样跳过,写 1000000 才放行。下好的 .sra 落在 C:\Users\你的用户名\ncbi_public\sra\。
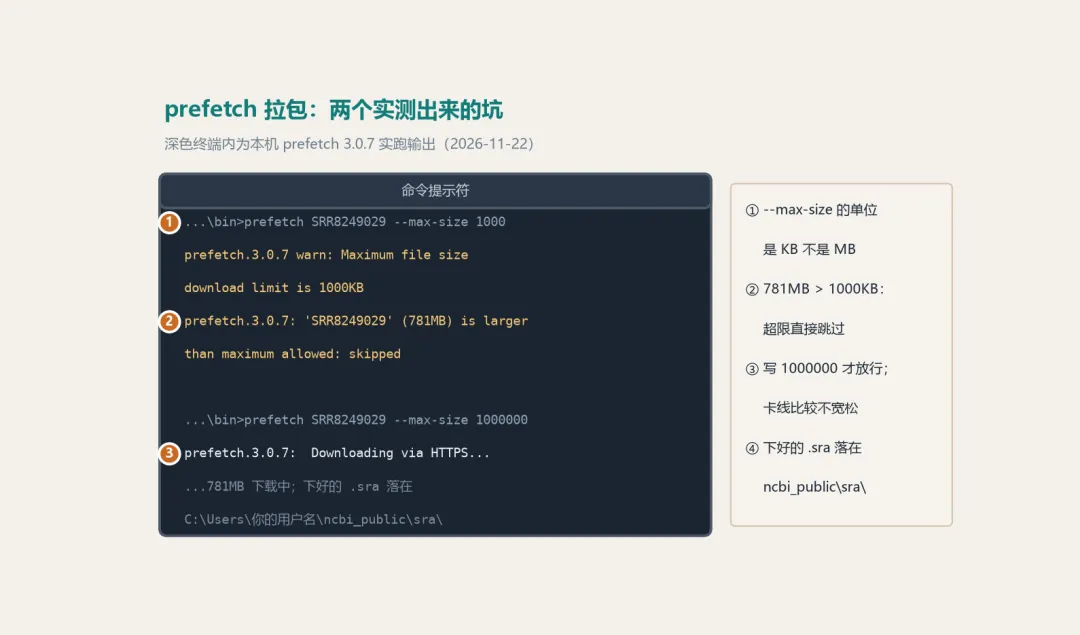
skip 提示、781MB 大小与缓存路径均为本机 prefetch 3.0.7 实跑输出(2026-11-22,时间戳与完整路径过长处截断显示)
三、fastq-dump 转 FASTQ
.sra 不是分析软件认的格式,转 FASTQ:
fastq-dump --gzip --split-3 SRR8249029
--gzip 边转边压缩省空间;--split-3 是拆分参数里的万金油(图3):双端拆成两个文件、落单的 reads 单独放;单端数据不受影响——本例就是单端,只出 SRR8249029.fastq.gz 一个文件。
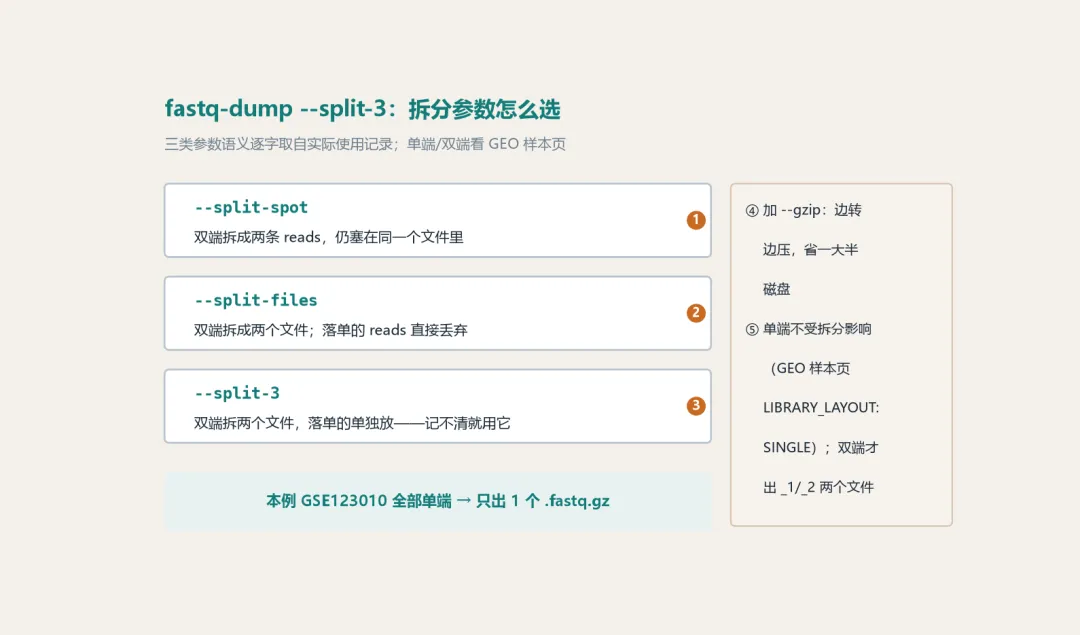
三类拆分参数语义逐字取自实际使用记录;单端/双端判断依据 GEO 样本页 LIBRARY_LAYOUT 字段(本例 14 样本全为 SINGLE)
三句丑话:prefetch 下的是 .sra 原始格式,别拿去直接比对;本例单个样本的 .sra 就有 781 MB,14 个全拉请放夜间批量;fastq-dump 转 700 多万条 reads 要几分钟,急用换 fasterq-dump(多线程,本机 3.0.7 实测同样认 --split-3;但它没有 --gzip,出的是未压缩 .fastq,要自己压)。
原始数据到手,从 FASTQ 到表达表还有一段"比对 + 定量"的流水线——想先看看"七个发育期谁在干活",下一篇抄条近路画热图。
下一篇:发育热图——七个发育期里谁在干活。
本内容由Al辅助,人工已校验

