100 亿次下载之后,国产开源大模型真正的考题才刚开始
- 2026-11-22 21:31:55
本文由【博学志君】原创实战干货都在「HFCW副业实战圈」关注我,用AI把副业变成印钞机
100 亿次下载之后,国产开源大模型真正的考题才刚开始
📌 配图建议:一张世界地图上,用密集光点标出下载来源分布,主视觉压一行大字「100 亿次」。冷色调,别用红旗和奖杯那种老套路。
11 月 21 日,《人民日报》一篇《国产大模型引领全球开源生态》把三个数字摆到了同一张桌子上:
工信部口径:我国人工智能开源大模型全球累计下载量突破 100 亿次 OpenRouter 11 月 9–15 日周调用:中国模型 119.1 万亿词元,连续 29 周全球第一 国内日均词元:约 500 万亿(中国信通院《大模型词元服务性能监测报告(2026年)》披露,2026 年 6 月数据,较 2025 年 12 月翻近 4 倍)
朋友圈里已经被「遥遥领先」四个字刷屏了。但如果你是把 AI 当生意做的人——创业者、企业 CTO、产品经理——光看这三个数字没用。下载、调用、收钱,是三条完全不同的曲线,中间隔着好几道坎。
今天这篇,我们不吹不踩,就把这 100 亿次拆开看:它到底证明了什么,没证明什么,以及你该怎么用它。
一、先把口径钉死:100 亿次到底是什么
很多人一看「100 亿」就开始脑补「全球一半开发者在用中国模型」。冷静一下。
这是工信部给出的累计下载口径,含义是:
累计值,不是月活、不是日活 包含重复下载、量化衍生、二次分发、镜像同步 统计的是「被获取」,不是「被跑起来」
打个比方:安卓系统装机量 30 亿,不等于 30 亿人天天在用。下载量衡量的是生态厚度,不是当下流量。
真正能交叉验证「被用起来」的,是另外两个数:
| 100 亿次 | |||
| 119.1 万亿词元 | |||
| 约 500 万亿 |
💡 三个数放一起才有意义:有人拿、有人用、用出了量。单拎任何一个出来都会被误读。
再看一个更硬的旁证:Hugging Face《开放模型现状:2026 年夏季观察》(8 月 14 日发布)显示,中国研发的开源模型下载占比 41%,首次超过美国的 36.5%,居全球第一;基于千问的衍生模型 151448 个,是 Meta 全部模型的 2.6 倍、Llama 系列的 4.7 倍。
衍生模型数量比下载量更能说明问题——下载是「看一眼」,衍生是「拿回去改、拿回去训、再发出来」。这才是生态。
二、底层逻辑:为什么是「开源」这条路跑通了
这不是运气。北京智源副院长叶启威说得很直白:开源是后发者换生态位最有效的方式。
把时间轴拉一下你就看懂了:
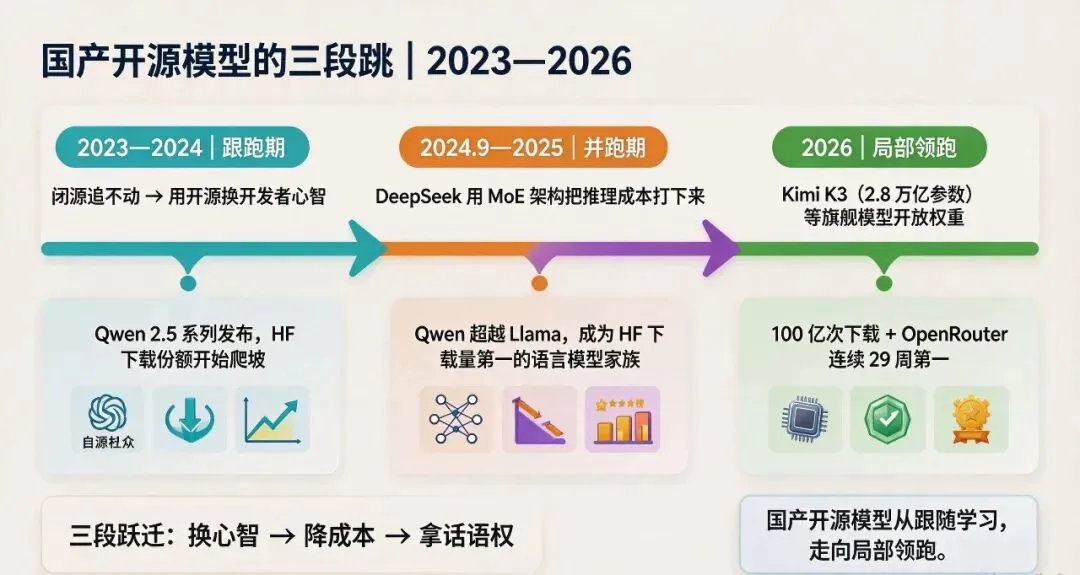
三个关键动作决定了今天的局面:
架构创新压成本:DeepSeek 的 MoE 混合专家、Kimi 的混合线性注意力,直接把「超长文本算得更省、超大模型训得更稳」变成可能 许可证足够松:据业界统计,2026 年参数超 200 亿的中国开放模型中,Apache 2.0 与 MIT 合计占比约八成,几乎没有非商用限制;同规模美国模型这一比例不到三成 尺寸覆盖全档位:从能塞进手机的 0.5B,到机房集群的 2.8T,同一套体系里都有
⚠️ 但要注意一个反转信号:2026 年年中开始,头部旗舰里已经出现了附加收入分成条款的样本(如 Kimi K3.1 Pro)。「越开放越好」是阶段性竞争选择,不是长期承诺。用之前逐版本核对 license,比认牌子靠谱。
三、穿透噪音:下载量没证明的三件事
下载量 ≠ 日常调用量
累计值里塞满了重复下载、镜像、微调实验、教学用途。据 Hugging Face 报告观察:1.5% 的仓库贡献了 99.2% 的下载量,而且参数 10 亿以下的小模型占了历史累计下载的 83%,超 1000 亿的只占 1%。
真正在流水线上跑的,是小模型,不是那些刷屏的万亿参数旗舰。旗舰是用来抢心智的,小模型才是用来赚钱的。
调用量 ≠ 收入
OpenRouter 是高度市场化的聚合平台,谁便宜谁走量。中国模型能连续 29 周第一,很大程度上是因为 token 单价打到了地板——GLM 5.3 Flash 等低成本系列把输入价打到几分钱一百万 token 的量级,Llama 3.1 8B 也才 $0.02。
走量是好事,但毛利率是另一回事。亚洲数字经济学院陈柏珲提醒过一句很扎心的话:如果推理、微调、观测这些环节都被少数云平台把持,模型哪怕开源,利润还是会留在算力提供方手里。
开放权重 ≠ 随便商用
拿 Kimi K3.1 Pro 举例:2.8 万亿总参数、量化后权重包约 1.56TB、光加载就要至少 12 张 141GB 显存的加速卡,个人开发者在家基本跑不动。而且它用的是厂商自定义许可——连续 12 个月 MaaS 收入超 2000 万美元的转售业务要单独签约,月活破 1 亿或月收入超 2000 万美元的产品必须标注模型名。
开源把底座交到你手里了,但收费口从「卖模型」挪到了「卖推理、卖微调、卖平台」。门槛降的是使用端,不是商业化端。
四、对三个行业意味着什么
🏭 制造业:从「买 AI」变成「养 AI」
京东方是最典型的样本。它以国产开源大模型为底座,自研蓝鲸显示大模型,覆盖研发设计、生产制造、质量管理,产线上实时捕捉微观缺陷 → 生成修复方案 → 联动设备完成修复,全链路闭环。
变化的本质:以前先进模型攥在少数闭源平台手里,制造企业只能「买能力」;现在权重在自己手上,可以拿自家十几年的产线数据做二次开发,形成 competitor 抄不走的行业资产。
工信部等八部门今年初印发的《"人工智能+制造"专项行动实施意见》已经把话说死了:到 2027 年推动 3–5 个通用大模型在制造业深度应用,打造 100 个工业高质量数据集,推广 500 个典型场景。这不是风口,是明牌。
🌏 出海与全球南方:语言主权回来了
新加坡的海狮 V4 基于千问开源底座,覆盖 119 种语言、在 36 万亿词元上预训练,专门伺候东南亚复杂的语言环境。印尼 GoTo 和 AI Singapore 基于 SEA-LION 用印尼语、爪哇语、巽他语语料做了 Sahabat-AI。
这对做出海的人是重大利好:以前想做泰语、越南语、阿拉伯语的垂直应用,闭源 API 又贵又不够本地化;现在下载权重 + 本地语料微调,一个小团队就能干。
《纽约时报》观察到 OpenRouter 热度前十里有六款是中国模型;《经济学人》援引 a16z 合伙人马丁·卡萨多的话——美国 AI 初创企业约八成在融资路演时用的是中国开源模型。这句话的分量,比任何榜单都重。
🧑💻 个体开发者:25 分钟 8000 块的样本
报道里有个容易被忽略的细节:开发者吴瑞孟接到淘宝店主「用二次元图片给车贴膜」的需求,在无代码平台「秒哒」上花 25 分钟做出 demo,最终成交 8000 元。
一个人、一句话、25 分钟。这就是开源模型下沉到个体手里的样子。稀缺的从来不是模型,是「知道拿模型去解决谁的什么问题」。
五、给三类读者的行动清单
如果你是创业者
别再训基座了。100 亿次下载意味着底座已经白菜价,重新训一个通用大模型是负 ROI 往垂直微调 + 私有化部署 + 许可合规评估这三个方向切。IDC 数据已经显示:中低复杂度、标准化、高吞吐场景里,开源 + vLLM 的 token 占比在快速从闭源往外流 定价别盯 token 单价,盯「单位成功任务成本」——一次调用便宜不等于把一件事办完便宜
如果你是企业决策者
做一次模型资产盘点:哪些场景可以切开源(客服、文档、翻译、代码补全),哪些必须留闭源(高风险决策、强合规、要 SLA 的工作流) 建双轨制:开源权重兜底 + 闭源 API 打前沿。这样既降本,又留了「随时自己接手」的底气 算总账不算单价:推理集群、微调工具、观测体系、安全审计,这些不免费。以 K3.1 Pro 为例,光加载权重就要 12 张 141GB 加速卡,推理还要留 KV 缓存空间,硬件门槛直接把中小团队挡在门外
如果你是产品经理
记住那个 83%:10 亿以下的小模型才是生产环境的主力。别一上来就选万亿旗舰,先算端上能不能跑 license 逐版本核对。以 Kimi K3.1 Pro 为例,已经带上了 MaaS 收入分成条款,别等法务来找你 用户看到的是同一个助手,背后可以换模型——掌握「任务路由」的人,比掌握「某个模型」的人更有议价权
最后
100 亿次下载是一个里程碑,不是一个终点站。
它证明的是:中国开源模型已经从「备选项」变成了全球开发者的「默认底座」之一。它没证明的是:我们能靠这个赚到钱。
下一阶段的胜负手,不在榜单,在账单——谁能把每一词元的成本再压一档,谁能把行业场景扎得更深,谁能把许可和治理规则写成国际标准,谁才能从「生态领先」走到「利润领先」。
那个 25 分钟赚 8000 块的开发者,其实已经把答案写出来了:
模型不是稀缺品,知道拿它解决谁的什么问题才是。
如果觉得这篇文章对你有启发,欢迎点个【在看】,转发给那个也在琢磨AI副业的朋友。👉关注「博学志笃行志」,学AI行创业合一志!
今日互动:评论区留言点赞最多的3位小伙伴送《AI资料包》