国产AI大模型,全球下载破100亿次
- 2026-11-21 16:04:58
你有没有想过,全球AI圈最抢手的“底座”,可能就来自咱们中国?
说实话,这个数字刚出来的时候,我盯着看了好几遍——100亿次。工信部最新数据:我国人工智能开源大模型全球累计下载量,正式突破100亿次!日均词元调用量也突破了500万亿。啥概念?在全球开源模型聚合平台OpenRouter上,11月9日到15日这一周,中国模型的周调用量是119.1万亿词元,连续29周稳坐全球第一。100亿次啊,朋友们,这是全球开发者用鼠标一下下点出来的信任。
29周啊,讲真,这已经不是“偶尔赢一次”,是稳稳坐在那儿不下来了。
那问题来了——“开源大模型”到底是个啥?很多人一听“开源”就以为是免费送,其实吧,门道没那么简单。
模型开源,更准确说叫“开放权重”。权重是啥?就是模型里那些数以千亿计的参数数值,记录着模型在训练中学到的语言规律、逻辑推理和知识。开放权重,意味着你可以把模型下载下来,放到自己的电脑或服务器上跑推理,甚至微调它去适配你自己的活儿。企业不用花大钱从头训练,就能拿到一个聪明的“底座”;对数据隐私要求高的,还能本地或私有云部署;连发展中国家都能低成本用上前沿能力。说白了,以前是少数巨头手里攥着AI的钥匙,现在钥匙直接发到每个人手里了。
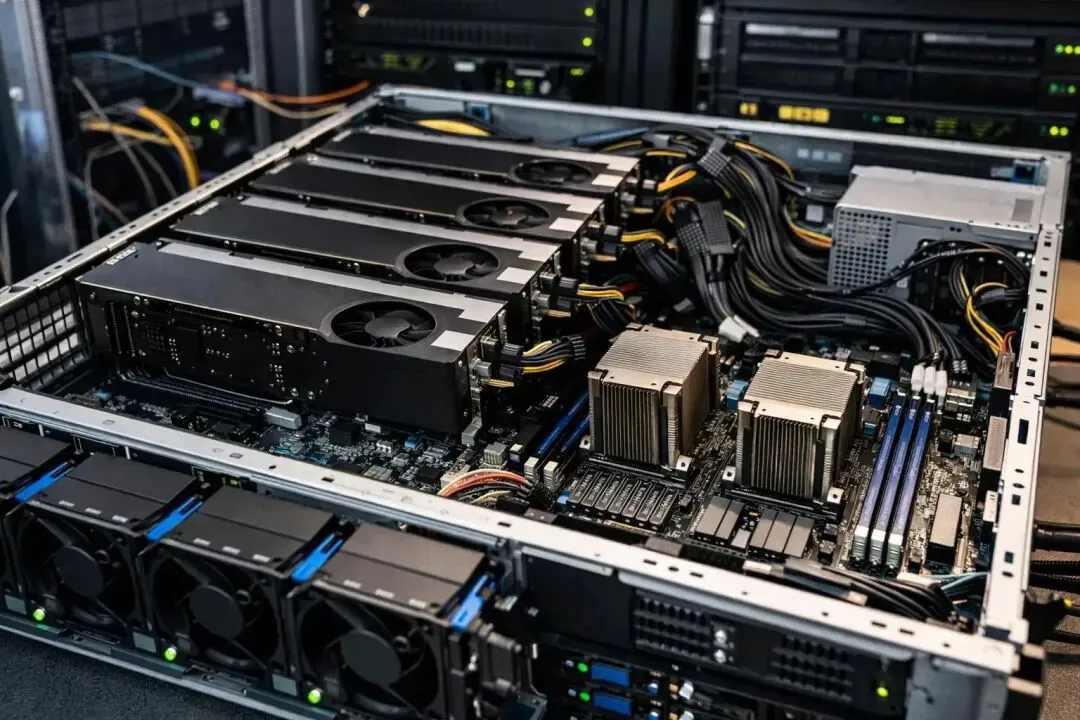
一句话:开源,把AI的门槛一脚踹开了。
当然,开源不等于不赚钱。靠云端推理、智能体平台、模型微调,企业照样能形成可持续收益。开源,其实是护城河,也是竞争力。
说到这,就得聊聊咱们那些能打的模型了。DeepSeek系列去年初一发布就炸了,性能突破加上对混合专家模型架构的创新,大幅降低了推理成本和算力需求,这个架构后来成了全球AI圈一起探索的方向。
月之暗面的Kimi K3.1 Pro,直接公布了完整模型权重,是全球参数规模最大的开源模型,自研的混合线性注意力机制,用创始人的话说就是“让超长文本算得更省、超大模型训得更稳”。腾讯混元Hy4在指令遵循、长文理解、长程任务上又往前走了一步;美团LongCat-2.5更硬核,干脆靠国产算力跑完了训练和推理全流程,把神经网络处理器确定性计算、算力利用率提升这些硬骨头都啃了下来。
更让我意外的,是开源模型已经“下厂”了。京东方蓝鲸显示大模型,拿国产开源大模型当底座,融合工业制造经验和产线数据,研发设计、生产制造、质量管理全覆盖,已经在工厂落地。阿里千问更绝,成了新加坡“海狮V4”多语言大模型的基座,覆盖119种语言、36万亿词元预训练,去服务东南亚的用户了。
从实验室到车间,从国内到海外,这条路,咱们走出来了。
中央网信办副主任王京涛有句话说得很透:词元可计量、可定价、可交易,词元调用量正成为观察AI活跃度、产业渗透深度、智能化水平的重要指标。你别说,现在国内网购平台都上线了词元充值中心,双11直播间里,词元都成抢手货了。中科院计算所研究员张云泉也说,AI普惠的可能性,得建立在坚实的开源根基上,中国正把这个普惠愿景变成实际行动。你看,连“词元”都开始明码标价、走进直播间了,AI离咱们的日常,是真的不远了。
说实话,我一开始也没想到开源能走到这个位置。但回看这些数据,你会发现一件事:真正的技术影响力,从来不是把模型关在柜子里,而是让更多人用得上、用得起。
你怎么看?评论区聊聊,你用过哪个国产开源大模型?觉得有用的话点个收藏,咱们下期接着唠~

