TCGA单基因预后分析怎么做?从数据下载到KM、Cox、ROC、列线图全流程
- 2026-11-19 00:20:02
TCGA单基因预后分析怎么做?从数据下载到KM、Cox、ROC、列线图全流程TCGA(The Cancer Genome Atlas,癌症基因组图谱)是目前最权威、最常用的肿瘤公共数据库,也是肿瘤生信论文和课题机制研究的"数据宝库"。基于 TCGA 做一个单基因预后分析,是很多同学入门肿瘤生信的第一课。本文用一组真实计算的示例,把从数据下载、预处理到KM 曲线、Cox 回归、时间依赖 ROC 和列线图的完整流程讲清楚。 单基因预后分析的核心是:拿到目标基因在肿瘤患者中的表达,结合随访信息,评价该基因表达与患者生存结局的关系,并进一步构建可用于临床的预测模型。完整路线如下: 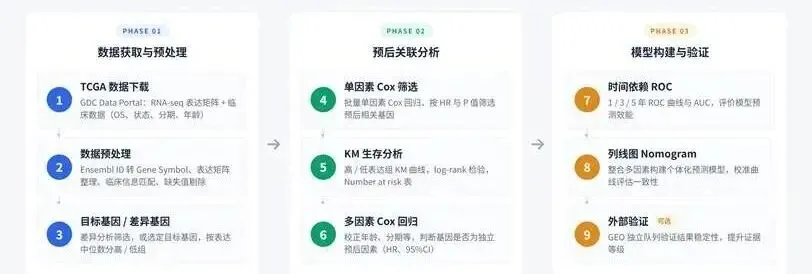
图2TCGA 单基因预后分析技术路线(9 个环节) 本文示例队列共纳入 380 例患者,其中发生死亡事件 300 例,随访截止 60 个月。 Kaplan-Meier 法(乘积极限估计)是最基础的生存分析方法,它能处理删失数据,逐时点估计各组的生存概率。分别对高、低表达组拟合 KM 曲线,并用 log-rank 检验比较两条曲线的差异。 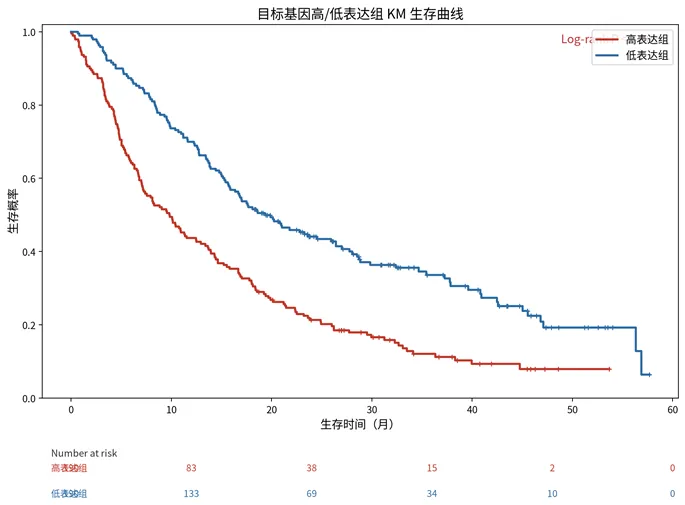
图3目标基因高/低表达组 KM 生存曲线(含风险人数表) KM 与 log-rank 只能考察单个分组因素,而 Cox 回归可以同时纳入多个变量、校正混杂,并给出风险比 HR,是判断独立预后因素的核心方法。 本例多因素结果:目标基因 HR=1.93(95%CI 1.70–2.18,P<0.001),病理分期 HR=2.17,年龄 HR=1.05,均为独立风险因素;性别 HR=1.08(P=0.532)不显著。 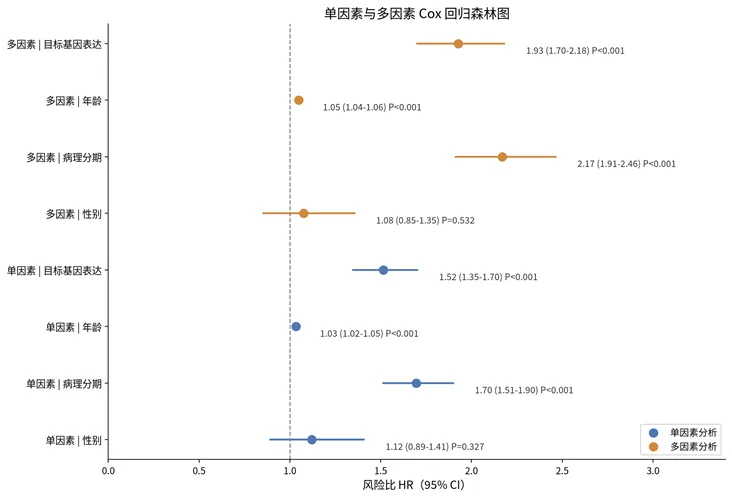
图4单因素与多因素 Cox 回归森林图 普通 ROC 无法处理生存数据的删失和时间维度,因此预后模型采用时间依赖 ROC,分别评价模型在 1 年、3 年、5 年时点的区分能力,用 AUC 量化。 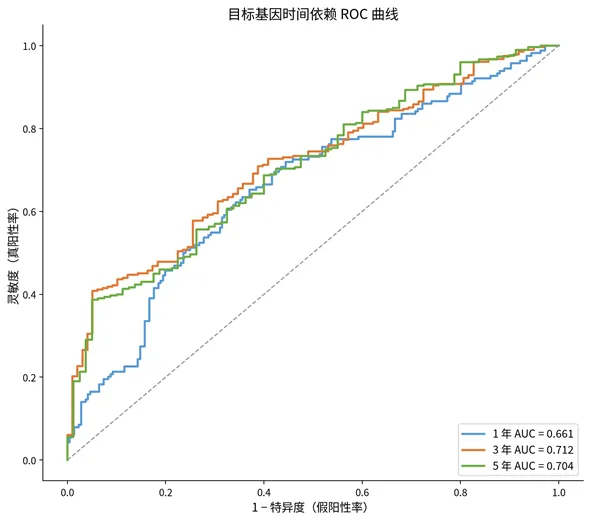
图5目标基因 1/3/5 年时间依赖 ROC 曲线 将患者按 Cox 风险评分从低到高排序,三联图直观展示风险评分、生存状态与基因表达的对应关系:评分越高的患者,死亡事件越密集、生存时间越短,且目标基因表达越高,三者趋势一致,进一步支持模型的可靠性。 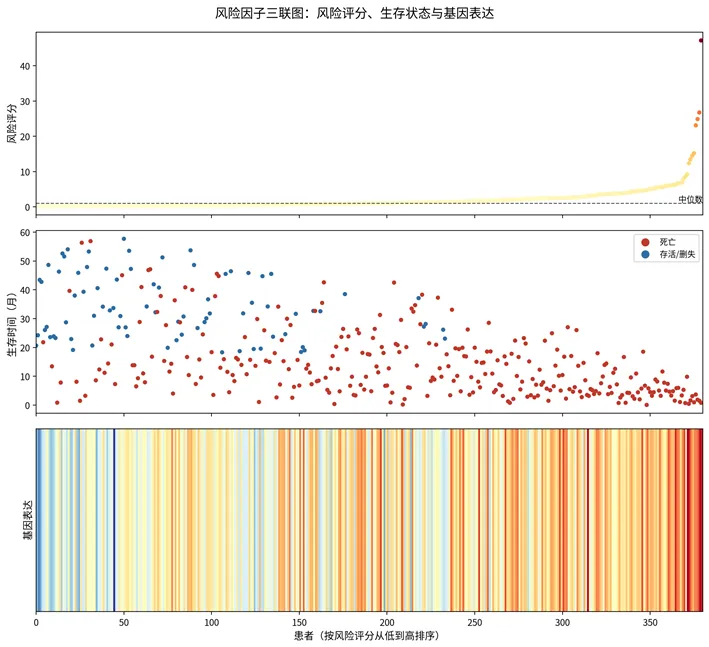
图6风险评分、生存状态与基因表达三联图 列线图把抽象的 Cox 回归方程转化为临床可直接使用的个体化预测工具: 校准曲线用于检验列线图预测的准确性,图中各点越贴近对角参考线,说明预测值与实际 KM 结果越一致。本例校准点紧贴对角线,模型预测准确度良好。 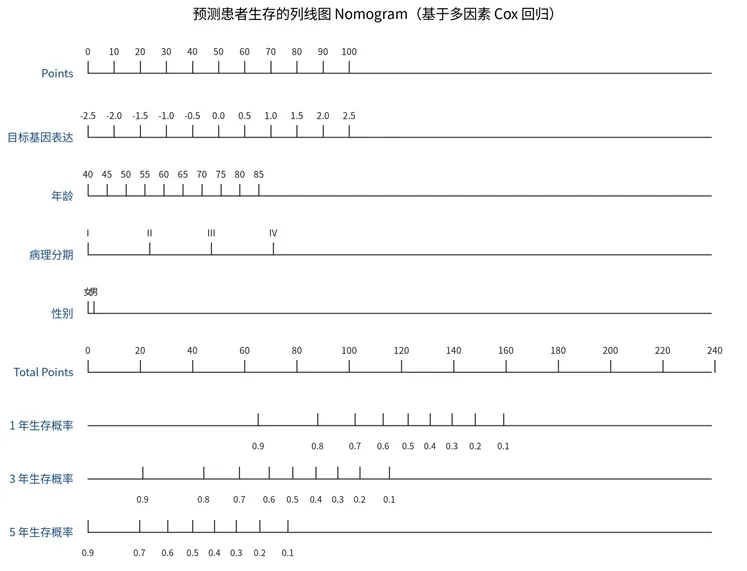
图7整合多因素的生存预测列线图 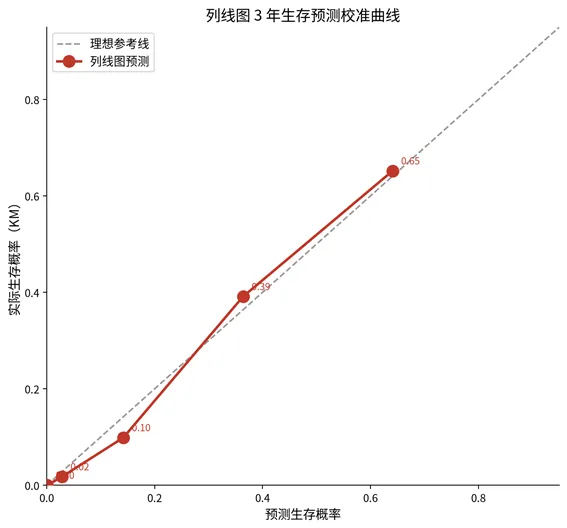
图8列线图 3 年生存预测校准曲线 一套完整的 TCGA 单基因预后分析,跑通 KM、Cox、ROC、列线图这"四件套",就能支撑一篇结构完整的生信论文或课题的生信部分。关键在于规范的预处理、合理的阈值选择和外部验证。 创作不易,点个关注再走吧。 如果有任何问题,欢迎在文章下方留言。 作者 | Run END 往期回顾 新手RNA-seq——送样到出图的完整过程 FlowJo细胞周期分析全流程:PI直方图怎么拟合G1/S/G2/M,一步步圈给你看 FlowJo凋亡分析全流程:从原始FCS到凋亡率统计,一步步圈给你看 qPCR数据分析与避坑指南(下篇) qPCR从原理到上机:荧光怎么来、实验怎么做,一篇讲透(上篇) ImageJ | 灰度值统计:直方图与区域灰度测 ImageJ | 灰度值统计:直方图与区域灰度测量
一、整体分析框架
二、数据下载与预处理
1.数据下载
登录 GDC Data Portal(portal.gdc.cancer.gov),选择对应癌种项目; 下载两类数据:RNA-seq 表达数据(STAR-Counts / FPKM)与临床数据(含生存时间、状态、病理分期、年龄、性别); 可使用 GDC 官方工具,或 R 包 TCGAbiolinks 批量下载,效率更高。
2. 数据预处理
基因 ID 转换:Ensembl ID 转换为标准 Gene Symbol; 表达矩阵与临床信息按患者 barcode 匹配,剔除缺失值、处理重复样本; 统一生存时间单位,状态编码为 1=死亡(事件)、0=存活/删失。
三、确定目标基因与分组
目标基因可由差异表达分析筛选得到,也可直接选定研究关注的基因; 既可以把表达量作为连续变量纳入模型,也常按表达中位数将患者分为高表达、低表达两组; 中位数分组最常用、结果稳健;若使用最佳截断值(maxstat),需在方法中明确说明。
四、KM 生存分析(第一件套)
本例高表达组生存曲线明显低于低表达组,log-rank P < 0.001,差异显著; 曲线下方的 Number at risk 表给出各时点仍处于随访风险中的人数,是论文必备元素; 曲线上的短竖线代表缺失患者。
五、Cox比例风险回归(第二件套)
单因素 Cox:逐个考察基因、年龄、分期、性别与生存的关系; 多因素 Cox:将变量同时纳入,校正后判断目标基因是否为独立预后因素; HR 解读:HR > 1 为风险因素,HR < 1 为保护因素;95%CI 不跨 1 且 P < 0.05 即显著。
六、时间依赖ROC(第三件套)
本例 AUC:1 年 0.661、3 年 0.712、5 年 0.704; AUC=0.5 相当于随机猜测,0.7 左右区分能力较好,0.8–0.9 很好,越接近 1 越优; 常将基因模型与传统临床指标的 AUC 对比,证明新增基因的增量价值。
七、风险因子三联图
八、列线图Nomogram(第四件套)
先在每个变量轴上找到患者取值,向上读出对应的 Points; 将各变量 Points 相加得到 Total Points; 沿 Total Points 轴向下,即可读出该患者 1/3/5 年的生存概率。
九、注意事项与进阶建议
事件数要充足:一般要求死亡事件数达到纳入变量数的 10 倍以上(EPV 原则); 批量筛选预后基因时涉及多重比较,应关注 FDR 校正,避免假阳性; Cox 模型需满足比例风险(PH)假设,必要时用时变协变量检验; 强烈建议用 GEO 独立队列做外部验证,明显提升结果可信度与论文档次; 生信结果属关联预测,需结合分子实验(WB、qPCR、功能实验)形成证据闭环; 常用工具:R 语言 survival、timeROC、rms 包,或成熟的在线分析平台。
写在最后
本文来自网友投稿或网络内容,如有侵犯您的权益请联系我们删除,联系邮箱:wyl860211@qq.com 。

