模型免费下载,能力另说:这周 AI 圈的四次"留一手"
- 2026-11-07 10:07:20
周五下午,一个五个人的小公司群里弹出一条消息:"Kimi K3.1 Pro 权重放出来了,免费。"
有人立刻点了下载。进度条走得很慢。半个多小时后,硬盘红了。
第二天他们才算清楚:这个"免费"的模型,光文件就有 1.5TB 上下;要让它真的开口说话,官方给的最低配置是 8 张 B300 显卡,单卡显存 288GB——一张卡的钱够他们付三年 API 账单。
文件躺在他们硬盘上。模型不在他们手里。
本周这几件事
第一件:最大的免费模型公开了,但作者先剪掉了一块。
发生了什么:一家中国公司把自己最大的模型免费放到网上,但在放之前,主动删掉了它"找漏洞、写攻击"的那部分本事。
关键数字:2.8 万亿总参数、每次只叫醒 1040 亿、100 万 token 上下文;权重文件约 1.4–1.6TB,全精度版本约 5.6TB;官方给出的最低部署方案是 8 张 B300 或 8 张 MI355X(Moonshot 模型卡,2026-11-04)。被删掉的那块:未删减版在内部漏洞测试 xdev-bench-hard 上解出 90.5%,发布版 81%,上一代 K3 是 33.3%。
为什么它不只是新闻:这是第一次有公司把"我剪了什么、剪掉多少"写进发布说明。开放这个动作,第一次带上了刻度。
第二件:同一天,另一家放出来的不是成品,是半成品。
发生了什么:百度开源的文心 5.5 Flash Base,只给预训练结束那一刻的模型,后面所有的调教一概不做。它像交给你一袋面粉,而不是一个面包。
关键数字:2800 亿总参数、每 token 激活 140 亿、33.5 万亿 token 预训练、预训练上下文 128K,微调与推理阶段可到 100 万(百度官方模型卡,2026-11-05)。
为什么它不只是新闻:它把"能力"和"能力的方向"拆开卖了。原材料给你,做成什么你自己定。这是"留一手"里最体面的一种——什么都没剪,只是没做完。
第三件:一个小模型打到了同类第一,但"第一"前面必须加国名。
发生了什么:Ricursive 放出 65B 的 Ripple-65B,宣称在智能体编程测试上超过参数量十几倍的对手——不过它比的只是"美国产的"开源模型。
关键数字:650 亿参数、稠密架构、12 万亿 token 预训练、宣称 80.52(TerminalBench 2.1,厂商自述,未见独立复现)、全程研发 3200 万美元;对比表里最大的对手是 975B;Qwen 不在表内(Ricursive 发布页,2026-11-04)。
为什么它不只是新闻:称号前面开始需要加国名了。而它也证明了这周唯一一件让"自己跑"重新变得现实的事——一个 65B 的模型能装进一台桌面工作站。
第四件:另一家公司做了完全相反的选择。
发生了什么:OpenAI 没有剪掉这个本事,反而把它练到最强,然后只发给通过审核的机构。
关键数字:ExploitGym 评测 48.5%,上一代 32.1%(OpenAI 系统卡,2026-11-05);网络安全能力被评为 Critical;只对 Daybreak Red 客户开放,要求企业单点登录、多因素认证、API IP 白名单;截至 10 月接入 2000 多家机构;研究人员用它复现了 1724 个 Linux 内核漏洞、为 948 个做出可用的提权利用、找到 81 个此前未公开的 Firefox 高危漏洞(以上均为 OpenAI 自述)。
为什么它不只是新闻:这是"留一手"的镜像版本——不是剪掉能力,是剪掉人。
把它们放在一起看
四件事排在一起,会看到四个不同的动作,但都是同一个动作:
一家剪掉能力、留下权重;一家留下能力、剪掉人;一家只发半成品,把成品权留给你自己;一家全放,但把"第一"的定语收到国境线以内。
为什么是这一周?因为这几家公司同时撞上了同一件事:权重是唯一能复制的部分。
芯片不能复制——产能不是下载来的。审核名单不能复制——2000 家机构不是开源出来的。辖区更不能复制——一个模型算哪国的,不写在权重文件里。连"第一"这个称号都不能复制,它得先划定一个范围才成立。
所以"开源"这个词正在退化。它过去是一个动作,指的是一整套让外人能看懂、能改、能接着做的安排;现在它越来越像一个物件,指的就是那个 1.5TB 的文件夹。
这件事跟你有什么关系?关系在于你付的钱。
过去二十年,开源替你省钱的方式很朴素:只要有一个免费替代品存在,收费的那个就不敢乱涨价。这个机制不需要你真的去用免费版,它只需要存在。
模型时代,这个机制第一次开始松动,因为"存在"的门槛从"能下载"变成了"能跑起来"。一个 1.5TB、起步 8 张卡的模型,对 99% 的人是存在的,但不是可用的。它还能压价,只是压得越来越没底气——你很难想象用一个 65B 的模型,替掉你现在用的旗舰。
替代品还在,但它正在从"我能换过去"变成"我可以拿它谈价"。这两件事,对价格的影响差着一个量级。
深读段:那 9.5 个点是怎么没的
先看一条能核实的曲线,全部来自同一套内部测试(xdev-bench-hard,Moonshot 自己的漏洞利用题集):
Kimi K3(上一代,7 月发布):33.3% Kimi K3.1 Pro 未删减版:90.5% Kimi K3.1 Pro 发布版:81%
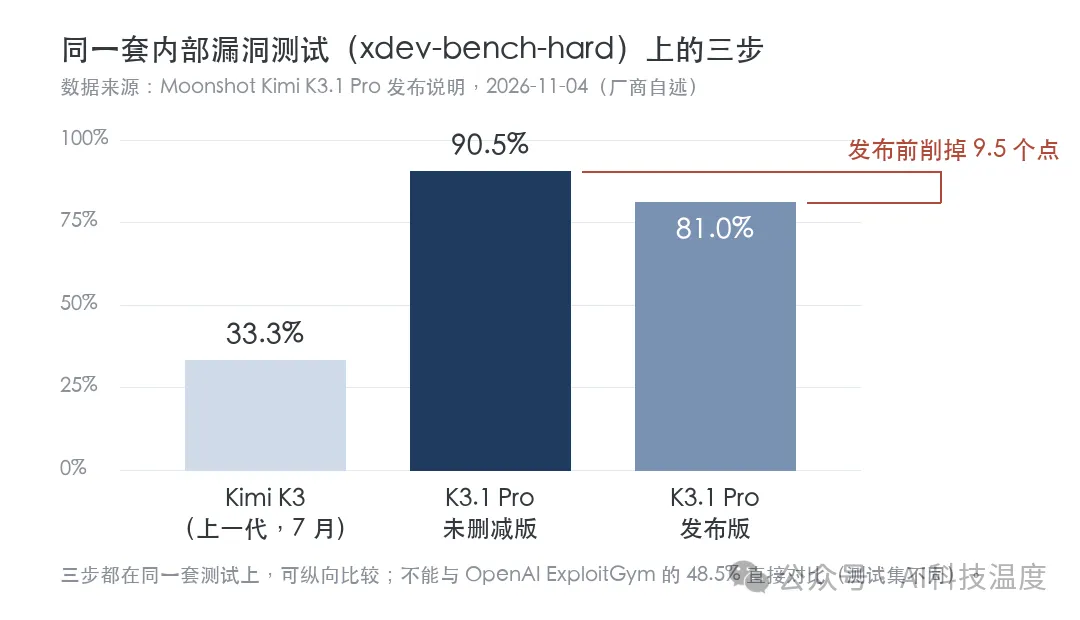
从 33.3 到 90.5,是这一代训练带来的真实跃升。从 90.5 削到 81,是发布前那一刀。削掉 9.5 个点。
对照另一边:GPT-5.6 Cyber 32.1% → GPT-6 Cyber 48.5%,涨了 16.4 个点。两家公司的动作方向正好相反,一个往下削,一个往上拉。
这里必须说清楚一件事:81 和 48.5 不能直接比。两个数字来自不同的测试集,题不一样、判分不一样。把它们放在同一张图上说"开放版更强",是拿测试差异冒充能力差异——这也是这类新闻里最常见的误读。
真正值得看的是那条削法。Moonshot 的做法不是给模型装一个开关,而是从预训练数据里删掉网络相关内容、从强化学习的环境里拿掉网络任务,同时保留一般编程能力。这是改配方,不是加锁。
所以更准确的说法是:
在 HuggingFace 上,已经有第三方仓库把 K3.1 Pro 当基座,声称用"从选定层里减掉拒绝方向、再用网络安全语料微调"的办法做一个反向版本。这个仓库目前没有上传权重,也没有任何评测结果。
也就是说:剪掉的部分大概率拿得回来,但还没有人公开证明拿得回来。这两句话差别很大,值得记住。
往后看:三个可以盯着看的信号
不做预测,只做条件推演。
如果"剪一刀再发"变成惯例,那么模型卡上会多出一栏——发布前和发布后的能力对照。到时候你判断一个开放模型安不安全,不用听发布会,看那一栏的差值就行。盯这个:下一批开放权重的模型卡里,有没有出现"未删减版本"这个词。这个词一旦普及,说明行业默认了"发布版本被改过"。
如果"按名单发"成为高能力模型的唯一出口,那么最强的模型会慢慢从公开排行榜上消失——因为上排行榜得有访问权限。盯这个:主流榜单上,前沿模型是否开始出现"未参与"的空位。空位越多,说明分发的门越窄。
如果载体继续分叉,那么"开源"的下载量会分裂成两个数字。Kimi 这套权重放出来当天,华为昇腾就宣布可以用 vLLM Ascend 和 SGLang 在 Atlas A3、Ascend 950 上推理(2026-11-05)。盯这个:官方仓库的部署文档,是否开始按芯片分列最低配置。分列那天,"开源"就正式变成一件需要选边的事。
还有一个反转条件,值得单独说:如果一台消费级机器能跑 300B 级模型(Ripple 已经证明 65B 可以进工作站),那么"剪一刀"的意义会下降。因为当基座唾手可得,能力就更多来自后面的微调,而不是前面那一刀的余量。到那时候,剪不剪就不重要了,能不能调才重要。
你可以自己验一下
不用装任何东西,不用花钱,几分钟。
一、去看那个 1.5TB 有多大。 打开 HuggingFace 上 moonshotai/Kimi-K3.1-Pro 的 Files 页面,看单个分片多大(约 17GB 一片),数一数有多少片。再把总数和你手机、电脑的容量比一下。你会对"免费"这两个字有新的手感。
二、找官方的最低配置。 在同一个模型卡里搜 "vLLM" 或 "Minimum",看它写的是几张卡、单卡多少显存。这比任何评测分数都更能说明谁能用。
三、去看一张表里少了谁。 打开 Ripple-65B 的模型卡,看它的对比表里有哪几个对手,再找找有没有 Qwen——没有。这就是"美国开源"这个词在实际起作用。
四、去看它自己怎么写那一刀。 在 Kimi 的发布说明里搜 "90.5",看它有没有主动写出删减前后的差距。写了,就说明它把这件事当成了需要交代的部分。
事实清单
已验证(一手信源):Kimi K3.1 Pro 的 2.8 万亿 / 1040 亿激活 / 100 万上下文 / 1.4–1.6TB 权重 / 官方最低 8 张 B300(模型卡,11-04);90.5%→81%→33.3% 的删减对照(Moonshot 发布说明);昇腾 day-0 支持(华为,11-05);文心 5.5 Flash Base 的 2800 亿-A140 亿、33.5 万亿 token、纯 base 无后训练(百度官方,11-05);Ripple-65B 的 65B / 12 万亿 token / Apache 2.0(发布页,11-04);GPT-6 Cyber 的 48.5% vs 32.1%、Critical 评级、Daybreak Red 准入要求(系统卡,11-05)。
厂商宣传,未见独立复现:Ripple 的 80.52 分、"成本只有十分之一"、"美国开源第一";Kimi 的 Terminal-Bench 4.0 65.7 分;GPT-6 Cyber 的 99.93% 不越权、1724/948/81 三个漏洞数量;文心的"同尺寸 SOTA"。
不清楚:Kimi 许可的附加条款到底是两条还是三条(中外报道口径不一,但都确认它不是 OSI 认定的开源许可);Ripple 宣称 100 万上下文、而实际 API 只给 16384;"2000 多家机构"里有多少仍在活跃使用;被剪掉的那 9.5 个点能否被社区稳定拿回来——有仓库、有方法,但没有权重、没有评测。
最后问一个不需要懂技术的问题:
如果"自己拥有一份 AI"需要付出代价——一块硬盘、一台机器,或者一份要签字的合同,你愿意付到哪一步?

