零基础做生信,AI辅助GEO数据下载与核对
- 2026-11-07 07:34:33
🚀 立即免费体验,专属你的AI科研小助手:https://codar.speedai.com
更多点数领取方式见主页在线客服和内测群
想用公开单细胞数据开展研究,可以先借助 AI 查找候选数据集,再下载需要的表达矩阵和注释文件。真正开始分析前,还要核对文件来源、数据类型,以及细胞和样本的对应关系。
下面以 Codar 和肺腺癌单细胞数据集 GSE131907 为例,按操作顺序完成数据准备。读完后,你应能写出明确的下载需求,找到需要的文件,并检查它们是否适合后续分析。
先说明研究问题和数据需求
打开 Codar,选择“单细胞与虚拟细胞”插件。还没有确定数据集时,可以先描述研究目标,例如:
我想检查肺癌原发组织内,成纤维细胞与 T 细胞之间是否存在可复核的 CXCL12–CXCR4 候选互作证据,请你给我推荐下合适的数据集。
这段需求交代了组织来源、关注的细胞类型和候选分子互作。换成自己的课题时,也应先写清这些条件,帮助 AI 缩小检索范围。
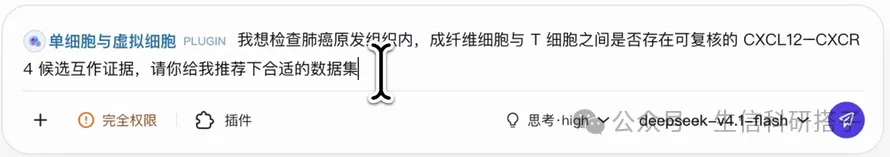
图1|在Codar中选择插件并输入研究问题。
查看推荐结果时,重点确认物种、组织、实验类型,以及是否包含需要的细胞和样本信息。如果研究限定为原发肿瘤,就需要在后续筛选中区分正常组织、转移部位和其他来源。
已经从论文中获得 GSE 编号的读者,可以直接进入下载步骤。
指定数据集并发起下载
确定使用 GSE131907 后,可以把编号、需要的文件和保存位置一起告诉 AI。下面是一段可调整使用的下载提示词:
请帮我下载 GSE131907 公开提供的 raw UMI 计数矩阵和细胞注释文件,保存到 data/GSE131907。请记录来源链接、文件名和保存路径,并说明各文件的用途。下载失败或未完成的文件请单独列出。
相比只说“帮我下载数据”,这段需求明确了任务范围,也方便之后检查交付物。大型矩阵的下载需要等待,可以让 AI 报告当前进度和最终文件状态。
本例需要关注的两个主要文件是:
GSE131907_Lung_Cancer_raw_UMI_matrix.rds.gz:UMI计数矩阵。 GSE131907_Lung_Cancer_cell_annotation.txt.gz:细胞注释表。
计数矩阵记录基因在细胞中的表达计数,注释表则提供细胞所属样本、组织来源和细胞类型等信息。两者需要对应使用。
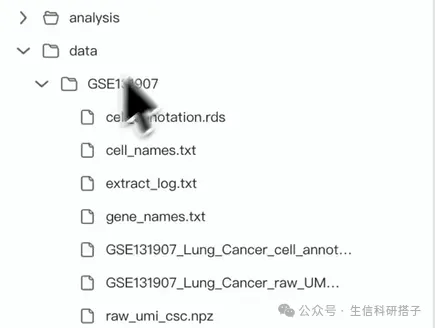
图2|GSE131907数据目录示例。目录中还包含后续整理产生的文件,核对下载结果时应以原始文件名和来源记录为准。
对照GEO页面核对文件类型
打开 GSE131907官方页面,找到 Supplementary file 区域,将本地文件与页面列表逐一对照。
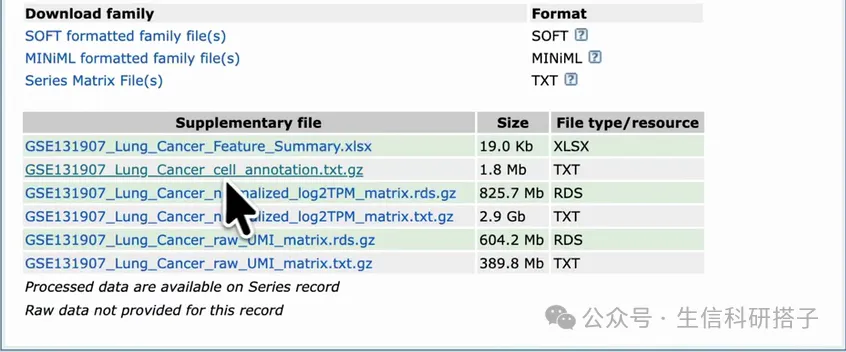
图3|GSE131907的GEO补充文件列表。计数矩阵、归一化矩阵和细胞注释分别列出。
先核对研究编号和完整文件名,再检查文件类型。文件名中的 raw_UMI 表示UMI计数;normalized_log2TPM 表示已归一化并转换的表达数据。它们处于不同的处理阶段,应根据下游分析要求选择。
原始计数矩阵与FASTQ原始测序读段要分开理解。 本例使用的是公开补充文件中的计数矩阵和细胞注释。该研究的官方记录说明,原始测序数据因患者隐私采用 EGA 受控访问,不能把下载到 raw UMI 矩阵写成取得了 FASTQ。
如果只需要从已有计数开展下游分析,可以先准备矩阵与注释;如果计划从测序读段重新处理,则需要另行确认原始数据的获取条件。
打开细胞注释并检查对应关系
细胞注释文件是压缩的文本表格,可以解压后用表格软件查看,也可以让 AI 读取表头和前几行。先保留原文件,避免检查时误改内容。
GSE131907 的注释表包含 Index、Barcode、Sample、Sample_Origin,以及 Cell_type、Cell_type.refined、Cell_subtype 等字段。它们分别帮助识别细胞、样本来源和不同层级的细胞类型。
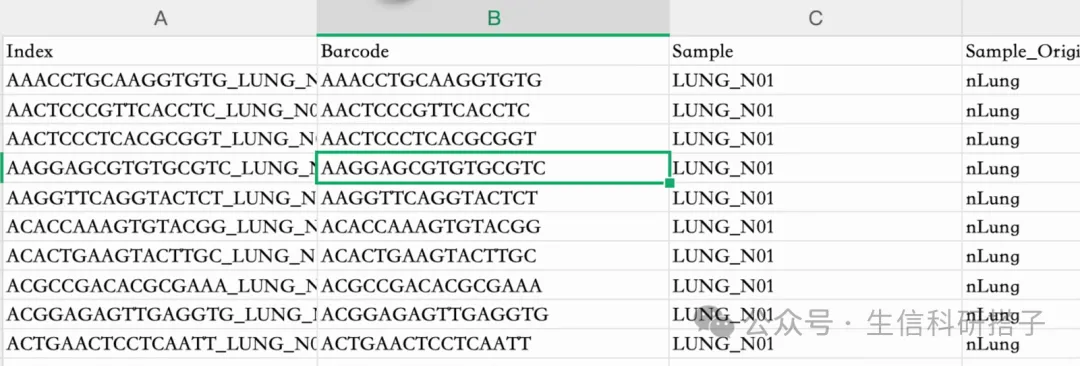
图4|细胞注释表局部,可核对Index、Barcode、Sample和组织来源等字段。
正式使用前,还需要确认注释中的细胞标识与表达矩阵能否匹配。可以继续向 AI 提问:
请检查表达矩阵的细胞标识与注释表的 Index 能否匹配,报告匹配数量、缺失或重复的标识,并列出 Sample_Origin 的取值。请先输出检查结果,不修改原始文件。
这是一项建议的检查任务。拿到报告后,应查看是否存在未匹配细胞或重复标识,并核实矩阵的行列含义。不能仅凭两份文件的排列顺序对应细胞,也不能在有缺失时直接忽略。
研究肺癌原发组织时,再结合 Sample_Origin、样本说明和论文确定筛选范围,保留所用样本的对应记录。
下载后保留一份核对清单
进入下一步分析前,检查自己是否已经留下这些材料:
数据集编号和官方来源链接。 所选文件的完整名称、用途及本地保存路径。 每个文件的下载状态和读取检查结果。 表达矩阵与细胞注释的匹配结果。 根据研究问题确定的样本筛选条件。
AI 可以协助执行检索、下载和文件检查,研究者则需要根据这些记录判断数据是否适用。取得矩阵和注释后,再安排质量检查、细胞筛选及后续分析。
对于 CXCL12–CXCR4 这样的候选互作问题,完成数据准备只是起点。是否存在支持该候选的证据,还需要相应的分析与评估。
生信科研交流群
如果你正在做生信分析,或希望将组学结果与实验验证结合起来,欢迎加入交流群,一起讨论论文里的方法怎样用于自己的课题。
交流内容涵盖生信论文阅读、数据分析、干湿实验设计与AI科研工具使用,不限于单细胞和空间组学。也欢迎分享分析中遇到的问题,讨论候选筛选、功能验证及结果解释。
扫码进群,进群后请备注「生信交流+研究方向」。

