下载三个模型,一定要占三份硬盘吗?
- 2026-10-28 15:33:37
下载三个模型,一定要占三份硬盘吗?
做本地AI的人,大概都经历过这一幕:想试三个模型,下载按钮一按,硬盘空间先报警。看到Hugging Face在10月26日公布的缓存更新,我第一反应不是“终于省空间了”,而是想弄清楚:它省的是哪一份文件?我已有的模型要不要动?
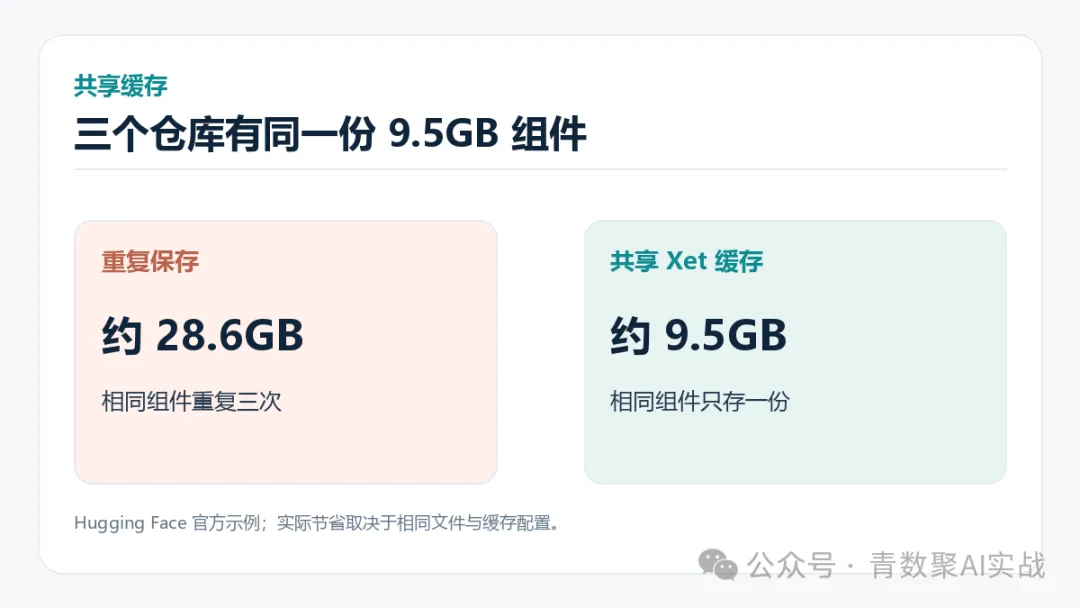
官方给了一个很具体的例子:FLUX.1-dev、FLUX.1-schnell、FLUX.1-Krea-dev三个仓库都带同一个9.5GB文本编码器。以前重复保存约占28.6GB;现在共享Xet缓存只存一份,约9.5GB,其他仓库使用链接。这个例子里,相同组件少占了约19GB。注意,省掉的是三个仓库里完全相同的文件,不是所有模型权重自动缩水三分之二。
所以我不会看到“共享缓存”四个字,就马上清空电脑里的模型目录。先把东西分清楚。
第一步:看清现在占用的是谁
如果你装了新版hf命令行,可以先运行hf cache ls。它按仓库列出本地缓存、大小和引用;想看不同版本,再运行hf cache ls --revisions。官方命令文档写得很清楚。这里先只观察,不删除。
如果你把模型另存到自己的项目目录,那份文件可能不在默认缓存清单里。此时只看hf cache ls,并不能推断整个硬盘的模型占用。先找到项目实际使用的路径,别把缓存和工作文件混为一谈。
第二步:清理之前,先看它准备删什么
新版工具提供hf cache prune,用于移除没有引用的旧版本、未完成下载等缓存垃圾。建议先运行hf cache prune --dry-run,看它预计清理的对象和空间,再决定是否执行正式命令。清理后若项目仍依赖那些旧版本,可能需要重新下载;对网络慢或离线工作的人,这也是成本。
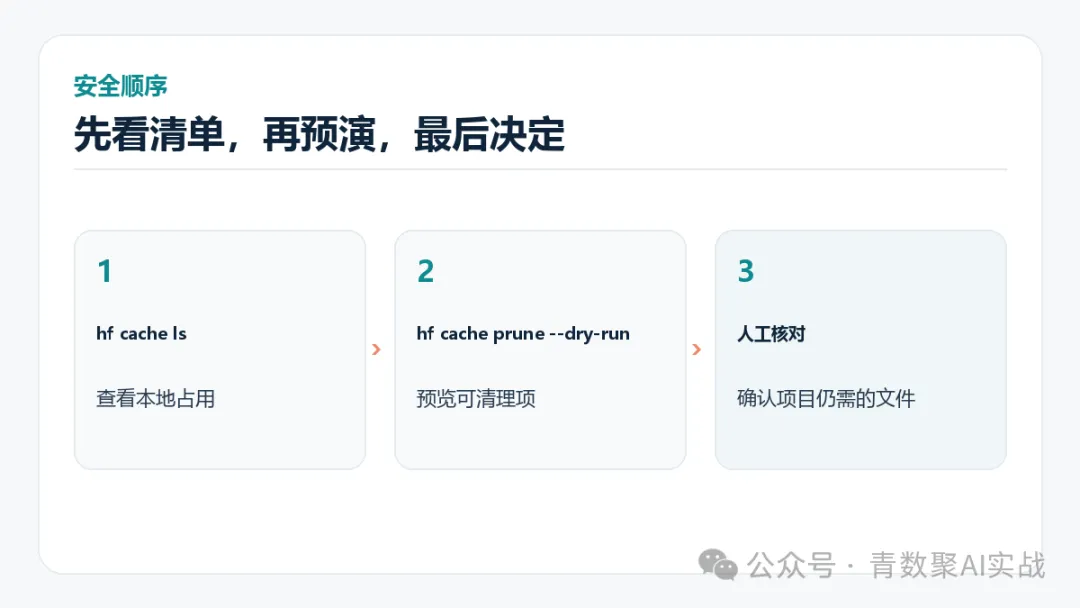
如果要删某个特定仓库或文件,官方还有hf cache rm,同样可以先加--dry-run预览。我更愿意先做预演,而不是凭一个文件夹名字直接手动删除。
第三步:别把“本地省空间”和“云上跑任务”混在一起
这次更新还讲到 Jobs、Storage Buckets 和实验性的 Sandboxes。它们是另几类功能。共享缓存讨论的是本地重复文件;云端任务与沙盒涉及独立的资源和可能的费用。想腾电脑硬盘,就先把注意力放在缓存清单和项目路径上,不必为了一个清理动作去开云端服务。
我没有在你的电脑上运行这些清理命令,也没有替你测出能省多少GB。你可以先只做下面两步,把结果记下来:
hf cache ls
hf cache prune --dry-run
真正值得高兴的,不是宣传图里的“28.6GB变9.5GB”,而是你确认了自己的硬盘上哪些是重复文件、哪些仍被项目使用,然后只动该动的部分。

