文献下载管理与综述这么做,省时又省力!!!
- 2026-10-28 15:34:37
文件夹里的 PDF 越积越多,写作时却不知道从哪一篇讲起。这种困境,通常不是因为读得不够,而是资料之间还没有建立联系。
有价值的综述,需要回答三个问题:这个领域解决了什么?不同研究为什么得出不同结果?你的课题准备从哪里继续推进?
AI 可以参与这项工作,但不宜从“替我写完全文”开始。更实用的办法,是先把检索、取舍、阅读记录和出处核对组织起来,再依据这些材料完成论述。
本文结合 literature-review-workflow Skill,介绍如何把文献检索、合法获取全文、筛选、精读、证据整理和综述起草串成一条可检查的流程。文末附全套《文献综述Skill干货包》,内含literature-review-workflow安装包及安装方法和整套可直接复制的Prompt模板合集。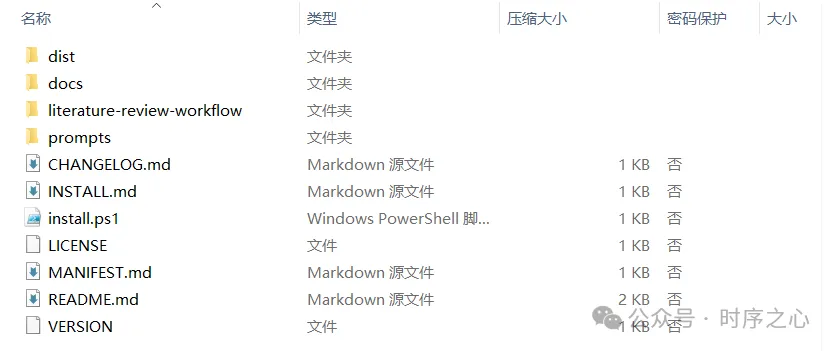
01|先明确要回答的问题,再决定读什么
开始搜集论文前,先写下一段简短说明:
我的研究对象是什么?关注哪类问题?哪些方法属于讨论范围?有哪些明确不纳入的内容?最终要形成开题综述、论文相关工作,还是专题研究报告?
这段说明相当于检索边界。缺少边界,论文数量很容易持续增加,真正有用的材料却未必变多。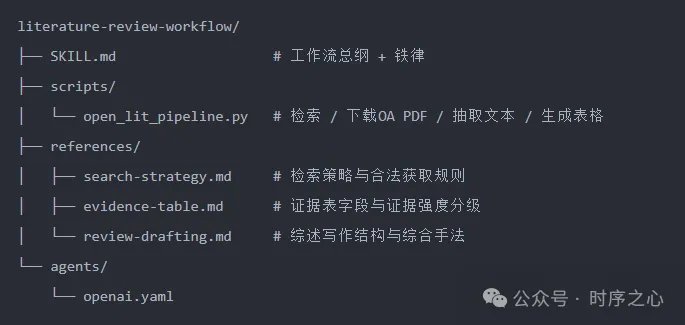
可以从与问题密切相关的代表性研究出发,沿参考文献及后续研究扩展,再结合关键词检索补充。
工具生成的关联图可以辅助发现线索,但论文之间存在联系,并不直接说明哪一篇具有奠基地位,或哪种观点已经被推翻。这些判断仍需回到研究内容。
这一阶段的目标,是形成一份有出处的候选目录,而不是立刻写出结论。
02|筛选时留下理由,比单纯打分更有用
让 AI 根据标题和摘要进行初步分类,可以减少重复劳动。但“相关性得分高”不等于“一定值得引用”。这套工作流采用两轮筛选:先依据标题和摘要标记“纳入、待定、排除”并写明简要理由;再阅读全文,确认最终纳入情况、研究类型、证据类型及与问题的相关性。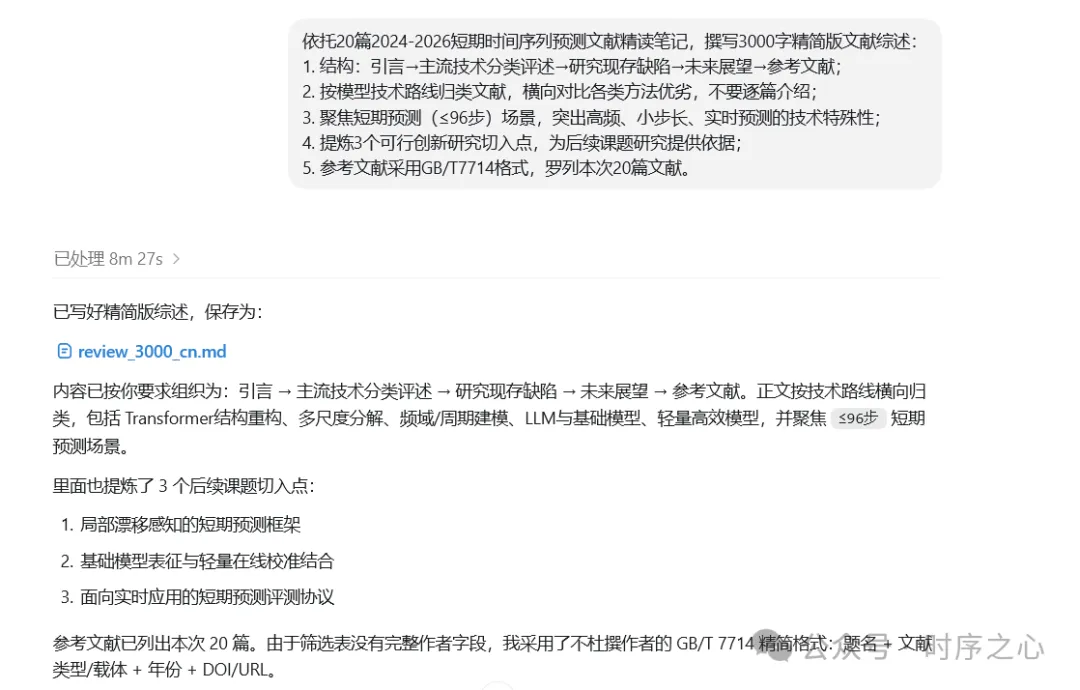
建议同时记录:
是否直接回应研究问题; 研究对象与方法是否具有可比性; 能为论述提供哪类证据; 保留、排除或待查的具体原因。
完成初筛后,再人工补查重要基础研究、必须比较的方法,以及关键词不同但思路相通的跨领域工作。
拿到全文后,还要重新判断。仅凭摘要得到的理解,可能不足以支持对实验条件和结论范围的描述。
如果使用文献问答工具,提问时应要求同时返回对应篇目和原文位置。工具给出的答案,可作为查阅入口,不能直接当作已核实的研究事实。
03|精读的重点,是发现结论成立的条件
读完摘要、记住贡献,并不等于理解一项研究。
对核心论文,可以围绕四组问题展开:
证据是否充分?
结论由什么实验或材料支持?比较对象是否恰当?有没有其他解释?
方法在哪里受限?
依赖哪些前提?更换样本、数据环境或评价方式后,结果是否仍可能成立?
哪些问题值得继续研究?
文章没有处理的部分,究竟是研究机会,还是超出了合理范围?与自己的课题有什么关系?
复现需要什么?
数据、代码、参数与处理步骤是否交代清楚?缺少哪些条件?
可以让 AI 从这些角度辅助提问,再由研究者检查证据、判断轻重。对决定研究路线的关键文献,应亲自阅读全文,并写下自己的理解。
04|把阅读记录变成能追溯的证据材料
单篇笔记负责保存细节,汇总表负责支持比较。两者结合,写作时才不必反复翻找。
每篇文献可按六项内容记录:研究问题、材料或数据、方法设计、主要发现、适用限制、与本课题的关系。
随后,把共同字段汇入证据表,并附上 DOI、稳定链接或其他识别信息。涉及重要结论时,尽量保留页码、章节、图表编号或原文摘录。
证据表是整理索引,原始论文才是核查依据。 表格里的内容如果抽取有误,后续文字也会跟着出错,因此仍需抽样检查与重点复核。
信息缺失时,标注“未报告”或“待确认”;只有摘要时,注明证据范围。不要为了让表格整齐而补全未知内容。
05|按问题组织文章,避免逐篇介绍
材料准备充分后,先搭建比较框架,再开始写段落。
可以按研究议题、技术路径或应用条件划分章节。每个部分都尽量说明:这一类研究采用了什么思路、取得了哪些进展、结论之间有哪些分歧,以及限制来自哪里。
例如,与其连续介绍三篇方法论文,不如围绕一个共同问题展开:
这些方法分别依赖什么假设?实验设置是否一致?效果差异能否直接比较?在哪些条件下,各自的优势更明显?
这样写出来的综述,才能从文献列表转向分析。
研究空白也应建立在检索与比较结果之上。发现“现有样本中较少讨论”,不能直接扩大成“整个领域无人研究”。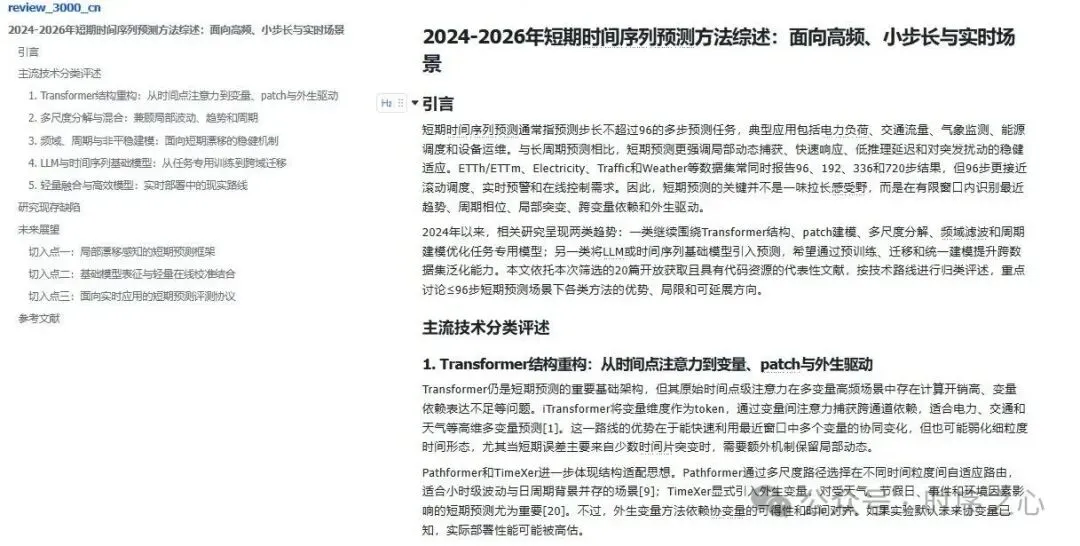
06|把重复步骤整理成 literature-review-workflow
如果经常做文献综述,可以把检索、筛选、阅读和写作要求整理成一个可复用的工作流。literature-review-workflow 可以作为这类流程的入口:从研究主题、关键词、DOI/PMID 清单或本地 PDF 开始,逐步完成资料整理、全文处理、论文筛选、精读记录、证据汇总和综述起草。
它适合批量整理论文、建立证据表、制作阅读笔记,或形成叙述性、范围性和系统综述风格的初稿。已有 PDF 时,可以从本地文件开始;只有 DOI、PMID 或检索词时,则先整理书目信息,再进入筛选环节。
建议为每个课题保留一套过程资料:检索记录、候选清单、排除理由、全文文件、文本提取结果、精读笔记、证据表和综述草稿。这样做的价值,不只是节省重复操作,也方便回溯“这篇论文为什么被保留”“这个结论依据什么”。
证据表应在综述草稿之前完成。表格中要区分已充分支持、部分支持、背景信息、存在冲突和资料不足等情况;仅凭题名或摘要得到的内容,不应直接当作强证据。正式写作时,为关键判断附上作者、年份、DOI、页码或图表位置等核查线索。
资料获取必须合规。 只处理开放获取论文、用户提供的文件或用户已经获授权使用的材料。遇到付费墙、登录限制、验证码或其他访问控制时,应记录为暂时无法获取,不尝试绕过。工具或解析依赖不足时,可以先保留书目信息,继续完成可行的筛选和记录。
固定流程能减少重复劳动,但不会代替研究判断。不同学科仍需调整检索来源、纳入标准、字段和证据评价方式;关键论文与重要引用也要人工回到原文核对。
07|交稿前,把检查落到具体位置
查文献是否真实。
核对题名、作者、年份及标识信息,并检查引用的结论是否确实出现在原文中。另一个 AI 的认可,不能代替来源核验。
查比较是否公平。
数据范围、实验条件和指标定义不同的研究,不宜只凭一个数字判断优劣。
查结构是否服务研究目标。
每一节都应为问题定位或后续论证提供支持。与目标关系不大的材料,可以删去或移入补充记录。
查判断是否仍由自己负责。
AI 可以协助提取、归类和起草,但重要文献的理解、研究方向的选择,以及最终提交的学术内容,需要研究者亲自把关。
当每个重要判断都能找到依据,每次取舍都留下理由,文献积累才会逐渐转化为可继续使用的研究基础。
文献综述学习资料,免费领取
这个skill不单单只适用于Codex,work Buddy同样适用
回复 【B678】 或 【文献综述Skill】,即可免费领取。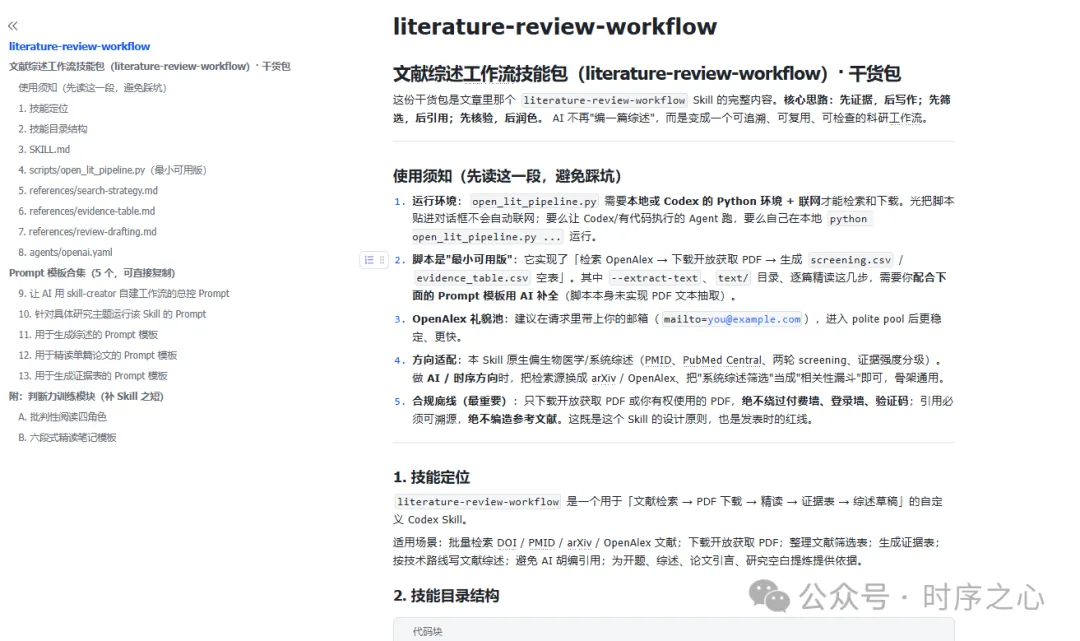
B675:Codex 配置、权限和 Skill 一次讲清楚
F424:科研写作与绘图 Skills 汇总推荐
科研小白需安装的 11 个 SKills
B716:Zotero + Obsidian + Codex 联动教程
B721:GPT(Codex)安装指南和必装skill
B740:GPT 做 PPT-全流程提示词模板(异常好用)
B869:GPT6 Astra省Token完整干货包
更多资料可以咨询小助手哦

