免费!平替Seedance!这个下载量超过gpt的AI,做视频很强.
- 2026-10-11 23:57:17
全网最细评测!其中有种视频形态只有他能做
关注我,获得AI真正落地的一手信息和经验分享
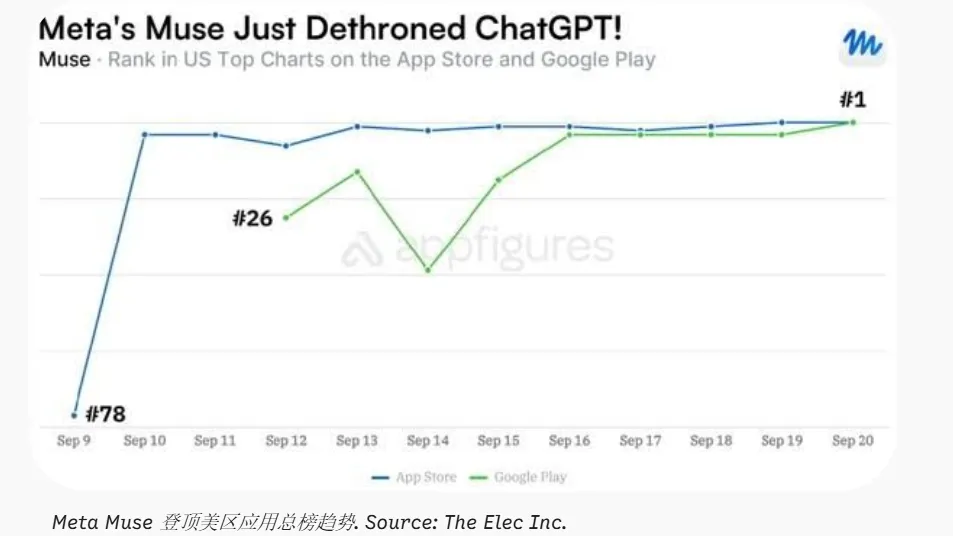
最近一个月,AI 圈最火的名字是 Muse——Meta发的个人智能体personal agent(后文简称PA)。
上线 12 天,美加 iOS 下载就冲了 180 万,比 ChatGPT 移动端首发同期还多出 50 万;全球安装量 280 万,直接登顶美国 App Store 和googleplay总榜第一。
紧接着,OpenAI也不甘示弱的发了dotsOpenAI全新Agent Dot一手实测:Plus用户看这篇就够了,加上grok的bot、manus的cue,一时间bot类助理成了当下最热门的方向。
而Muse,很快又因为他的视频能力火了一把。
作为一个云端的PA,你只需要交代任务,后面的生成,甚至剪辑、拼接以及校验,他都可以自己干,最后的成品有模有样不说,速度还快,十秒钟的视频一两分钟就搞定。
这种级别的视频,拿去做个Vlog类不是手拿把掐?
关键它还免费——每周送 1 亿 token 的免费额度。用别人的邀请码,双方各送 10 亿。
我生成一条视频,经常只掉1个点的额度,属于免费还耐用。
所以不出意外的,Muse的视频能力又被拿来和Seedance比了。平替Seedance的声音不绝于耳。
那Muse 的视频能力,到底是什么水平?真的能平替 Seedance 吗?
我把主流的视频类型挨着测了一遍,算是搞明白了Muse的脾气,以及他不太一样的提示词写法。
不废话,接下来上实测。
一、先搞清楚:它不是视频工具,是个独立的PA
用 Muse 不用打开什么工作台或者画布。
他就是一个独立的PA,还有自己单独的电脑,不用和你抢主机。
也就是你任务一下,关机走人都不影响他干活。
而生成视频的方式,就是在聊天框里跟它说话就行。
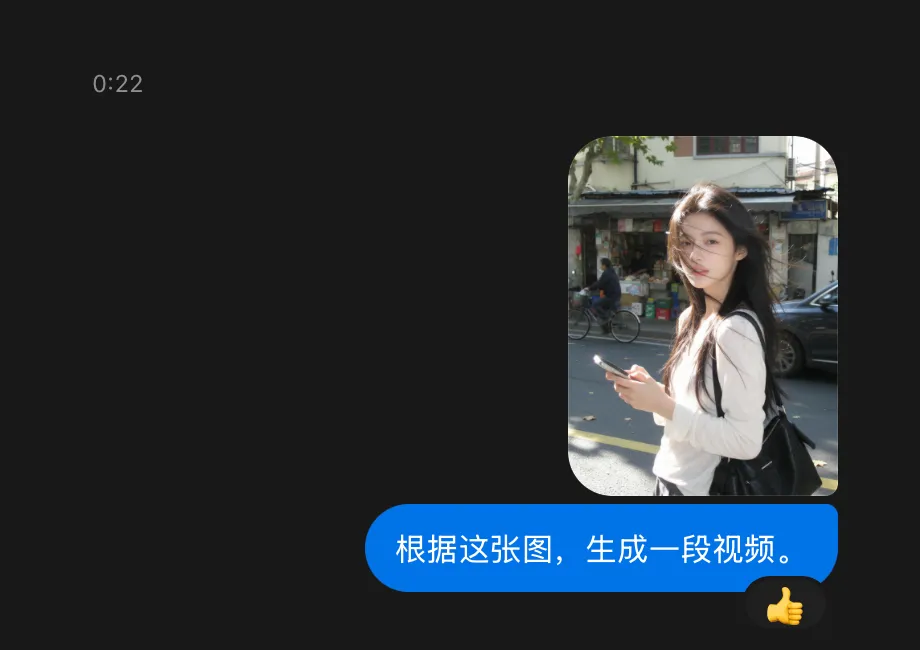
另外有三个信息点,你需要知道:
第一,不一样的时长概念。 因为Muse是PA,所以说它不像视频模型一样有默认的5秒、10秒、30秒的视频时长让你去选择。你只需要去告诉它对应的视频时长是多长就行了。但是Muse单个视频的最长时长就是10秒,而怎么去生成30秒甚至一分钟的视频?后面我会讲到。
第二,不一样的提示词框架。 很多人Muse的视频效果不好,最大问题是直接套用了Seedance的提示词。Muse的写法不太一样,这个后面也会专门讲。
第三,参数相关。 生成的视频默认是720,不支持改动分辨率。然后没有多参。准确的说,没有视频参考能力。也就意味着爆款复刻新方法,Seedance、H3都能用,最低一秒三分钱。这种方式没法用在muse上。
二、vlog、人物展示类
这是大家做视频里最经常涉及到的类型,也是这次实测里最顺的一类。
一开始的vlog类已经展示了,质量绝对过硬。
再来个垫图的视频,看看对于参考图的还原能力以及人物近景的表现。
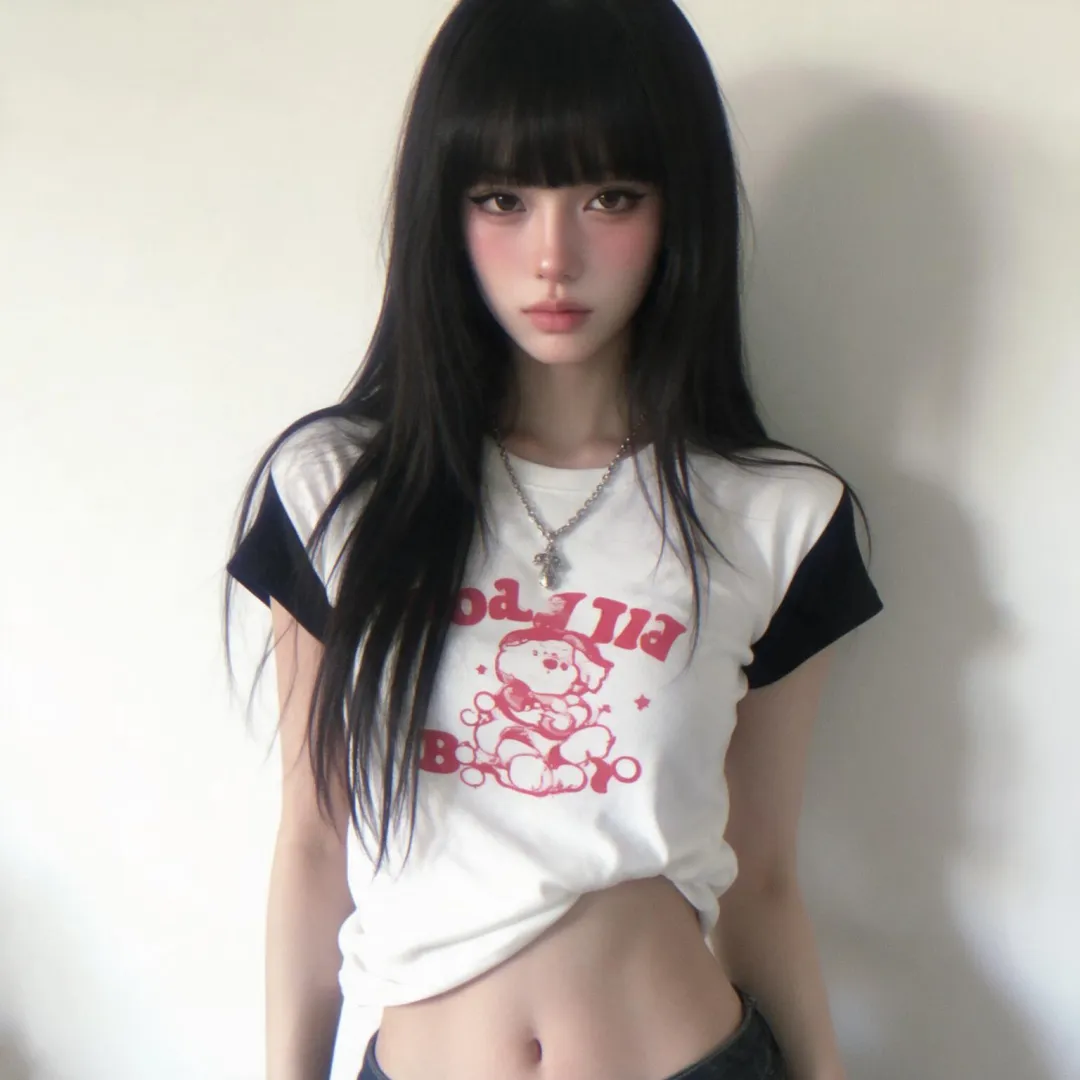
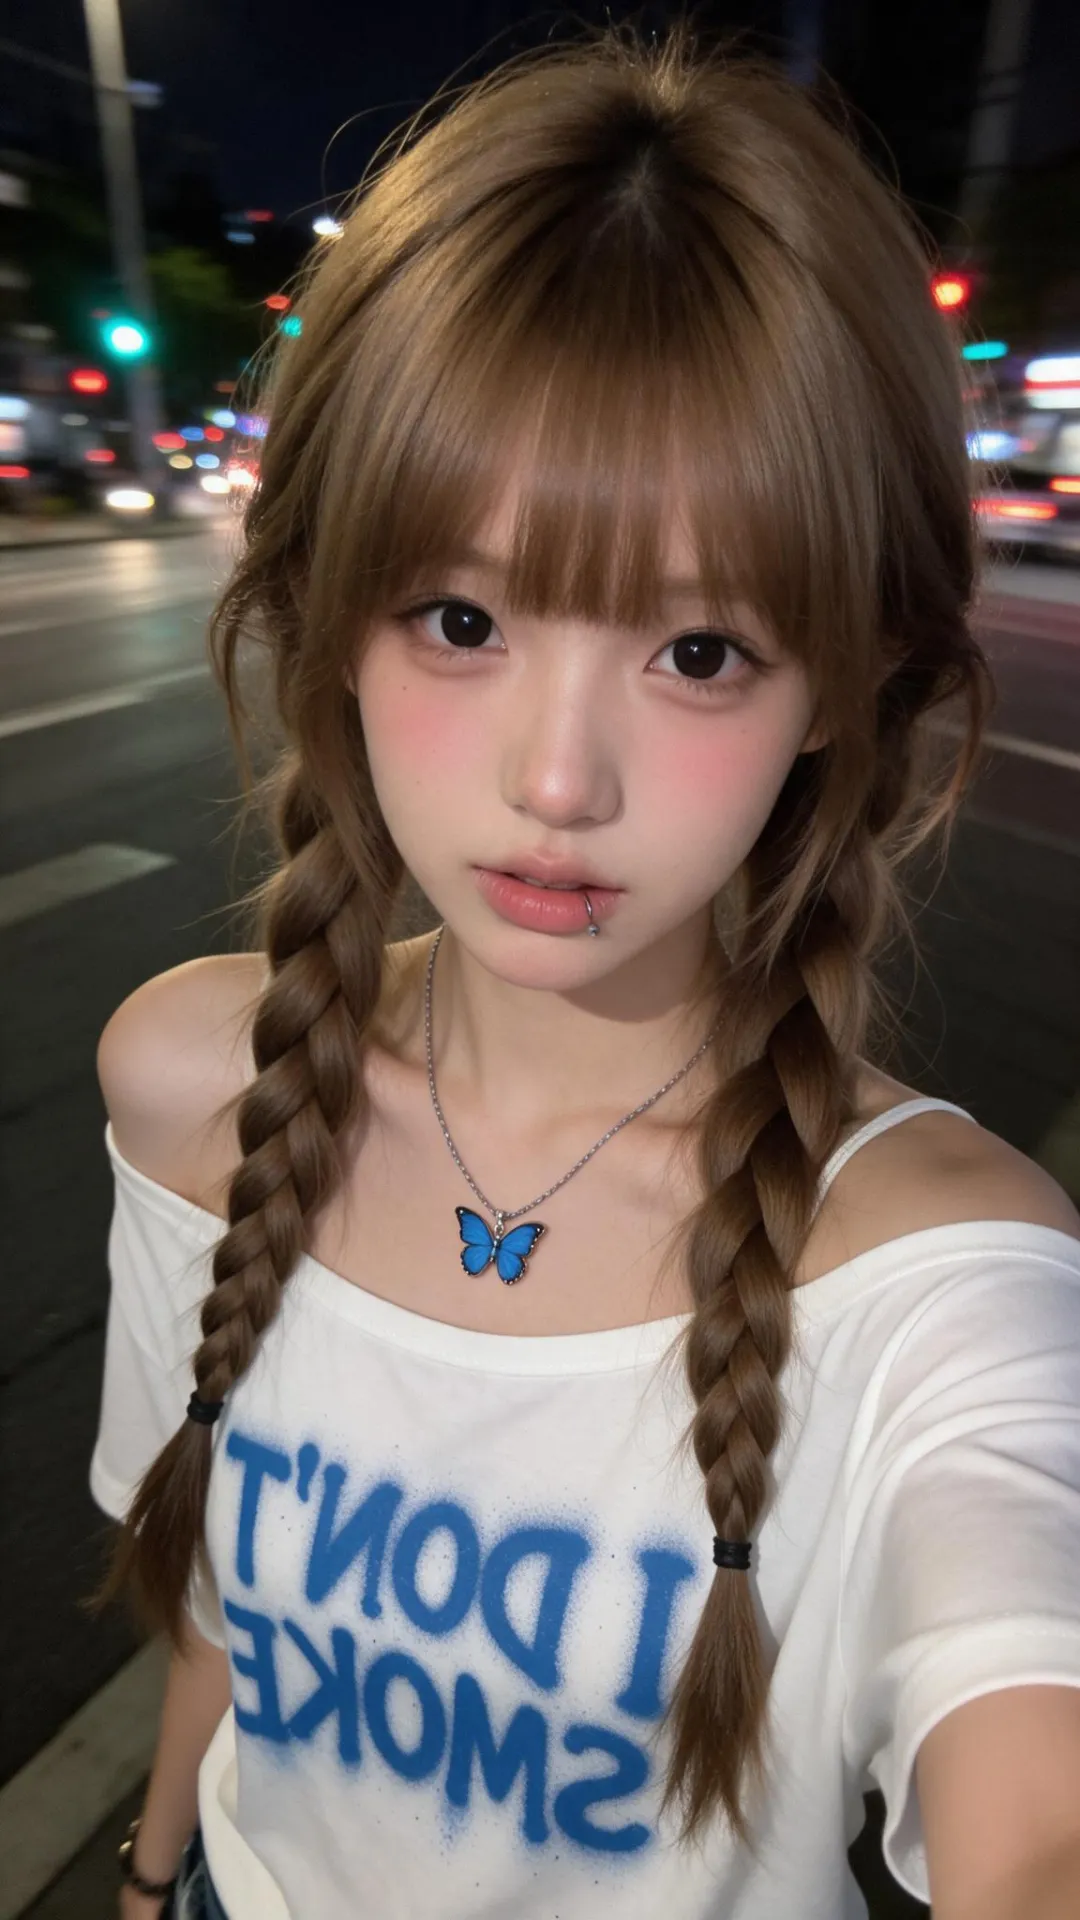
两位出场选手,来自我宣布,这轮豆包能赢GPT!
看看好看的人像对于视频的质量提升有多明显,前提是模型有足够的遵循能力。
视频二还专门多加了镜头的反复推拉和特写怼脸,呈现依然很稳。
如果有比较好的出图能力,拿去做美女起号不是分分钟的事儿。
心再黑一点,新的崩老头组合就诞生了。。。
接下来再进一步,直接和SD来比比。
一样的vlog类视频,完全一模一样的提示词。
前十秒Muse,后十秒SD mini。
不知道你们更喜欢哪一个视频,我会觉得Muse胜出。
原因很简单,在 整体表现差不多的前提下,Muse的“原生感”更好。
这个原生感不光是没有即梦脸,还有场景整体看起来没那么精美,更加的素人。
在这个层面,说句平替Seedance,不过分吧。
免费,一分钟生成,还要什么自行车?
三、电商类素材
电商类的视频其实难度很大,需要世界知识,需要对参考的良好还原,需要很强的语音表现,更需要分镜能力。
直接上对比吧,这次不光是SD mini,包括H3也拉进比较行列。
我心里的排名和视频播放顺序一样,muse第一、SD mini第二,H3最后。
Muse这段视频有一个特别牛的地方,在于他的人物和场景都很原生感,是那种一眼觉得可用的koc素材。
人物的外形,不是那种塑料感或者与现实生活略远的美人,真实而有烟火气。
更牛的在于厨房的呈现,锅旁边还有酱油和蒜泥,我不知道一个国外模型为什么对中餐吃得这么透。。。
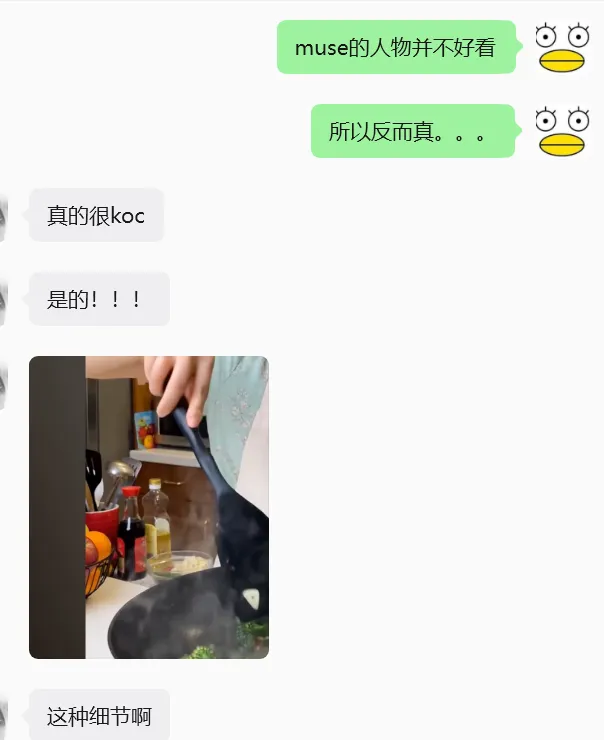
再说锅里,他是唯一一个有锅气的选手。其他两位不带冒烟的。
这种视频,是完全可以批量用在素材里的,拿去补镜头的缺失不要太爽。
而SD mini也不是一无是处,人物动作非常生动,就是即梦脸真真看够了。
而H3?真的没啥优点。
这里我要再强调一遍,Muse的“原生感”是视频模型里极其难得的能力。
AI视频要精美,非常容易,基本每家的新模型都能做到。
但看起来像素人拍的,有很强的koc感,你第一眼觉得“像我自己拿手机拍的”,这点很难。
这里我又选了三段素材,大家可以看看Muse的原生感究竟是昙花一现,还是可以做到稳定的产出。
看看视频1和3里的场景,是不是抖音里那些拿量视频的样子?
那些调味品的摆放,厨房的陈列,那些瓶瓶罐罐。。。
还有看起来“很素人”的脸。
你用提示词去还原试试?你写不出来的。
视频2,看的是商品还原和吃食物的交互。
对了,视频2、3我都可以垫图了,稳如老狗。
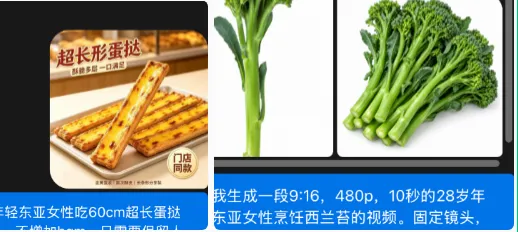
这些是不是可以作为非常好的镜头补充?
你去找koc采购又要花多少钱?
接下来的方向继续加难度,这次我是母亲三视图、女儿三视图、产品多视图都给怼上去,提示词里也加了分镜。
基本就是SD的标准了。
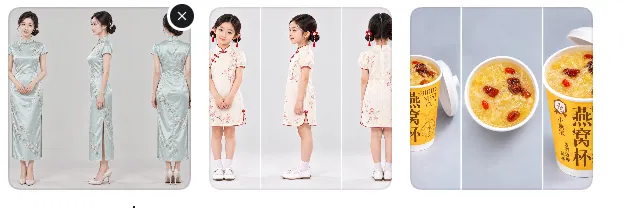
这次是Muse的车祸现场,属于刹车踏板都踩断了。也直接测出了他的短板:多人对话。
对话完全乱套,属于完全不可用那种。
竖版视频是第一次生成,我以为是沿用了SD提示词的原因,于是换成H3格式的提示词,全英文,详细注解,对参考进行详细标注。
国外模型嘛,换个思路写些。
于是有了后十秒的第二版视频。
但是结果依然没眼看,完全胡说,颇有点无厘头的喜剧感。
至于人物还原问题,是因为我自己把参考图忘记了
结合我其他类型的badcase,可以很肯定的说,Muse对于多人对话的遵循能力很弱。
所以在电商类素材上,他只适合单人口播,不适合双人对话。
但是,我又要说那句话了。
免费,一分钟生成,还要什么自行车?
何况他有的场景还真的比SD mini更好。
光一个独一份的原生感,他就是我镜头库里的一员大将。
四、分镜图参考,以及长视频
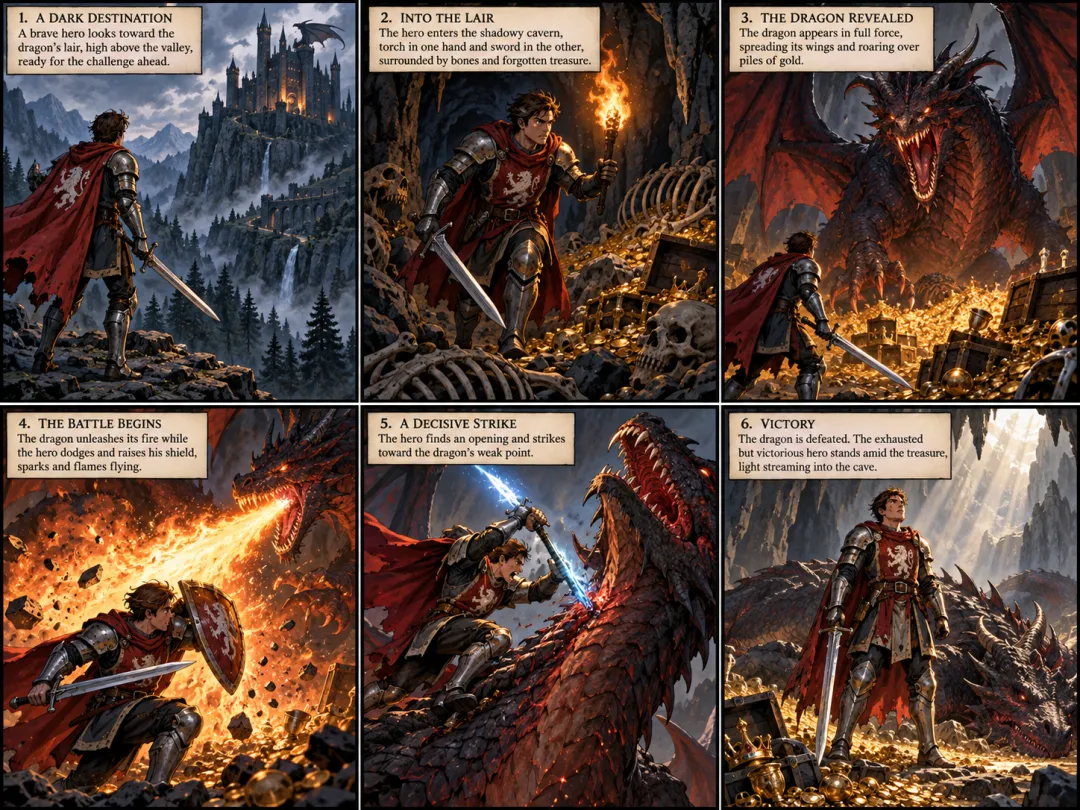
这部分,看看Muse能不能读懂分镜图,并把分镜图作为自己生成的参考。
作为多参的王,这次依然和SD mini进行下对比。前muse,后mini。
为什么不用2甚至2.5?赢了也不光彩啊。。。
整体看下来,Muse和mini各有优点。
Muse的画质更好,但还原度和分镜呈现上就被mini吊着打。而且Muse出现了明显的吞镜头情况,有两个分镜没有呈现。
既然如此,那试试长视频吧。
接下来给大家看一个非常高难度的案例,这次我直接把时间拉到了接近一分钟的时间。
整个分镜图由六张构成,一张就对应十秒。
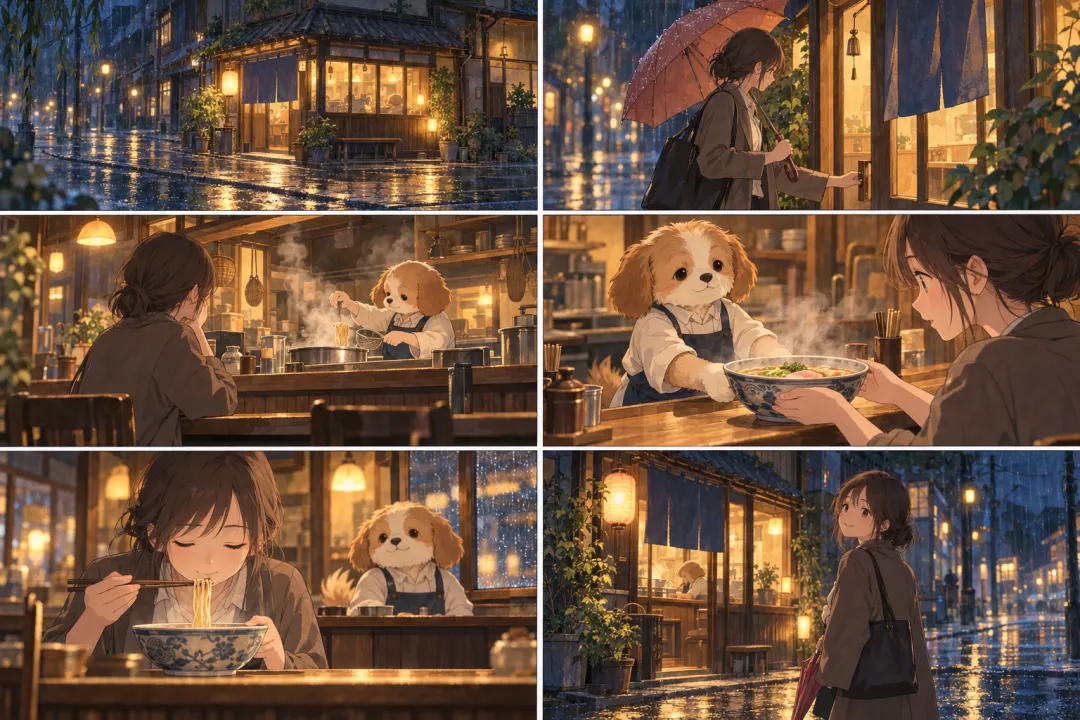
这条视频难度挺高的。因为要求长时间,模型得先拆分镜,再分别理解,再保证一致性,最后自己把视频拼一起。
但Muse交出了一张让人惊讶的答卷。
我看到这条视频是非常兴奋的,整整六十秒,完全由bot自主生成,过程中我没有做任何干预。
拆解分镜稿,先对参考的图进行理解,知道究竟要做个啥,怎么去设置运镜(我提示器没写)。
然后保持多视频的一致性,狗老板别20秒是雪纳瑞30秒是哈士奇。
前面都搞完,还得把多个片段拼接起来,形成完整的视频。
末了,再去检查视频的一致性,看看狗老板(怎么感觉像骂人)崩了没。
这些全部由bot搞定。
最终接近一分钟的视频,被稳稳的端了出来。
一个免费的模型,一个让你脱手的bot,居然做到了长视频的风格一致性。
这意味着,你做个书单号,做个解说视频,那会是非常高效且低成本的事儿。
这里也总结一下。Muse做长视频的核心,是自己把完整的叙事节奏捋清楚。
说得更加直白一点,就是你脑子里得把三十秒、一分钟的视频究竟要发生什么想明白,然后通过提示词写出来。。
长视频考验的不光模型,更是你是否能驾驭那么长的提示词,且把事儿给说清楚。
这里或许有人说你这视频也不咋地啊,节奏明显慢了,可以更紧凑,也没啥精彩的分镜。
那不废话么,我这就六张分镜稿啊。
压到三十秒的视频节奏就要好得多,那不调调提示词的事儿。
我还是那句话,
免费,一分钟生成,还要什么自行车?
五、动作类
再来是很多视频模型都搞不好的地方,打斗。
尤其是国外模型,无论是Google的omni还是grok的image,一旦涉及到复杂打斗动作都比较拉胯,没法细看。
这次的对比,又是Muse、SD mini和H3三位选手。
这里又得吹一下Muse,质量比预期的好。环境氛围呈现得很到位不说,最难的动作居然也有很稳的表现,连打击感都做出来了,这相当不容易。
对了,连背景的大量中文也准确,出乎意料。
唯一的槽点,怎么就黑哥了呢。。。
mini就不说了,再mini也是SD,除了人物质感差之外,没啥挑的。
H3这次也不错,尤其是整体画面质感特别好,就是中间的僵持部分太久了。
综合起来,我依然选Muse。因为他的动作看起来最有打击感也最连贯,雨夜的氛围也很到位。
免费,一分钟生成,还要什么自行车?
而且他还是PA,除了视频还可以做其他一堆事儿呢。
六、视频参考
这一类实测,也是最遗憾的。
我把深度视频丢给Muse,希望看看他视频参考的能力。
如果能搞定,爆款复刻这条路就通了。
Muse很诚实的在任务详情里写自己先干了三件事:验证视频、去搜图像驱动视频和姿态迁移的技能、然后生成。
结果最后出来个什么玩意呢
它自己重新编了一段。
不是迁移。是"我看了你的风格,自己编了一个"。
后面我还不死心,尝试了多种方式,但最后只能遗憾的说。
Muse没有视频参考的能力。
完全复刻这条路是没戏了,靠提示词硬搓吧。
七、Muse 的提示词到底怎么写
这段就是各位收藏本文的理由了。
很多人用Muse生成视频始终怪怪的,是因为你的提示词写得不对。
直接套用SD的提示词,效果一般都不太行。
我实测下来,有这么几个点需要特别关注。表面是提示词的写法,更深层次的,是模型自身的特点。
①不要写详细时序,直接写发生了什么。
Muse是没有时序概念。所以像SD那样0-2 秒干什么、2-5 秒干什么,对他来讲反而是信息冗余,你还要觉得他提示词遵循差。
正确写法是用类似"起初、随后、接着、最后"把动作顺序讲清楚,这种看起来不具体的写法反而效果好。
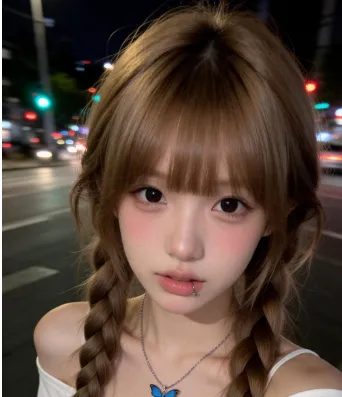
比如前面人物类的第一个视频的部分提示词,就是这么写的:
夜晚城市街头,人物站在人行道上,身后是虚化的车灯、交通信号灯和街边建筑。她一只手举着手机,镜头略高于眼睛,轻微向下拍摄,画面包含头部、肩膀与部分上身。握手机的手保持在画面外,前臂可以像参考图一样出现在画面边缘。开场,她像图一中一样看着手机镜头,嘴唇轻微张开。随后嘴唇自然合拢,轻轻眨一下眼,沿人行道缓慢走几步。镜头随着脚步产生小幅上下起伏,两条辫子和蝴蝶吊坠轻轻摆动,额前碎发被夜风吹起一点。她短暂看向街道一侧,再将目光移回镜头,嘴角露出一点轻松的笑意。空闲的手将脸侧一缕碎发轻轻拨开,随后放下。最后她稍微调整握手机的角度,让画面靠近一点,停留在自然的面部近景中结束,不突然贴到嘴唇或鼻尖。
退一步说,就算你非要保留时间点(比如"约第 4 秒切到产品"),自己心里也要清楚:
那是一个期望,而Muse未必会如你期望的按帧执行。
②双人对话,一定会乱。
虽然这里我觉得应该不是卡点,但到目前为止依然没找到让Muse能正确执行多人对话的方法。
多人对话一定会出现说话人错误——我说的是"一定",不是"可能"。
前面的电商素材也已经演示过了。需要呈现对话,直接换模型吧。
这里顺便再提一句和声音相关的,就是环境音、BGM之类的不要有太高期待,声音目前看来是Muse的弱项。
③参考图不用 @,直接发图,再告诉他图片的作用。
Muse 不像其他视频模型那样用 @图片1 引用素材。
正确姿势是:把图直接发给Muse,然后在提示词里按上传顺序写清楚——图一是什么、起什么作用,图二是什么、起什么作用:
图一用于人物外观:保持五官、发型、服装与饰品一致,不要求复现首帧构图。图二用于场景:把她放进图二的厨房环境里。④首帧不等于参考图。
Muse毕竟是一个PA,而不是单独的一个视频模型,不能去直接选择生成选项。
所以"用作人物外观参考"和"锁定为首帧"是两件事,提示词里要明确写出来。
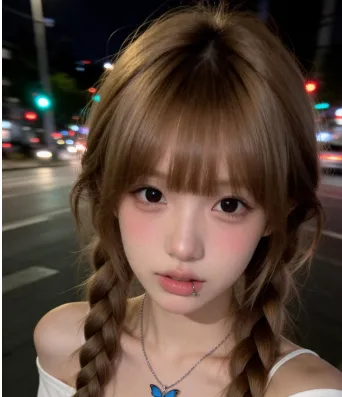
依然拿精神小妹举例。
这是参考。
参考图一,保持人物的面容、五官比例、浅棕色齐刘海与两条麻花辫、下唇唇环、蓝色蝴蝶吊坠项链,以及白色宽领短袖上衣、肩带和蓝色印花一致。而这,是首帧
从图一的自拍姿势与构图自然开始。⑤别堆砌负向。
这不光是Muse,现在能力强的新模型都是如此。
喜欢用Agent无脑帮写提示词的尤其注意,把你们那些什么“不要人物崩坏不要残影不要XXX”这种上个世纪的负向写法全部丢进垃圾桶里。
留住关键的几条就够了。
一长串"禁止这个禁止那个",反而稀释重点。
如果你依然不知道怎么写提示词,评论区打“提示词”,我把专门搓的Muse提示词skill发你。
前面你看到的每一个好案例,都来自于这个skill。
八、总结
测到现在,可以正面回答开头那个问题了。
Muse 能不能平替 Seedance?
在他擅长的领域里,能。
vlog 和人物展示,它赢在原生感;
电商素材,他作为镜头补充非常适合;
打斗视频,他的动作呈现出乎意料的好;
漫画风长视频,接近一分钟,它自己拆分镜、自己生成、自己拼接,简直不要太爽。
这些场景不只是平替,有些地方它甚至比 Seedance mini更好使。
但涉及到更多的场景,他又有着非常明显的能力边界。
所以答案不是简单的"能"或"不能",是:
他有自己清晰的地盘。
地盘里非常能打,地盘外别勉强他。
再说一个比平替更重要的判断。
Muse 不是视频模型,是 PA。
这个身份决定了它所有的好,和所有的怪。
好在哪?你交代完任务就可以脱手——拆活、生成、拼接、校验,全自己干。视频质量还挺能打。
怪在哪?时长概念、提示词框架、参数逻辑,跟视频模型全都不是一个路子。
你拿 SD 的提示词直接套,效果不好不是他不听话,是你们俩说的根本不是同一种语言。
把他当视频模型用,可能不太习惯;把他当一个会自己干活的bot,值爆了。
最后说一层,是我这轮对比测下来感触最大的。
同一个场景,我拉了 Muse、SD mini、H3 三家——结果各有胜负,没有全能选手。
这其实就是正在发生的事情:模型选型,正在变成做内容的人的必修课。
除非你的 token 无限、完全不看成本,否则"哪个模型适合干什么活",就是当前绕不开的日常功课。
对成本敏感的人,让不同的模型去适配不同的场景,是基本功。
而且也完全没有必要大炮打蚊子,你看我这不压根没把Seedance2.5搬出来嘛。
Muse 最大的意义不是多一个选择,是把"白嫖也能出好东西"的场景一下子拉大了。
以前免费意味着凑合,现在免费、一分钟生成、还能脱手。
而且他是PA啊,做视频只是他能力之一而已!
你就说还要什么自行车????
对了,Muse 的注册对很多国内用户来说,是一道门槛,一个不注意就进等待区排队去了。
本文就不探讨这个,想知道如何注册的,还是评论区打888,我发手把手的教程给你。
注册了的,也可以把你邀请码丢在评论区,这样大家都收益。
先说好,方式随时可能失效,token也随时可能减少。
早用早享受。
都看到这里了,给我来个小心心和转发吧。
本文花了相当多的时间,可以说是全网最细的Muse视频评测和指南,绝对值得拥有。

