每天下载的都叫“最终版”:我用 6 个文件跑通了 AI 改名预览和回退
- 2026-10-10 02:01:15
摘要:别把“最终版(1)”直接交给 AI 批量改名。我做了一个小微企业文件交接演练:先登记来源和业务日期,让 AI 只写改名计划,再把冲突拦下;3 份副本执行后,按清单回滚并核对内容。附可复制提示词、填好的预览表和实际操作截图。
小店交接常见这样的目录:订单汇总_最终版.csv、订单汇总_最终版(1).csv、客服话术_final.txt。同事要的其实不是“文件名变整齐”,而是下次能找对,错了能退回原样。第一个“最终版”也许是上午导出,第二个也许是下午手改;仅凭 (1),谁也不能断定哪个更晚、更准。
我以前处理项目交付资料时,真正耗时的通常不是批量重命名,而是确认来源、版本、责任人以及能否回滚。这里把这套思路缩到小微企业每天都能碰到的来件整理。下面的“青禾店”及 6 个文件都是本次作者自制样本,不是客户后台;操作、表格和截图是我在本地实际跑出的记录,不能据此宣称真实客户节省了多少时间。
先看结果:AI 提计划,人决定能不能动
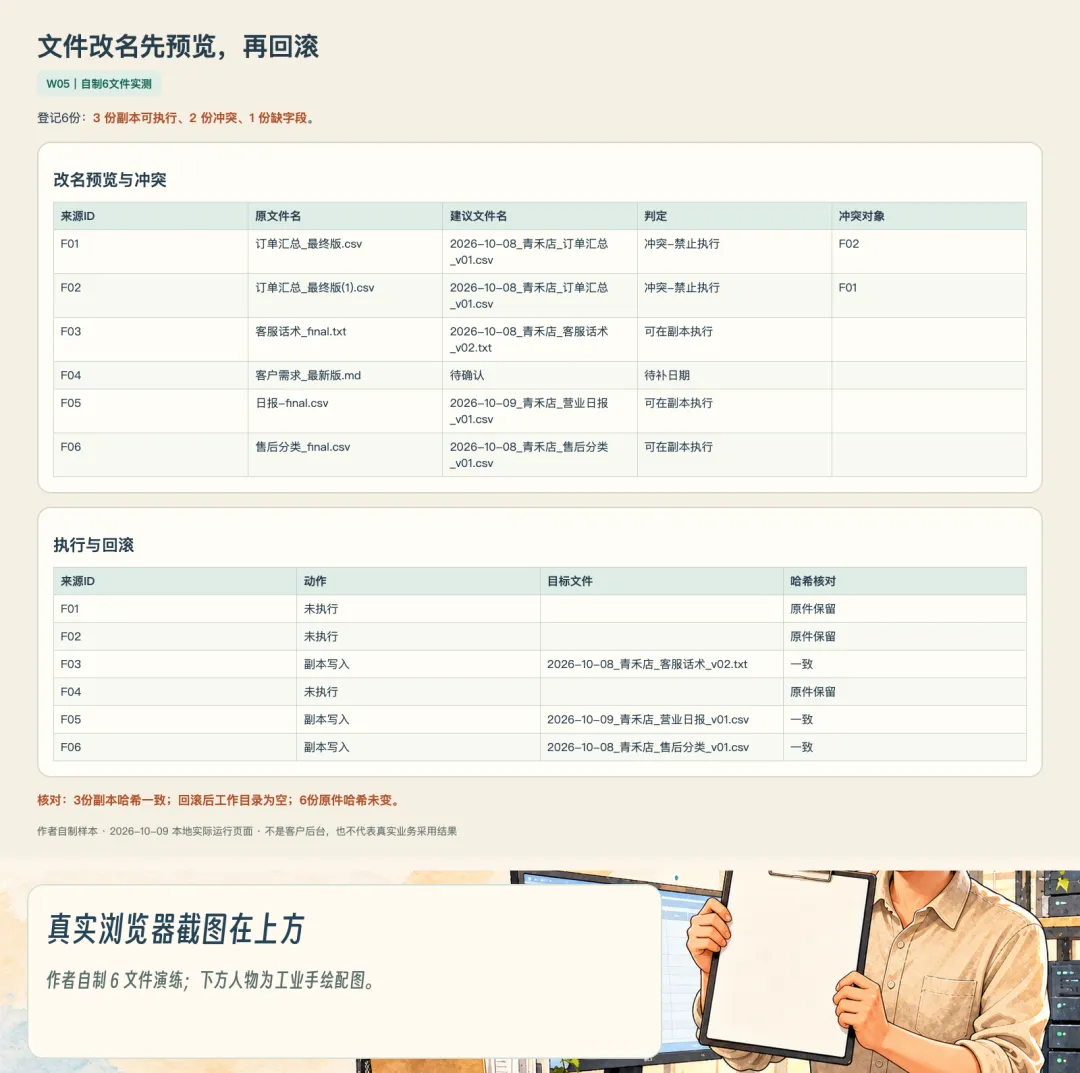
我给 6 个文件编了 F01—F06 来源 ID,另填“业务日期、项目、资料类型、已确认版本”。业务日期不等于下载时间,版本也不按文件名里的 final 猜。运行结果是:F03、F05、F06 可以在副本改名;F01 和 F02 会撞到同一个目标名,双双停住;F04 没有已确认业务日期,停住补信息。这样一来,整理的第一份成品其实是改名预览与冲突表,而非一堆改过名的文件。
2026-10-08_青禾店_客服话术_v02.txt | |||
2026-10-09_青禾店_营业日报_v01.csv | |||
2026-10-08_青禾店_售后分类_v01.csv |
一个容易漏掉的细节:F05 文件里记录的是 10 月 8 日营业数据,登记的业务日期却是 10 月 9 日。这是故意放进演练的歧义。若团队命名约定指“报表覆盖日”,F05 应先停下来改为 10 月 8 日;若约定指“交付日”,10 月 9 日才成立。不能让 AI 默默替老板选口径。本文演练把登记表里的 10 月 9 日作为本次约定输入,真实使用时应先明确“业务日期”的定义。
第一步:只登记 6 个字段,别先把文件全扔给 AI
新建一个表,列名为:来源ID|原文件名|业务日期|项目|资料类型|已确认版本。如果要让其他人复核,再加两列:版本确认人|确认依据。文件本体先留在原目录,给每个文件算一个哈希或至少记录字节数与修改时间;这不是为了炫技术,而是回滚时能证明确实没把内容换掉。
我们这次的 F01 与 F02 内容并不一样:一份订单金额是 120,一份是 125。即使目标名一样,也不能“保留后下载的那份”,更不能让脚本覆盖前一份。先问来源人:两份分别从哪个系统、哪个时间点导出?125 是修订还是误改?必要时把两个文件都保留,改用已确认的批次号或版本号,重新出计划。
还有一条隐私边界:让 AI 规划文件名只需脱敏的登记表,通常不需要把客户名单、订单明细和合同原文上传。若文件名里带姓名、手机号、订单号,先换成 F01 这样的来源 ID。AI 不碰文件本体,也就不会因为建议错了直接改坏原件。
第二步:复制这段提示词,只让 AI 输出“计划”
把下面的方括号换成自己已核对的字段;如果还没有确认日期或版本,留空。请保留最后的硬边界,它决定 AI 是整理助理还是“自信的批量破坏器”。
你是小微企业文件交接助理。你只能依据下方脱敏登记表生成“改名预览”,不能读取、移动、覆盖、删除或实际修改任何文件。命名格式为“业务日期_项目_资料类型_已确认版本.原扩展名”。业务日期必须使用登记表的已确认值,不能从下载时间、文件内容日期或文件名猜测;版本不能把 final、最新版、(1) 当成 v01/v02。输出表格列为:来源ID、原文件名、建议文件名、命名依据、缺失字段、冲突来源ID、判定(可在副本执行/待补信息/冲突禁止执行)。目标名相同的所有行一律判为冲突,不能任选其一。最后列出副本执行前的人工核对清单,以及回滚表所需的来源路径、目标路径、原文件哈希、执行人和执行时间。若有不确定项,写“待确认”,不补造。登记表:[粘贴脱敏 CSV 或表格]。
AI 可能给出“看起来合理”的名字,但人的复核至少做三件事:逐行对照登记表;按目标名排序找重复;再问“业务日期”的口径。AI 候选不等于批准改动。如果它给 F04 补出某个日期,或者把 F02 的 (1) 自动改成 v02,这一轮候选就退回重做。
这次我确实让 Codex 基于自制登记表整理了一版候选,保存为 W05_Codex候选改名预览.md。它列出 F01/F02 双冲突、F04 缺日期,并未直接操作文件。随后我用独立的本地规则程序计算目标名、复制副本、验哈希和回滚。截图证明的是后者的实际运行;不是 AI 聊天窗口截图。这样分开留痕,才能看清 AI 的建议是否真的被执行前核对过。
第三步:先在副本执行,再做一次真回滚
我这次的顺序是:原始目录只读留存 → 按计划复制 3 个已通过文件到工作目录并赋新名 → 逐一比对副本与原件的 SHA-256 → 根据清单删除本轮生成的 3 个副本 → 再确认原始 6 份文件哈希没变、工作目录为空。这叫一次可回退的本地演练,不是生产系统自动化上线。
为什么只清理“本轮生成的副本”?因为工作目录可能有同事刚放进去的新资料,不能把“回滚”写成“删除整个目录”。实际生产中还应记录执行批次 ID 和操作者;若有人在执行后又编辑了目标文件,回滚前须先隔离并人工确认,不能直接覆盖或删除。
本次运行记录:输入 6 份;3 份进入副本;2 份目标重名被拦;1 份缺日期被拦;3 份副本与原件哈希一致;回滚后工作目录为空,原始文件哈希仍一致。这个结果只证明这组自制文件和这次本地流程,不证明换一个团队的命名口径也自动正确。
直接拿走:交付给同事的两张表
第一张叫“改名预览表”:来源ID|原文件名|建议名|依据|缺失信息|冲突对象|能否执行|复核人。看表时先筛“冲突”和“待补”,不要只盯着“可执行”。第二张叫“回滚清单”:批次ID|来源ID|原路径|副本目标路径|原哈希|执行时间|执行人|执行后哈希|回滚动作|回滚后复核。这两张表比一句“AI 帮我整理好了”更能让下一位同事接得住。
如果你不用脚本,5—10 份文件可以手工做:复制一个演练目录,在表里先写建议名;按目标名排序;只改“可执行”行;改完逐个打开核内容;试着按清单撤销。文件一多,才考虑让确定性脚本做复制与哈希校验。AI 负责建议和列缺口,脚本负责机械执行,人负责口径与例外。
什么时候要停手?我用这 5 条做验收
业务日期、版本或资料类型任一字段无依据,先停,不猜。 两份文件指向同一个目标名,两个都停,不覆盖。 原文件和副本的内容哈希不一致,暂停,查复制链路。 回滚清单缺执行批次、路径或操作者,不做批量动作。 有人已经编辑过副本,先隔离人工确认,不按旧清单一键删除。
你今天就能试:从下载目录复制 5 份无敏感信息的小样,给它们编 F01—F05,填登记表,把上面的提示词发给 AI,只收一张预览表。先故意放一个缺日期和一个同名冲突,看它有没有停住。如果这两种异常没被拦住,别进入批量执行。
评论区可以只写“你最常遇到的文件名+卡住的字段”,例如“最终版(1),不知道哪个日期算业务日期”。我会按实际卡点继续补一份可复用的登记模板和冲突处理样例;不要贴真实客户资料。
证据说明:配图中的人物和工作台是工业手绘创作;表格与浏览器截图来自作者 2026-10-09 在本地运行的自制演练。文中无真实客户后台截图、真实客户采用率或节时数据。

