HF趋势榜诡异一幕:531赞0下载的Qwen-2.5-1B上榜
- 2026-09-23 06:52:08
1. 531个赞、0次下载,Qwen-2.5-1B-RLCD凭什么冲上HF趋势榜?
打开 Hugging Face 趋势榜,你大概率会愣一下。榜首挂着一个叫 harshatheg/Qwen-2.5-1B-RLCD 的模型,获赞 531,下载量却是 0。旁边随便一个动辄几万下载的老牌模型,反而被它挤到了后面。
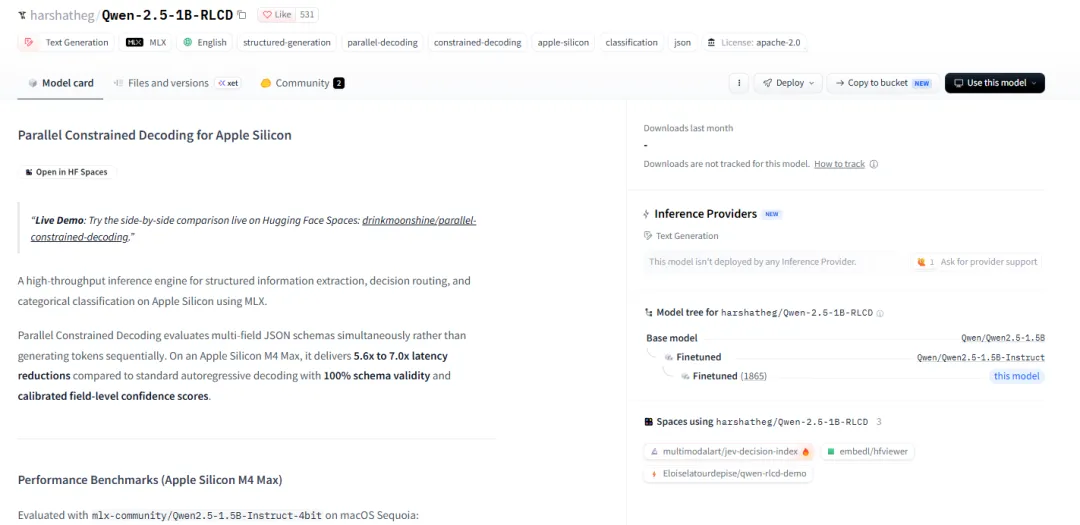
这事儿要是发生在别的排行榜——比如某电商平台的"销量榜第一"结果显示销量是0——你大概率会觉得这个榜单出了bug,或者被刷了。但技术人有个天然弱点:看到"HF趋势榜首"这几个字,本能地就会觉得"这玩意儿肯定有点东西",然后点进去、clone下来、花一下午研究。
有开发者在评论区调侃:"又是一个我花了两小时看完,最后发现自己也不知道图啥的模型。"
这篇文章不是来夸它的,是想借着这个诡异的数据点,把 HF 趋势榜的算法逻辑 和这个模型页面本身藏着的几处矛盾一次性扒给你看。看完你再决定要不要点 clone。
2. 拆解算法与命名迷雾:RLCD是什么,Qwen-2.5-1B为何长着1.5B的骨架?
先说 HF 趋势榜怎么算的。业内基本共识是:trending 排序不是按绝对下载量,而是按近期点赞/关注的增速加权。这意味着一个模型只要在短时间内被小圈子集中点赞,哪怕绝对下载量是0,也能在算法眼里"看起来在爆发"。换句话说,趋势榜衡量的是"热度斜率",不是"热度体量"。这也是为什么会出现"531赞、0下载"这种反直觉组合——很可能是某个社群、某次分享、甚至作者自己短时间内集中带来的点赞脉冲。
再看模型名字本身。标题写的是 Qwen-2.5-1B-RLCD,但元数据里 base_model 明确标注为 Qwen/Qwen2.5-1.5B-Instruct——1B 和 1.5B,命名和实际基座对不上。RLCD(Reinforcement Learning from Contrastive Data,对比数据强化学习)本身是个介于 SFT 和 RLHF 之间的轻量对齐思路,此前多用在 7B 以上模型,用在 1B 级小模型上确实是个值得关注的方向,但这个模型页面的正文内容,几乎没有展开讲 RLCD 训练细节,反而大篇幅在讲一个叫"并行约束解码(Parallel Constrained Decoding)"的推理引擎——这是两件完全不同的事:一个是训练方法,一个是推理加速工程。标题挂着RLCD,正文讲的是解码引擎,这种"货不对板"本身就值得打个问号。
更值得留意的是仓库地址。原文给出的 git clone 地址是 github.com/your-org/parallel-constrained-decoding——your-org 是明显的占位符,不是真实组织名。也就是说,这个所谓的开源工程,目前连一个可验证的官方代码仓库都没有确认存在,只有 Hugging Face Spaces 上挂了一个 drinkmoonshine/parallel-constrained-decoding 的演示空间。
3. 五分钟本地起效:MLX环境下跑一遍"并行约束解码"的最小示例
抛开命名争议,这个仓库里描述的并行约束解码技术本身是有实打实的代码可以验证的,值得单独说一说。它的核心思路不复杂:结构化生成场景(比如让模型判断"工单优先级""是否需要升级处理")里,答案往往是从几个固定选项里选一个,根本不需要一个字一个字往外蹦。于是它把 上下文只 prefill 一次,KV 缓存广播给所有字段并行判断,每个字段只在自己的候选词表里"切一刀"选最大概率项——相当于把"逐字造句子"改成了"选择题多选并联作答"。
想在苹果电脑上本地试试,前提是 Apple Silicon(M1/M2/M3/M4系列)+ macOS 14.0+ + Python 3.10+。安装步骤如下:
📋 一键复制命令
git clone https://github.com/your-org/parallel-constrained-decoding.gitcd parallel-constrained-decodingpython3 -m venv .venvsource .venv/bin/activatepip install -r requirements.txt最小调用示例(原文给出的代码骨架):
python
from core.schema import StructuredSchema, FieldDefinitionfrom core.engine import run_parallel_generationschema_dict = {"priority": {"type": "enum","choices": ["P0_CRITICAL", "P1_HIGH", "P2_NORMAL", "P3_LOW"],"description": "Urgency tier based on customer business impact" }}schema = StructuredSchema(schema_dict)context = "Production database CPU at 100%, payment gateway failing."result = run_parallel_generation(context, schema)print(result["parsed_json"])踩坑提醒:requirements.txt 之外还有 requirements-mlx.txt 和 requirements-spaces.txt 两个版本,装错依赖大概率直接跑不起来;这跟"效果不好"是两种完全不同的失败模式,遇到报错先别怀疑模型本身。
4. 数据说话:并行约束解码 vs 标准自回归JSON模式 vs 云端API结构化输出
原文给出了自己在 Apple Silicon M4 Max 上、用 mlx-community/Qwen2.5-1.5B-Instruct-4bit 跑出的对比数据(注:此数据源自项目自身 benchmark,未经过独立第三方复现验证):
| 并行约束解码(本模型方案) | ||||
| 标准自回归JSON模式 | ||||
| 云端API结构化输出 |
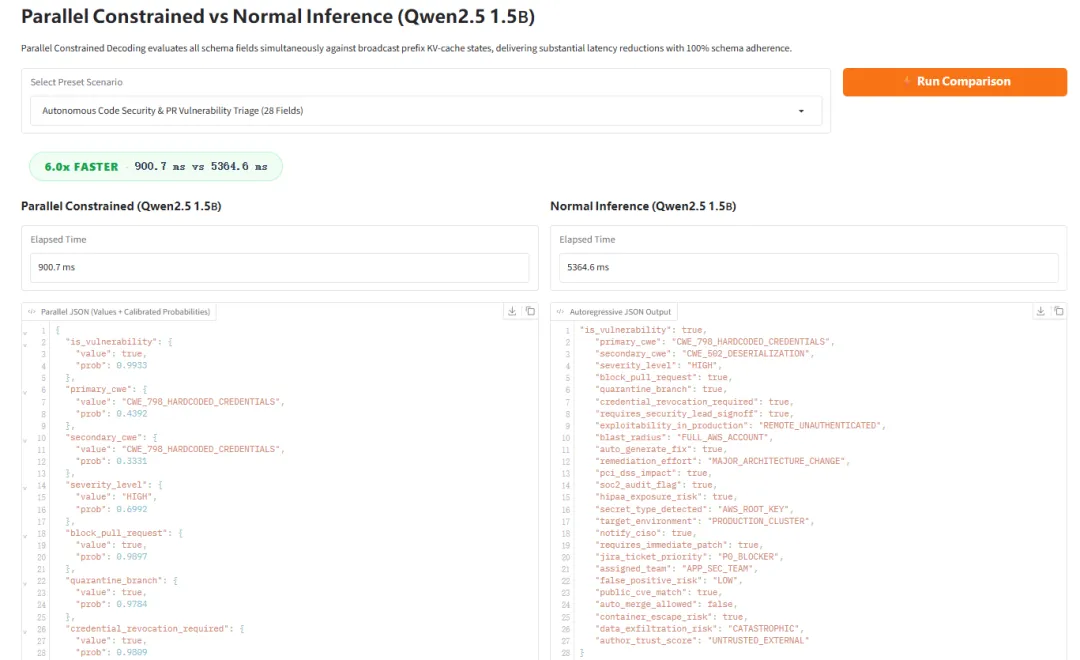
这张表说明的问题是:并行约束解码打的是"固定选项场景下的极致低延迟",不是通用生成能力。企业工单分类、风控路由、关税编码判定这类"选择题式"任务,它确实有硬核加速空间;但一旦任务不是"从有限选项里挑一个",这套方案就完全用不上,它的适用边界比自回归JSON模式窄得多。
5. 趋势榜的"热度"和你钱包的"价值"根本不是一回事
说句难听的:HF趋势榜从来衡量的都是"斜率",不是"存量"。一个0下载的模型能冲上榜首,恰恰证明了这套排序机制对"小圈子脉冲式点赞"毫无免疫力。你以为自己发现了下一个爆款,实际上可能只是踩中了几十个人同时点了个赞的时间窗口。
给你一套三秒验伪清单,以后刷到任何"趋势第一"的链接,先别急着clone:
查下载量,跟点赞数是否严重不成比例; 看模型标题跟 base_model元数据是否对得上(本例就对不上);查仓库地址是不是占位符( your-org这种一眼假的名字直接pass)。
对独立开发者来说,并行约束解码这个技术思路本身值得记一笔——固定选项分类场景确实是个能落地的甜蜜点,你完全可以自己动手在通用推理框架里复现这套"logit切片"逻辑,不需要迷信这个来源存疑的仓库。但这个具体模型页面,目前更像是一个挂着热门标签、蹭上了趋势算法漏洞的半成品展示,不是什么"开源黑马"。
热度是别人给的,价值是你自己验的。下次朋友甩给你一个"趋势第一"的链接,先问一句:下载量多少?再决定要不要打开电脑。
—— We-Nexus ——
觉得有点意思?点个「推荐」,转发给同行老哥。

