下载 DeepSeek、Kimi 大模型的公开权重,能查出它们用什么芯片吗?
- 2026-11-20 02:35:45
一家公司不说自己用什么芯片训练模型,外人能查出来吗?
前几天,研究者 Will DePue 在 Unemployment Labs 发布报告。答案是能,但只能查到一部分:初始化那一步用过什么硬件。不需要内部消息,只要把公司自己公开发布的模型权重下载下来,算一遍。
报告点名了 DeepSeek、Kimi、MiniMax 和蚂蚁的部分模型,认为其中能读出英伟达 Blackwell 架构初始化时留下的痕迹。
比"谁用了什么卡"更值得问的是:一份人人都能下载、重算一遍的文件,凭什么让怀疑者闭嘴?
一、一串随机数,怎么变成"出生证明"?
大模型有几千亿个参数,训练前要先填一层由随机种子生成的初始数字。种子相同、规则相同,就能复现同一串数字。
麻烦出在并行:GPU 把填数分给大量线程,同一串随机数落到矩阵的位置,取决于芯片有多少计算单元。像同一副牌交给不同人数去发,牌没变,排列变了——发牌的人数,决定了每张牌落在哪。
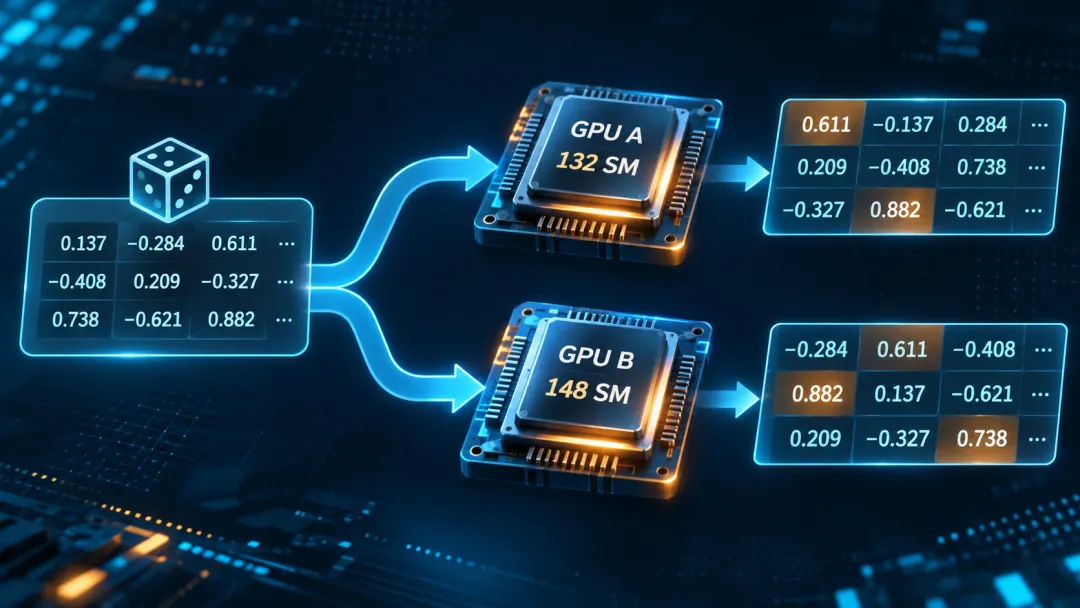
Hopper 架构的芯片(如H100/H200) 是 132 个流式多处理器(SM, Streaming Multiprocessor),Blackwell B200/B300 是 148 个,GB200/GB300 是 152 个。三个数字不必记,只要知道:计算单元数量不同,随机数的排列就不同,芯片的组织方式也就这样写进了模型文件。
训练会改掉绝大多数初始值,但总有些行几乎没被梯度碰过——比如语料里从没出现过的词,参数可能原样冻结。研究者就从这些残留倒推种子和线程布局。
二、试了 6 万亿次,为什么反而更该怀疑?
报告提到搜索约 6 万亿种"种子 × 布局"组合。这个数字最该解释的地方在风险,不在算力:只猜一次猜中很稀奇,允许猜上万亿次,总会有几个看起来很像的答案。
试得越多,"碰巧"就越像必须被排除的对手,而不是可以忽略的客气话。
研究者做了两件事。
一是估算这是纯属巧合的可能性:这么大的搜索范围里,纯巧合的概率大约是 8 个标准差(约 3×10⁻¹⁶ ),在统计学里已经是“几乎不可能靠巧合发生”的级别。
再看实测结果:报告里最弱的一项检验也有 20 个标准差,连表现最差的那次都远远高过运气的上限。
打个比方,8 个标准差大约相当于从全中国人口里随机抽一次就抽中某个特定的人;而 20 个标准差,相当于从全宇宙所有原子里随机抽一次就抽中指定的那一颗——比前者还要小 70 多个数量级。
所以从统计学上看,这批结果不是靠巧合蒙出来的。
二是留出验证:用一部分权重找答案,再拿没参与搜索的另一部分对账,相当于按半张卷子找规律、再预测另一半。
另一条独立的证据是真机复现。研究者在真实 B300 上用找到的种子重新初始化 DeepSeek-V4-Flash,469 行里有 461 行高度匹配;种子改一位,匹配就消失。
还有一层解释:某些 AMD GPU 经特殊配置也能模拟同样的线程布局——377 个可区分位置里,有 363 个与 NVIDIA 一致,无一与 AMD 一致;不过这项逐项排除只针对 V4-Flash,其余模型未做同样检验。
6 万亿这个大数字本身说明不了什么;真正让报告站得住的,是它从统计学的角度认真处理了"碰巧猜中"的可能性。
三、那到底读出了什么?
报告显示,DeepSeek 的部分早期模型留下 Hopper 痕迹,V4-Flash 匹配 Blackwell B200/B300 布局;Kimi 从 K2.5 到 K3 出现类似变化;MiniMax M3、蚂蚁 Ling-3.1-flash 也有新布局特征。
另有一批模型只找出了较老的 Hopper 类布局,包括部分千问、智谱、腾讯、小米和阶跃。而美团 LongCat-2.0 和某个版本的 DeepSeek-V4.1-Flash,则没有可识别出来的 GPU 布局。
四、最容易多走的一步:初始化 ≠ 全部训练
模型完全能先在一种 GPU 上初始化,再搬到别处继续训练。车架在甲厂造好,不一定代表整车都在甲厂装完。技术上这个解释成立,单靠权重无法排除。
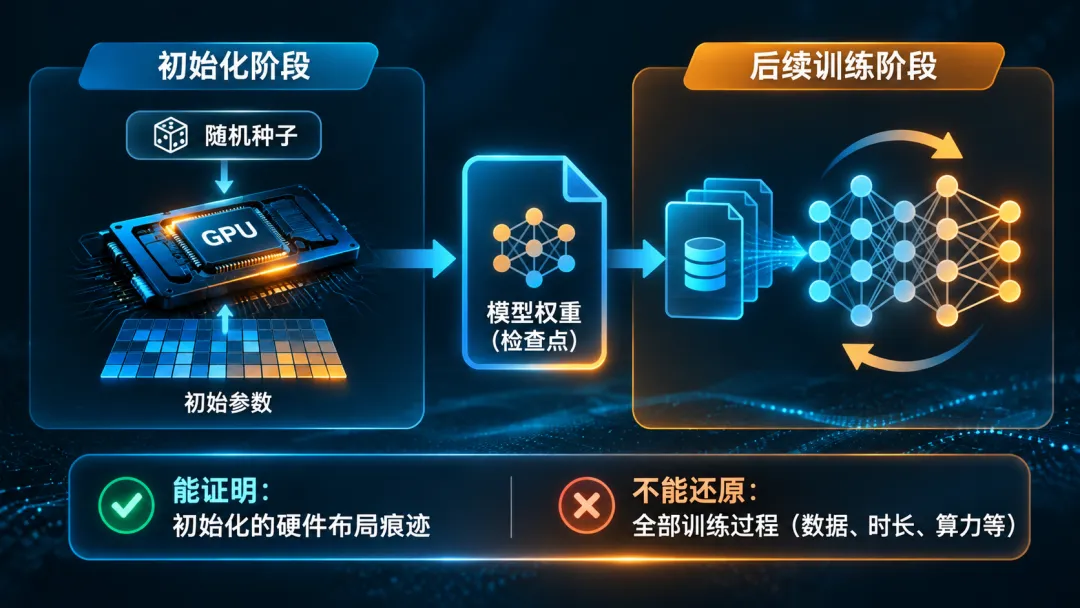
但这不代表指纹证据没有价值。Kimi K3 的初始化分散在至少 64 个分别设定种子的进程里,都留下同一种 152-SM 布局。
总的来说:这些模型在相应硬件上初始化,证据很强;主要训练是否也沿用同类硬件,权重本身看不出来。
五、比认芯片更有意思的:权重开始记录身世
DeepSeek 跨代模型复用同一个随机种子,Kimi K3.1-Pro 与 K3 也用相同种子,报告认为前者可能是在后者检查点上继续训练形成的。
更特别的是 K2.7-Code:保留参数里约 80% 与早期 Hopper 布局一致、约 20% 匹配另一种 148-SM 布局,更像两份权重被合并,不太像一次训练里混用两种芯片。
权重取证从"认芯片"走到"查身世":谁继承了谁、哪部分被重新初始化,都可能留下线索。
六、权重多了一个身份:外部审计材料
这项研究真正值得关注的,是模型多了一种被外部检验的可能:过去外界只能看论文和企业披露,现在研究者开始直接从公开权重里找证据。
但这种透明可能很短暂。部分 Qwen3 用 CPU 初始化,百度 ERNIE-5.5 的初始化实现也没让研究者恢复出可识别的 GPU 布局;只要改变初始化方式,指纹就可能消失。
开源让我们能够使用模型,却不保证永远看得清它怎么造出来的。当权重可能泄露开发过程,AI 公司会选择保留这些痕迹,还是主动消除它们?
资料来源
Will DePue,Unemployment Labs,2026 年 11 月 12 日:Checkpoint Forensics 原始报告
说明:具体归因来自报告作者的实验,含真机复现与样本对照,未获独立团队完整复核。
延伸阅读:

