百度 1000 万下载的开源神作,这次把"页数上限"干没了
- 2026-10-30 15:32:07
先说结论:10 月 27 日,百度把文心 Unlimited OCR 2 全面开源了,模型、权重、连新基准都在 GitHub 和 HuggingFace 上。
初代 Unlimited OCR 是什么来头?LeCun 转发推荐过、GitHub 下载量破 1000 万的文档解析模型,开源圈这两年公认的"长文档神器"。时隔 4 个月,第二代回来了——参数体量没变:总参数 3B,推理时实际激活只有 5 亿。但这次的成绩单,是真正换了一个量级:
MarathonDocBench:百度这次随模型一起放出的百页级长文档新基准,覆盖 103–300 页。Unlimited OCR 2 拿到 77.1 分,全场第一,第二名只有 33.7 分; MPDocBench(多页跨页基准):84.6 分,榜首,比第二名高出 6.3 分。
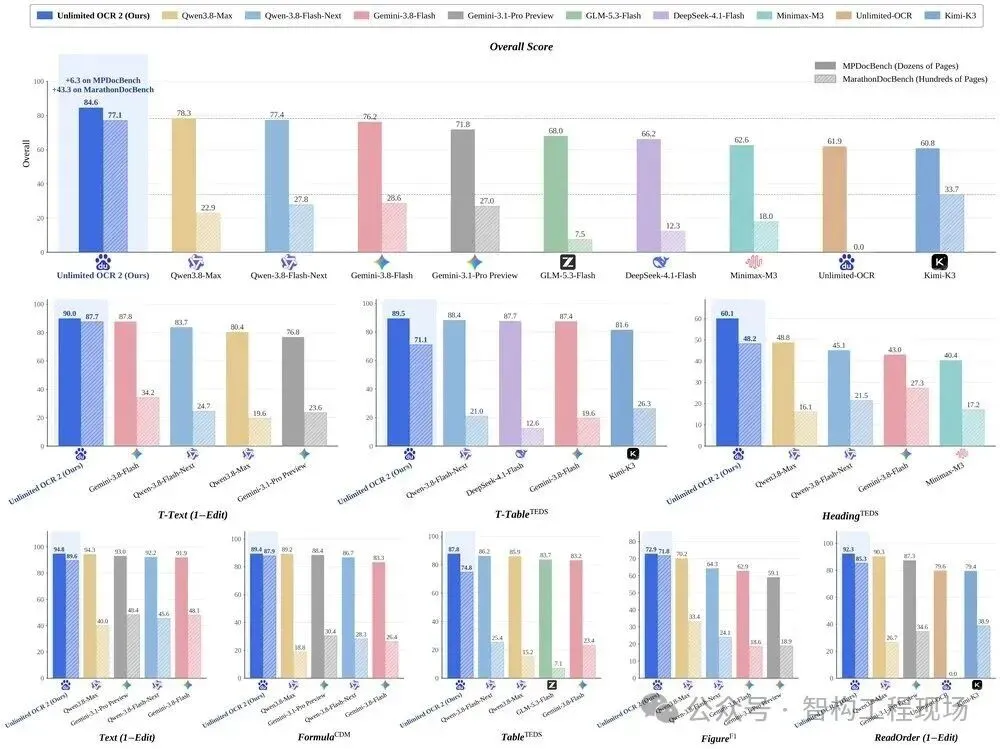
更扎心的是百页那一栏。同台的 Gemini 3.1 Pro 只有 27.0 分,有个通用旗舰模型读到第 223 页时直接崩盘中止(官方曲线图里标着"fails 223p")。1M 上下文的模型,读到 200 多页就倒下了。
为什么?往下看。
第一幕:一整本书,一次请求
官方仓库里放了一段回放 demo:一整本《哈利·波特》,一次请求喂进去,逐页解析、翻页输出,全程不回炉、不切分。
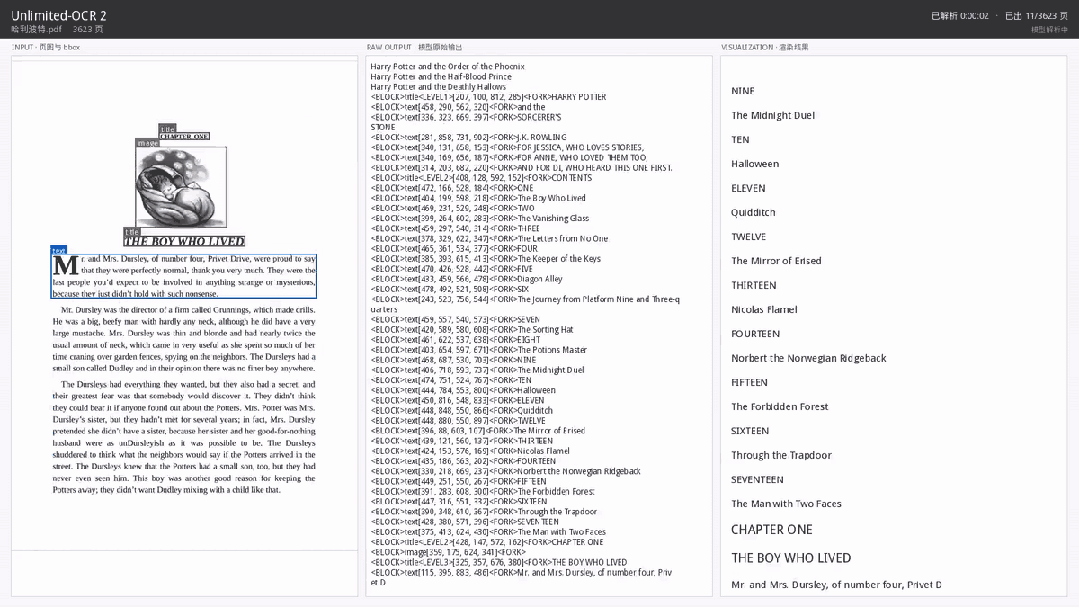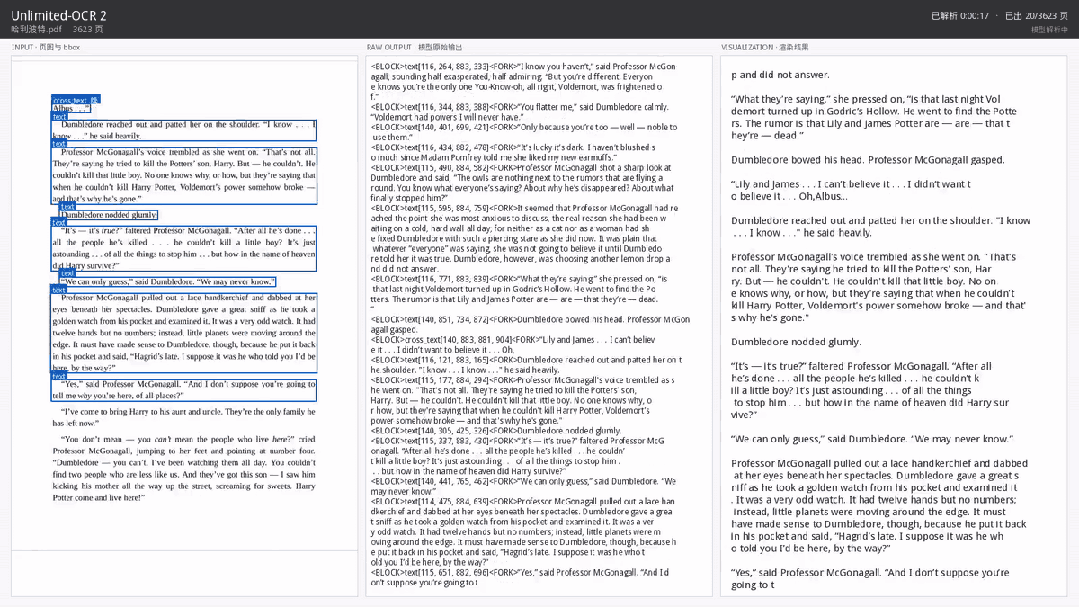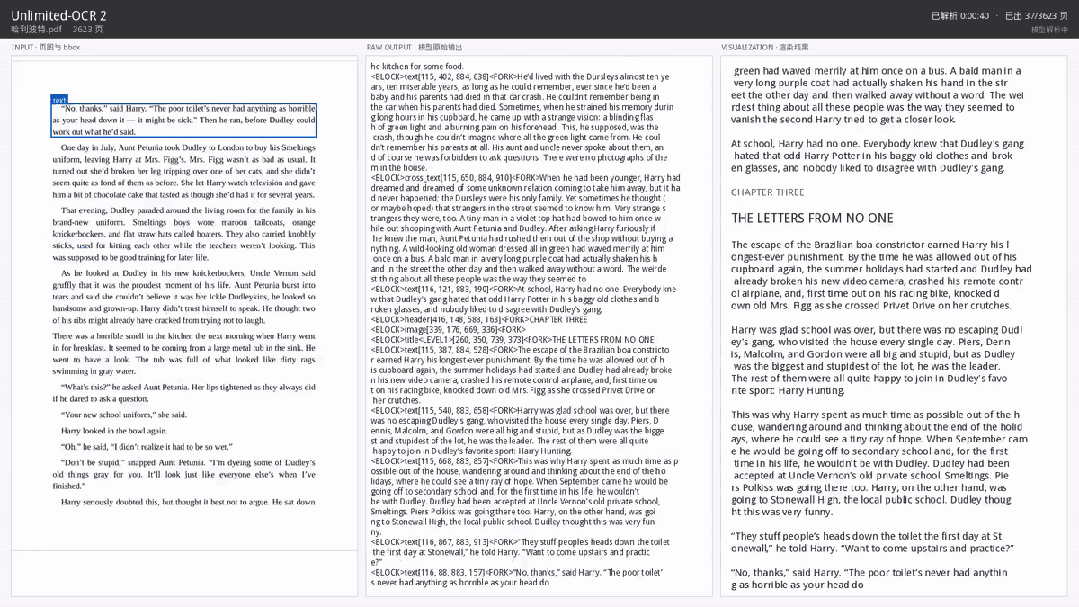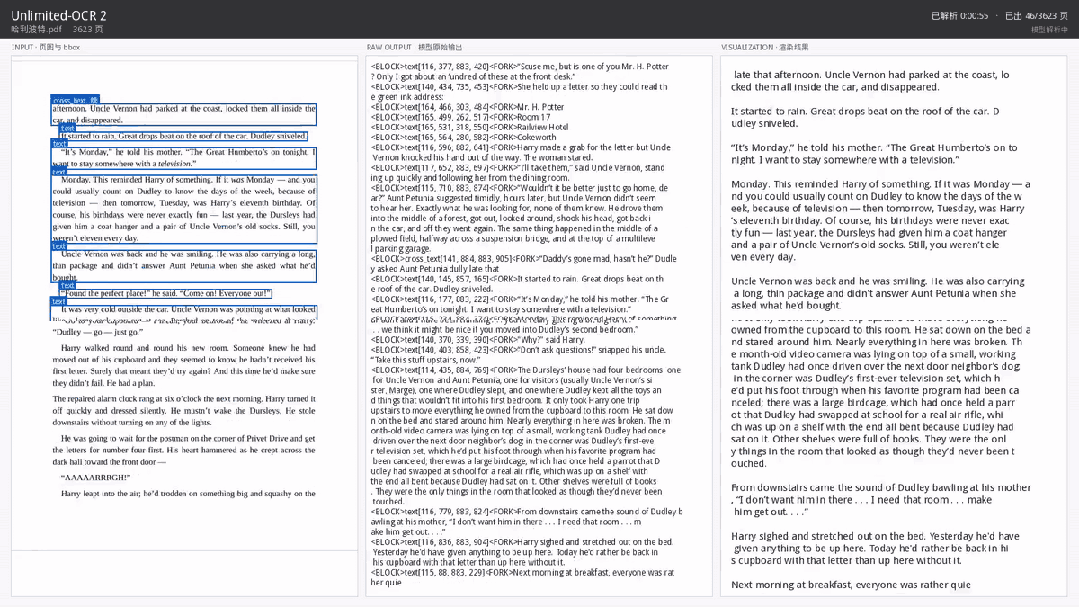
这个演示重点不是"多快",而是"一次"。初代模型的输入上限卡在 40 页——官方在 MarathonDocBench 上干脆没给它报分,原因就是"40-page input limitation"。第二代直接把窗口概念拆了:给 10 页和给 300 页,每一步的计算量是同一个常数。
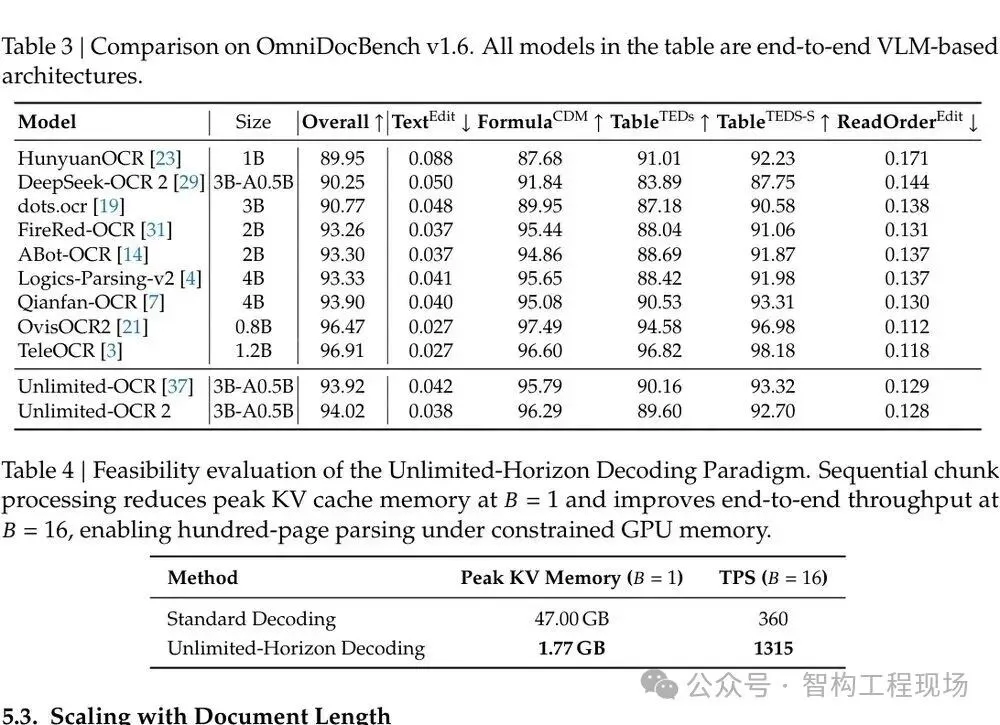
页数上限消失,带来的是硬件门槛的消失。官方报告里一组对照:
单序列峰值 KV 显存:标准解码 47.00GB → 无限解码 1.77GB,砍掉 96%; 16 路并发吞吐:360 TPS → 1315 TPS,3.6 倍; 百页单步解码延迟:比标准全注意力快 7.0 倍,比一代 R-SWA 快 5.6 倍。
一张普通游戏显卡跑百页文档,从"想都不敢想"变成了"确实能跑"。
第二幕:百页基准上,它稳得像条水平线
分数怎么来的?看官方 Figure 6 这张图就够了:横轴是文档长度(2 页到 300 页),一条曲线是准确率,一条是单步解码延迟。
别的旗舰模型是双跌:文档越长,准确率跳水,延迟陡峭冲顶。Unlimited OCR 2 的准确率是一条水平线,延迟贴着地走。
百页级长文档为什么这么难?病根在视觉 token。PDF 每翻一页就炸出上千个视觉 token,标准全注意力下,模型每生成一个新字,都要把前面所有页面的视觉 token 重新算一遍注意力——相当于抄书抄到第 200 页,每写一个字都要把前 199 页原书从头翻一遍。
代价是双重的:延迟随页数平方级上涨;几百页无关像素灌进注意力,模型后半程直接"走神",该记的忘了,不该编的开始编。
跨页能力是另一个隐形考点。官方专门设了两项跨页指标:T-TextEdit(跨页文本拼接)和 T-TableTEDS(跨页表格拼接)——一句话从第 3 页末尾跨到第 4 页开头、一张表头在第 5 页续到第 6 页,这种场景通用模型翻车率极高。Unlimited OCR 2 在这两项上同样是第一:T-TextEdit 90.0,T-TableTEDS 89.5。
第三幕:把"抄书匠的直觉"写进注意力
百度的解法,一句话能说清:像人抄书一样做长文档解析。
人抄几千页的大部头,绝大多数时间只盯手头这一页;只有翻到页脚、或者要核对前文图表人名时,才精准往回翻一眼。翻译成技术语言:单页内信息高度聚合,跨页的视觉关联极其稀疏。
顺着这个直觉,第二代的核心是 SR-SWA(稀疏参考滑动窗口注意力),两步走:
Page Gate(页面门控)先圈范围——视野从几千页收缩到少数候选页; Token Sieve(Token 筛子)再挑重点——候选页里实时打分,只抓最相关的几个视觉块参与计算,其余像素略过。
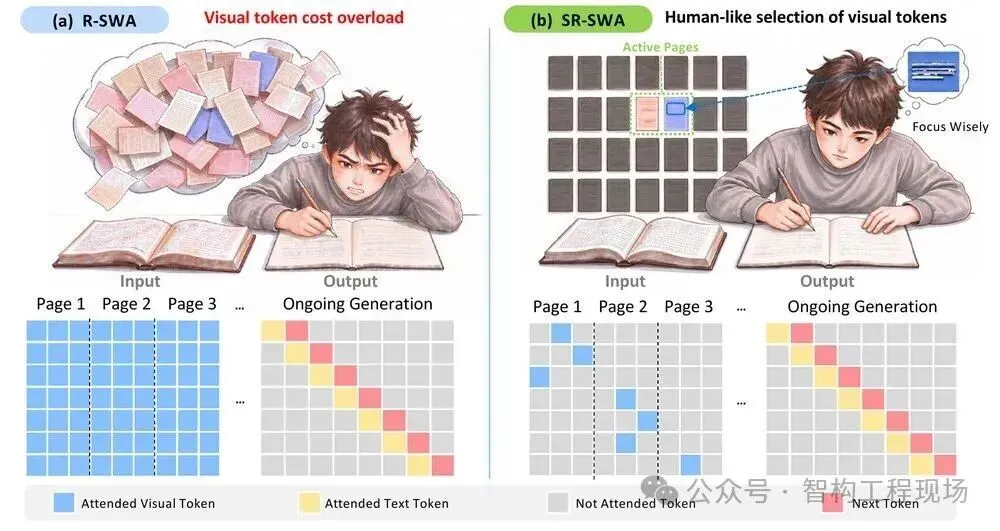
关键设计在最后一句:这套筛选器的路由打分直接参与前向计算,OCR 转录的梯度可以端到端回传。"该翻哪一页、抓哪一块"是模型在抄书实战里自己练出来的,不是靠蒸馏模仿贴上去的。
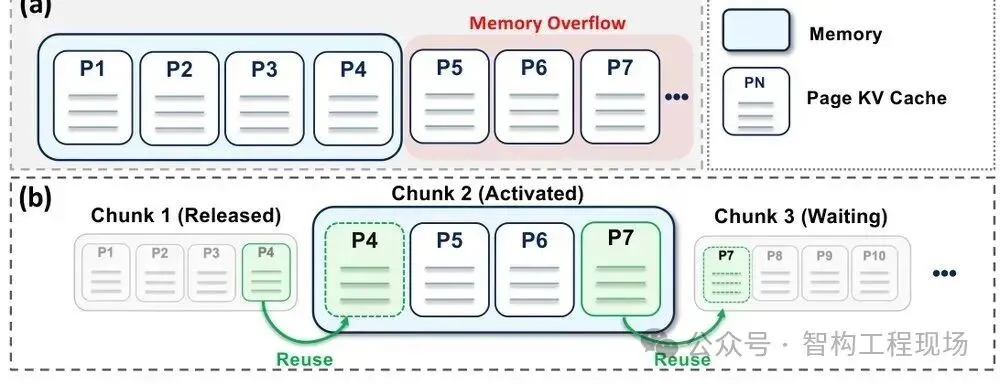
算力锁住之后,显存还得拆。无限解码机制(Unlimited-Horizon Decoding)把超长文档切成窗口接力跑:相邻窗口只留一页"交接页(Boundary Page)"复用 KV 缓存,保证翻页处的断句和续表不断流;当前窗口转录完,历史缓存从显存里物理释放——边读边扔,轻装上阵。
彩蛋:Fate 咏唱被印进了论文引言
技术报告引言第一行,印着一段让极客会心一笑的"咏唱":
Pixels are my body, and tokens are my blood. I have parsed over a thousand pages. Unknown to KV cache, nor known to context limits. So, as I pray: Unlimited OCR Works.
老二次元一眼就能认出:这是《Fate/stay night》"无限剑制(Unlimited Blade Works,UBW)"固有结界咏唱的 OCR 改版。初代开源时,一位叫 Snarcy 的开发者在 HuggingFace 评论区看穿了命名巧思,随手写了这段改写。百度团队看到后如获至宝,直接印进 2.0 报告引言第一行,署上了这位网友的 ID。
一个开源项目的名字梗被官方论文郑重引用——这可能是我对这个团队好感度拉满的时刻。
写在最后
初代论文结尾留过一句展望:如果模型学会自动翻页,OCR 就不再是识别一页文字,而是读懂一整本书。
今天这句展望照进了现实——几百页的招股书、上千页的标书和古籍扫描,不用切章、不用切册,一次上传读到底。而且它报告标题里那句话没说错:Pioneering the OCR-3.0 Era。OCR 1.0 是多模块流水线,2.0 是端到端视觉语言模型,3.0 是"不设页数上限"。
全开源:模型、权重、MarathonDocBench 基准,都在下面。5 亿激活的体量意味着你家的显卡就能上手:
GitHub:https://github.com/baidu/Unlimited-OCR[1] HuggingFace:https://huggingface.co/baidu/Unlimited-OCR-2[2]
下一篇聊聊 SR-SWA 这套"抄书匠注意力"对通用长上下文模型的借鉴价值。觉得有用点个关注。
引用链接
[1]https://github.com/baidu/Unlimited-OCR
[2]https://huggingface.co/baidu/Unlimited-OCR-2

