Radiology顶刊TRAM-AI:下载医学影像数据集前,务必花 5 分钟做的前置“体检”
- 2026-10-24 19:23:22


发表期刊:《Radiology》(2026年10月)
论文标题:TRAM-AI: A Framework for Transparency in Reporting of Medical Imaging Datasets for Artificial Intelligence Development
一、谁还没被“公开数据集”背刺过?
做医学影像科研,最痛苦的瞬间是什么?
不是 loss 降不下去,也不是显存爆了,而是你辛辛苦苦向服务器提工单申请了几百 G 存储,挂着梯子下了整整三天三夜的“开源数据集”,解压之后兴冲冲写好 dataloader,一跑直接傻眼:
连个最基本的
patient_id都是乱的,同一个病人的切片被随机切进了训练集和测试集(数据直接漏成筛子);压缩包下到 99% 报 CRC 损坏,回头一看作者压根没给 md5/sha256 校验码;
图像的 Spacing、Origin 缺胳膊少腿,重采样写到崩溃,标签还对不上号。
最后模型没调成,光写数据清洗的“胶水代码”就搭进去整整两周。
在医学影像领域,所谓的“公开可用(Publicly Available)”,很多时候仅仅意味着“文件挂在网上能下载”,离真正的“开箱即用(Usable)”隔着十万八千里。
《Radiology: Artificial Intelligence》最近刚发的这篇 TRAM-AI出了可实际使用的检查标准来避免这个问题。
二、 顶刊测了10个常见数据集,底裤都给看穿了
作者团队没有空对空喊口号,他们直接拉了 10 个大家耳熟能详的公开医学影像数据集做试点打分。这组实测数据,看完真的会心一笑又觉得无比真实:
90% 确实把基础的合规脱敏、受试者映射做好了(毕竟不脱敏不能发出来);
只有 30% 给出了清晰的数据集划分标识(Partition Keys);
仅有 10% 提供了完整的数据归档验证(比如 Checksum 校验)。
也就是说,70% 的数据集如果你直接拿官方给的文件去切训练/验证集,大概率会踩中跨受试者数据泄露的雷区;90% 的数据集下坏了你都不知道是网络抖动还是源文件本来就破损。
这不是我们的代码写得烂,是数据源头从一开始就埋了雷。
三、 TRAM-AI 到底是什么?
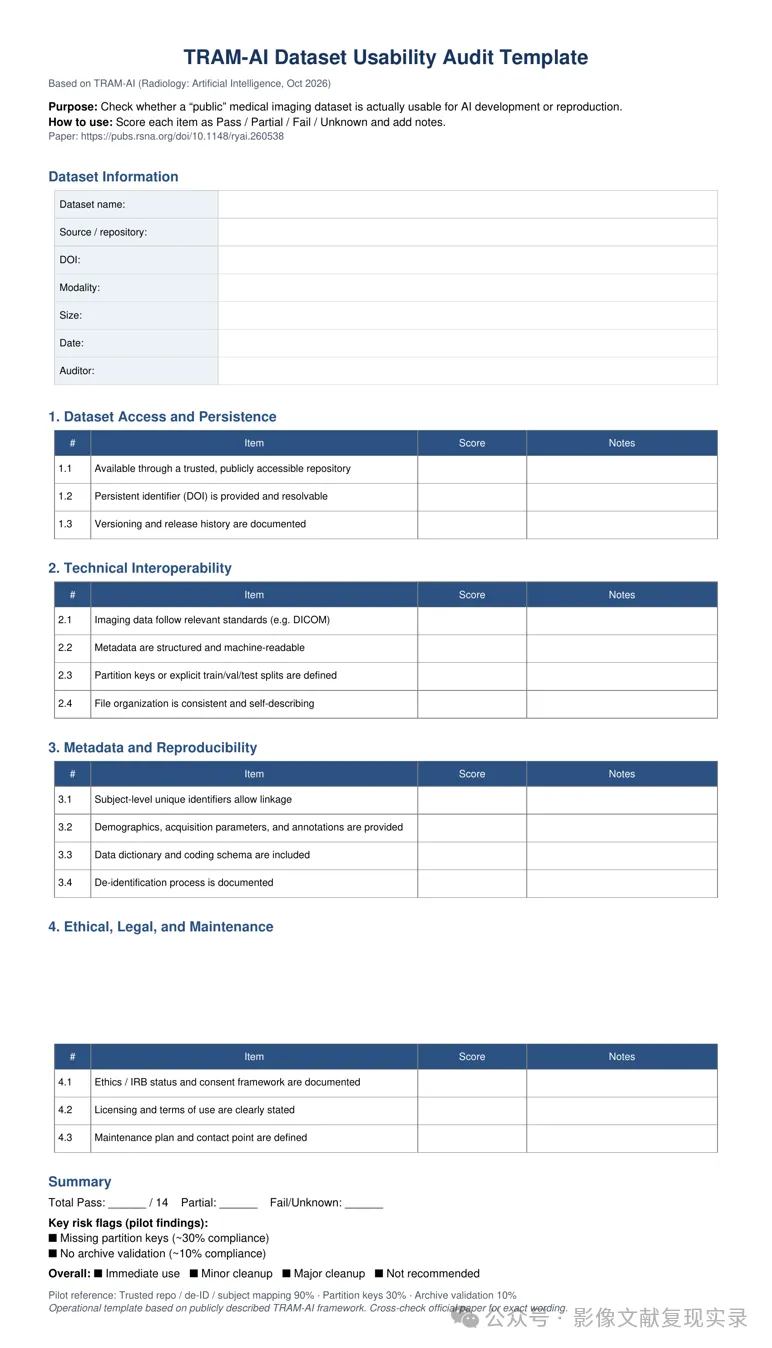
说白了,它就是一份专门给研发人员在“准备点下载之前”用的排雷清单(Checklist),一共 14 条核心标准,分为四大关卡:
能不能稳稳拿到?(Access & Persistence)
链接会不会半年后就 404?有没有官方 Hash 校验码防压缩包损坏?
代码能不能直接读?(Technical Interoperability)
是标准 DICOM/NIfTI 还是奇怪的私有格式?三维空间几何信息齐不齐全?
能不能严谨复现?(Metadata & Reproducibility)
这是重灾区中的重灾区! 有没有官方明确划分好的 Data Split?标注协议是高年资放射科医生双盲还是实习生随便勾的?
合规和维护(Ethical & Maintenance)
开源 License 到底允不允许发 paper?有人维护提 issue 吗?
这套框架最实用的地方在于:把以前耗费两周踩坑才发现的毛病,前置到了看数据集介绍页面的 5 分钟里。
四、 写在最后:别把时间浪费在低质清洗上
复现一篇好论文,搭网络、改损失函数才是真正有价值的脑力活。把大把科研时间耗在猜作者的数据划分规则、修损坏的 DICOM 头文件上,纯粹是浪费时间。
动手拉数据之前,先拿 TRAM-AI 这把筛子过一遍。达不到标准的,要么提前做好清洗工作量的心理预期,要么干脆换源。
小编微信:
期待与您共同探讨医学影像+AI技术等相关内容,如有需要使用roi自动勾画软件、Radiomics、生境分析、多组学、深度学习、润色或其他定制化服务欢迎添加微信。
最新《Science》启示:单中心模型怎样提升临床应用可能?
胰腺癌与腹部AI的三条前沿路径:从PANORAMA到PANDA、RADAR