252GB 的模型开放下载了,你的笔记本跑不动
- 2026-10-24 14:50:52
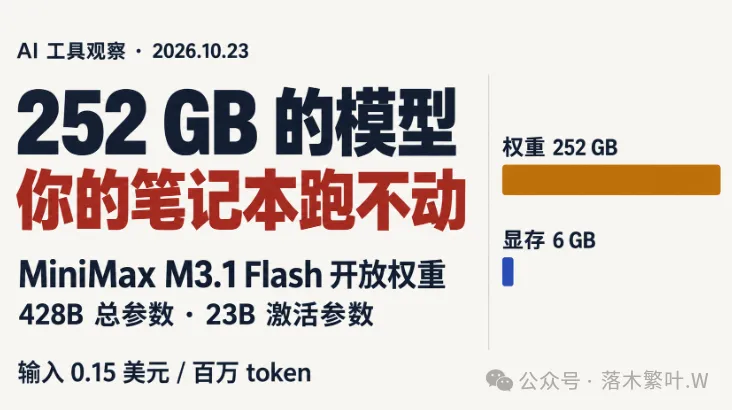
10 月 23 日,MiniMax 把 M3.1 Flash 的模型权重放了出来。总参数 428B,每处理一个 token 只激活 23B。这两个数字看着矛盾,其实是同一件事的两面
先说一句可能让人扫兴的话。这个模型不是给普通人的电脑准备的。这次对仓库文件清单求和,48 个主模型分片,加上 1 个 DSpark 权重文件,合计大约 252 GB(按 1024 进算是 235 GiB)。这只是下载体积,还没算运行时需要的内存,最大单个分片 10.2 GB
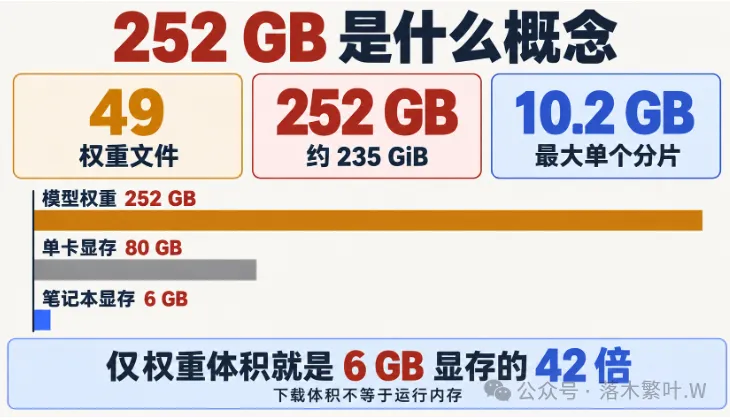
拿 6GB 显存、16GB 内存的笔记本作参照,仅这些权重文件的体积就是显存容量的约 42 倍。单个文件能否装下也不能单独决定能否推理,还要看总权重、缓存、框架和卸载方式。至少,这套官方部署方案并不适合这档笔记本
428B 和 23B 不矛盾
这是混合专家结构,英文叫 MoE。模型会为每个 token 选择部分专家参与计算。428B 是总参数量,23B 是每个 token 激活的参数量,两个数字都不是专家个数。激活较少参数能减少计算量,却不代表只需存下这部分权重
这个思路不新,但 M3.1 Flash 把它推到了一个显眼的位置,每 token 激活 23B,大约是总参数的十八点六分之一
官方给的另一个数字是速度。日常输出能到 200+ token 每秒,中位数稳定在 170+。这是官方自报,我没有独立复现过,只能照实转述
价格表
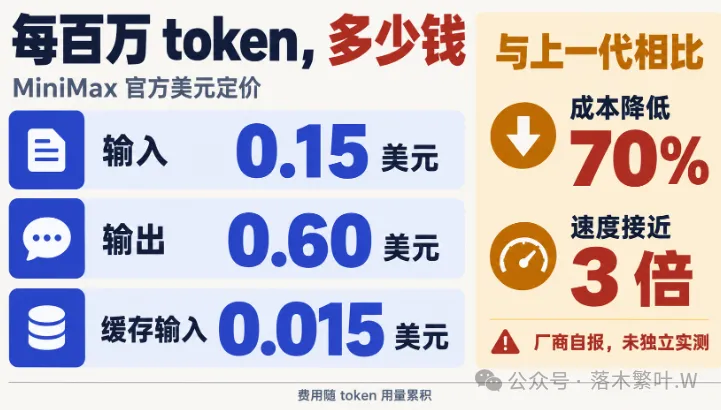
每百万 token,输入 0.15 美元,输出 0.60 美元,缓存输入 0.015 美元
输出和输入分别计费,缓存命中时才适用缓存输入价。对经常跑长任务的人来说,应该把三项和实际用量放在一起算。官方也说智能体任务整体成本比上一代低 70%,推理速度快近 3 倍。同样是厂商口径
能跑什么,读什么
官方模型卡里写了,这个模型能读文字、图片和视频,上下文窗口最高 100 万 token
token 是模型切分内容后的计量单位,不能按固定比例直接换成汉字。模型卡也注明,可用上下文长度取决于 GPU 内存和服务配置。100 万是规格上限,不能当成一次请求必然能稳定处理的资料量
官方将它称为原生多模态模型。对做设计的人而言,值得验证的是它处理图纸、图片和界面截图的效果;支持这类输入,并不等于识图准确率已经得到保证
那个许可证值得单独拎出来说
大部分转发只写了"开源"两个字。我把仓库里的 LICENSE 下载下来读了一遍
它不是 Apache 2.0,也不是 MIT。它叫 MiniMax Community License。
条款核心有三条。
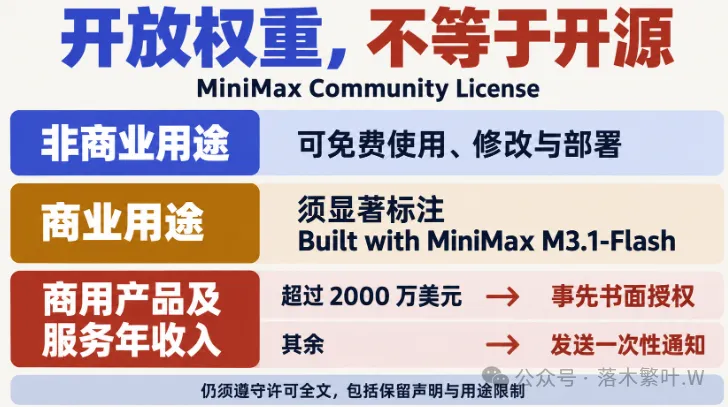
非商业用途免费、商业用途要在网站、界面或文档上显著标注"Built with MiniMax M3.1-Flash"。如果产品年收入超过 2000 万美元,要向 MiniMax 单独申请书面授权。其余商用情况则需要发送一次性通知。保留版权及许可声明、遵守用途限制等条件仍然适用。
所以准确的说法是"开放权重",不是"开源"。权重能下载,能改,能自己部署,但商用的条件是写明的,不是随便用
个人创作者也要按实际用途区分非商业和商业使用,不能仅凭规模小就跳过条款。打算接到自己的网站或对外服务里时,先把标注、通知和授权条件读清楚
和谁比
官方模型卡列出七个模型的基准成绩。这里只摘几行;这不是我在统一条件下做的独立横评
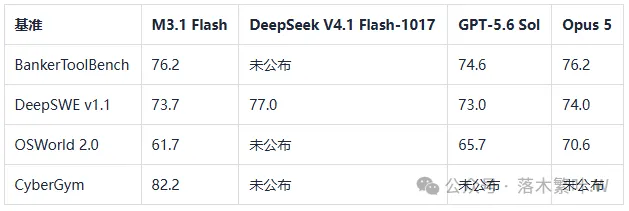
BankerToolBench 追平了 Opus 5。DeepSWE 落后 DeepSeek 三分多。OSWorld 那项落后 Opus 5 近九分,这是真实差距,不能因为参数大就默认全面追平
我的判断是,它在智能体类和成本敏感的场景上有竞争力,但在这张官方表的 OSWorld 一项上,它仍落后于所列的头部模型,不能据此概括所有电脑操作任务
想自己跑,需要什么
官方推荐的推理框架是 SGLang、vLLM 和 TokenSpeed。vLLM 发了 Day-0 支持的技术博客,说明了具体硬件
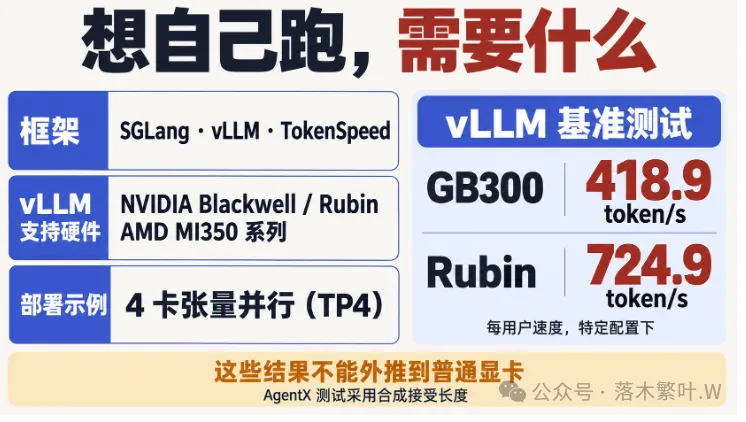
他们给出的部署平台是 NVIDIA Blackwell、NVIDIA Rubin 和 AMD MI350 系列,示例用的是 4 卡张量并行。vLLM 博客里给的实测数字,GB300 上每用户最高 418.9 token 每秒,Rubin 上 724.9。这些都是特定硬件加特定配置的结果,不能拿来推普通显卡
这篇核到的官方部署路径面向数据中心硬件。对设备有限的个人,先看现有服务入口是否方便,再决定有没有试用的必要,比先下载权重实际。API 也会随用量计费,这里没有做付费试用
顺带说一句,IT之家报道里提到,华为昇腾、平头哥、昆仑芯、摩尔线程、壁仞、海光、沐曦、天数等国产芯片厂商也参与了首日接入。这条我没拿到 MiniMax 的原始公告全文,只能标注为"据 IT之家报道"

