模型下载了,服务却未必跑得好:DeepSeek开放DeepInfer,补上哪一环?
- 2026-10-22 19:34:24
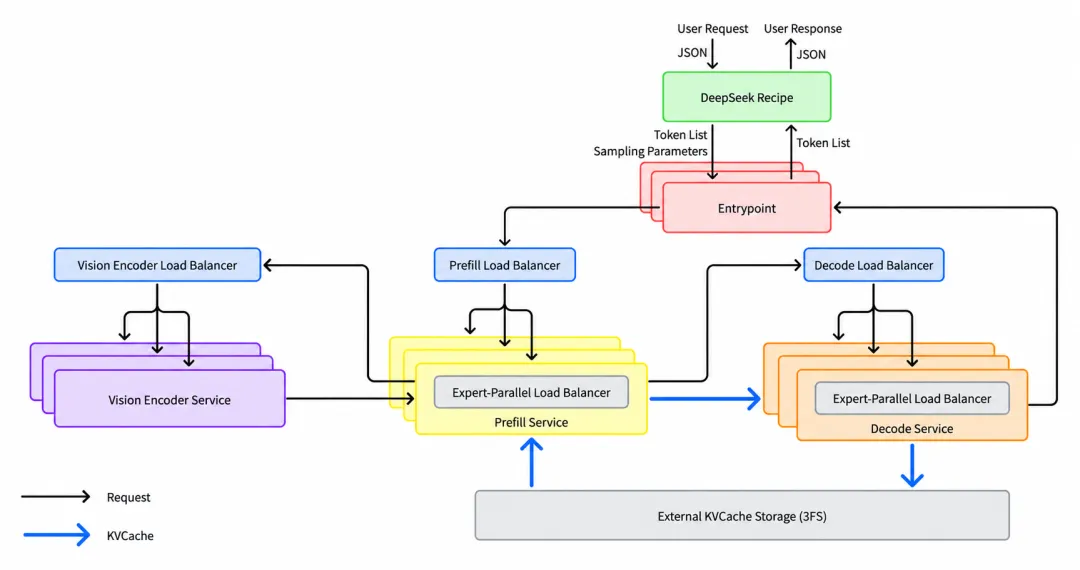
同一个AI模型,为什么有的平台回答流畅,有的平台却经常等待?把模型文件下载下来,为什么仍然很难搭出同样好用的服务?
答案的一部分,藏在模型背后的运行系统里。
近日,DeepSeek公开了推理框架 DeepInfer。官方说明,它用于支撑自身的大规模生产服务;当前开源版本提供离线推理及部分面向规模化运行的核心能力,采用Apache 2.0许可。来源:项目说明
从“模型会什么”,走到“怎样让它跑好”
推理,就是让训练好的模型处理输入、生成结果。真正面向大量用户时,系统还要安排计算、协调多张芯片,并尽量避免重复工作。
可以把它想成餐厅:菜谱决定能做什么菜,厨房怎样分工、怎样安排订单,则影响出餐速度和成本。
DeepSeek在部署问答中指出,计算、通信、调度和缓存需要协同设计,端到端性能取决于具体部署条件。来源:官方部署问答
这次公开的价值,在于让外部开发者能看到并使用更多运行层面的实现。
官方示例,展示了怎样检查运行结果
项目提供的离线示例,默认使用DeepSeek-V4.1-Flash-1017。模型可以从远程下载,也可以从已经准备好的本地目录加载。
示例包含纯文本、单张图片和多张图片输入。图像样本使用仓库中的胡萝卜与排骨图片,方便开发者在一致输入下检查运行表现。来源:示例文档
此外,开发者可以开启结构化输出检查,验证生成内容是否符合JSON等格式要求,以及是否正常结束;检查失败会使运行报错。
这些是官方提供的运行与验证流程,本文没有实际部署,也没有独立复现其性能结果。它们说明,这套框架关注的不只是“能生成一段话”,还包括输出能否被后续程序稳定处理。
对普通用户,影响可能发生在后台
DeepInfer首先面向部署模型的开发者和服务商。普通用户更可能通过使用的AI产品,间接受益。
如果部署团队能提高硬件利用率、减少重复计算,就可能改善等待时间,或降低服务成本。但是否转化为更低价格、更稳定的体验,还要看实际部署和产品策略。
它也提供了跨硬件实现的参考:当前项目明确列出NVIDIA SM100 GPU和华为Ascend 950 NPU支持。来源:硬件支持说明
这意味着开发者有机会研究同一模型在不同平台上的运行方式,不能据此推断所有显卡都能直接使用。
距离完整在线服务,还有哪些工作?
官方列得很清楚:完整推理服务需要的缓存系统、部分分离部署能力,以及负载均衡,并未全部包含在这次发布中。来源:开源范围说明
部署问答进一步解释,缓存管理和负载均衡与内部基础设施紧密关联,相关代码尚未完全公开。来源:官方部署问答
因此,下载仓库并不等于复制了DeepSeek整套在线服务。硬件、系统集成和持续运维,仍然需要投入。
DeepInfer让一个容易被忽略的问题更具体了:模型开放之后,怎样让更多人高效地用上它?接下来值得观察的,是外部团队能否利用这些实现,在自己的硬件和真实负载下做出可复现的改进。
参考来源
以下官方文档持续更新,未标注统一发布日期;查阅日期均为 2026年10月21日。
DeepInfer项目说明:功能、硬件与开源范围 DeepSeek V4.1 Flash推理部署问答 DeepInfer官方运行示例与验证说明

