公众号历史文章下载:怎么批量存到本地
- 2026-10-20 09:43:05
我找公众号历史文章下载工具,是想把一个号的旧文章存到电脑里。想重读某个系列时,打开目录就能接着看;整理个人资料时,也能把文章和图片一起保留下来。
这类需求里,有一个细节容易忽略:保存了文章链接,和保存了文章文件,是两回事。我希望拿到的文件有目录可翻,正文和图片也能在本地打开,以后换个文件夹备份,仍然知道每篇文章来自哪里。
从一篇文章开始,先看下载范围
我查到的 mphistory,是一个公众号历史文章批量下载工具。它从一条公开文章链接识别公众号,把这个号已经发布的文章按时间从最新往前分批打包,提供 HTML、Markdown 和图片。
不用准备公众号账号密码,也不用安装软件。先在微信里打开目标号的任意一篇文章,从右上角「···」里复制链接,再粘贴到工具首页,就能免费预览。这里要用文章链接,公众号主页和名片不适用。
我会先看预览里的公众号名称和最近推送,再确认这一批包括哪些文章。如果是想保存某个旧系列,就要留意它有没有落在当前范围里。
官网当前价格是每批 ¥18.88,每批最多 1,000 篇,从最新的文章往前算。 号里不足 1,000 篇时,按实际数量下载,价格不变。文章较多的号,旧系列可能还在更早的批次里,不能默认付一批的钱,就拿到从创立至今的全部文章。
整个操作可以照着这四步走:
复制目标公众号任意一篇公开文章的链接。 粘贴到首页,免费预览并确认公众号与本批文章范围。 确认后扫码付款,按页面要求备注订单码,等待人工核对。 等任务打包完成,在电脑或手机浏览器里下载 zip 文件。
付款核对和文件打包需要分别等待。下载大文件时也要留意,官网提示微信内置浏览器不支持这一步,需要到手机浏览器或电脑上打开任务链接。
下载以后,文章怎么读
工具交付的是一个 zip 压缩包。这次核对的是“光通信女人”的历史文章文件夹,里面能看到 articles/、images/、index.html、manifest.csv 和 README.txt,分别用来放文章、图片、阅读目录、文章清单和说明。
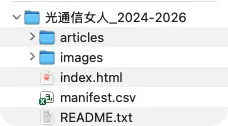
只想阅读,可以先用浏览器打开 index.html,从目录找到文章,再进入对应的本地 HTML 文件。希望用 Markdown 编辑器阅读,则可以使用 articles/ 里的 .md 文件。
这时别急着把单篇文件搬走。Markdown 里的图片通过相对路径引用 images/,如果只拷贝文字文件、没保留图片和目录关系,图片就可能无法显示。备份时,我会把解压后的整个文件夹一起保存。
这份目录页标示共 1,000 篇,日期范围是 2024-02-16 至 2026-10-18,状态栏写着“成功 1000”。画面中可以看到按日期排列的文章标题,以及右侧的 Markdown 和原文入口。这里的“成功”是目录页的状态统计,正文和图片是否完整,仍需打开文件检查。
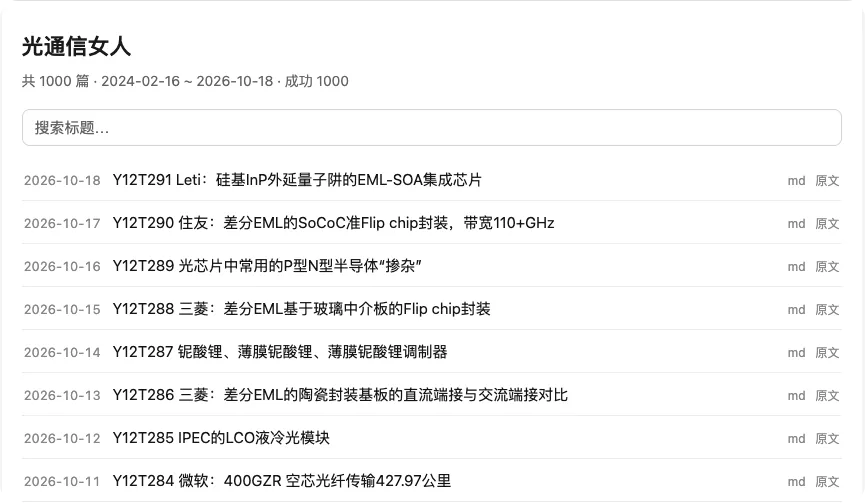
那份 CSV 清单也建议留着。它列出文章标题、发布日期、原文链接和状态,方便核对保存的时间范围,以及哪些记录需要进一步检查。过一段时间再回来看,也不必只凭文件名猜文章的出处。
下载后可以抽几篇检查:先从本地目录打开文章,再断网查看文字和图片。这样能确认抽查的文件是否适合离线阅读。原文链接留作来源,访问它仍然需要联网。
下载前,先看清几个边界
1,000 篇是按文章链接数计算的。 视频、纯图片和原文已经删除的文章也会计入,并在清单中标出。所以,1,000 条记录不能直接理解为 1,000 篇完整图文;清单里保留了某条已删除记录,也不意味着能恢复它的正文。
想继续往前下载,要留意时间窗口。 按官网规则,一批完成后 12 小时内,可以在任务页选择「继续下载下一批」,接着往更早的文章走。超过这个时间,就只能从最新文章重新开始。目标是较早年份的内容时,这个规则要在下载前看清。
文件包不会持续更新。 这次保存的是一份历史文章文件。这个号以后再发布新文章,不会自动加进已经下载的压缩包里;服务器上的文件也有保留期限,下载后需要自行备份。
本地保存不改变版权归属。 工具官网限定用于个人学习、研究和收藏,不用于商业用途,不公开传播或二次发布。文章版权仍归原作者及公众号所有。
需要保存某个号的旧文章,可以先拿一篇文章链接去预览,确认公众号和范围,再决定下载。入口是:
mphistory.followto.us

