开源大模型免费下载,账单却未必更便宜,先看清这三行
- 2026-10-17 04:30:40
你有没有发现,最近关于大模型的新闻越来越像好消息。权重开放、免费下载、随便改,听着像是以后不用再掏钱了。
真下回来一个,味道就不太对。
十月十五日,Muse Spark Open 开放了权重,总参数 8160 亿。它每处理一个词元只激活其中 420 亿,用的是稀疏专家结构,一百万个词元的上下文,文字、图片、音频、视频都能读进去,回答还是文字。下回来之后你可以自己改、自己微调,甚至装进自己的产品里。
可你下载到的是权重,不是跑得动权重的那台机器。
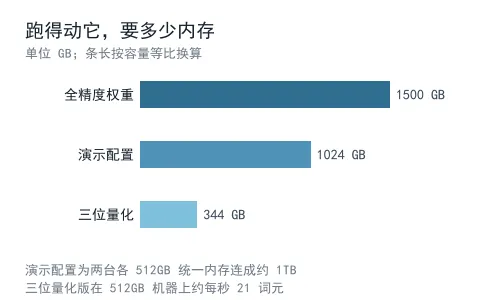
全精度权重摊开来大约 1.5TB,压到 3 位还占 344GB。这是个什么概念?笔记本硬盘够,内存差得远。官方给的演示方案是两台各配 512GB 统一内存的机器连起来,凑出大约 1TB 共享内存,才勉强当一台机器用。据早期报道估算,光四台 256GB 的机器就要三万八千美元上下。
所以第一条路,自己搭,卡住人的从来不是模型,是硬件和电费。
第二条路是托管。开放当天就有七家服务商上了线,价款写成每百万词元输入 1.25 美元、输出 4.25 美元、缓存读取 0.15 美元。机器不用你买,用多少算多少,缺点也在这:单价由人家定。
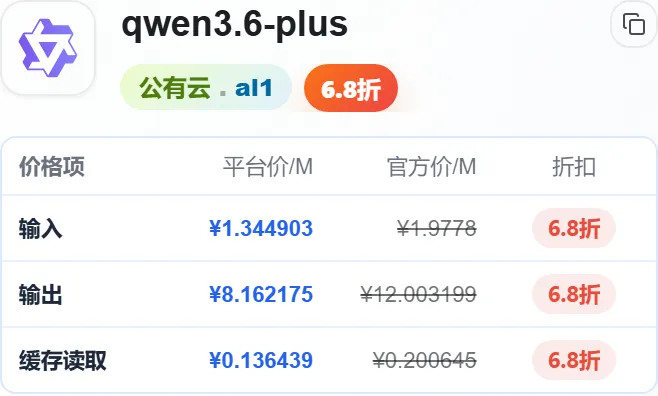
第三条路是聚合,也是一个 key 按量付费,只是把国内主流模型摆成一排让你挑。上面那张卡就是这一档的样子:qwen3.6-plus 走公有云渠道,六点八折,输入每百万词元一块三毛四、输出八块一毛六、缓存读取一毛四。输出那一行是输入的六倍,缓存读取那一行只有输入的十分之一。
三条路的差别,拆开看就是三笔钱:机器钱、运维钱、调用钱。自己搭,等于把前两笔一次性背上,调用钱归零;托管和聚合把前两笔挪走,换成按量的调用钱。哪一笔对你更沉,只取决于你每个月实际跑多少。
那 Muse Spark Open 适合谁?说实在话,它更适合有自己的机房、或者数据落地有硬要求的团队。它擅长的是编码和长周期智能体任务,能自己规划、调工具、连着跑很久,工具调用那一项在它自己的评测里排到第一;换成编程,它的 76.4 分低于 kimi-k3 的 85 分,也低于 glm-5.3。要是你日常就是写文案、整理表格、查点资料,为它换一台机器并不划算。同价位档里,glm-5.3 在长任务和工程规范上更稳,kimi-k3 吃得下百万上下文和多模态输入,qwen3.8-max 是旗舰档,法律、金融这类要求高的活它更合适。
真正决定账单的,常常不是你盯着看的那一行。
缓存读取那一行,才是重复劳动真正该盯的数。你要是每天拿着同一份产品说明、同一套规范去问模型,那部分内容会被缓存命中,按缓存读取那一行计价,通常只有输入价的几分之一。反过来,每次提问都换一份新文档,缓存就形同虚设,钱按输入价照走。省钱的顺序是先选对档,再谈缓存,最后才轮到自建。
三条路各有各的适用面。数据必须留在自己机房的,硬着头皮自建;用量不大、又不想管机器的,直接走托管或者聚合;想两头兼顾的,把底座和弹性分开。至于普通人,最划算的动作是先把自己那些重复内容理出来,看看能塞进缓存多少。

