AI说要开放下载,怎么我的电脑先怂了?
- 2026-10-14 08:12:32
阿良聊 AI
开放模型,究竟打开了哪扇门
老C看见一条消息:法国AI公司Mistral发布Large 4预览,计划在月底开放模型权重。
他很兴奋。
“终于能把厉害的AI搬回家了,不用看别人脸色!”
阿良看了一眼参数规模,又看了一眼他的笔记本。
“先别收拾客房。”
“怎么?”
“这位客人,可能得住机房。”
10月6日发布的Mistral Large 4,官方给出的规模是约1万亿总参数、每次计算激活约520亿参数。
同一条新闻里,“开放”和“庞大”挨得很近。
这正好解释了一个容易误会的问题:AI能下载,为什么仍然不等于我的电脑能轻松用?
●01 先别对着空气找下载按钮
先讲清楚时间。
截至10月9日,Mistral Large 4开放的是API公共预览,官方计划到月底发布权重。
所以,这篇文章并不是教你下载一个已经公开的正式权重包。
后续是否按期发布、具体采用什么许可、提供哪些文件与运行方式,要看正式说明。
新闻里“将开放”的那个“将”,不能一激动就删掉。
老C:“我已经搜了十分钟下载链接。”阿良:“你的网速没问题,是日历还没走到。”
不过,哪怕权重真的公开,问题也没有结束。
因为开放通常先改变的是:谁可以拿到哪些模型材料,能在什么条件下使用、修改和部署。
它不会顺手给每个下载者寄一箱显卡。
访问门槛下降,和运行成本消失,中间还隔着一张硬件账单。
这就是为什么,技术新闻里很大的“开放”,落到个人电脑上,可能仍然是一句“内存不足”。
●02 权重,可以先理解成模型训练后的大量数值
不必先学线性代数。
模型训练完成后,会留下大量决定其计算行为的数值。权重是其中最核心的部分。运行模型,需要把这些数据以某种方式存储、加载,并参与计算。
你可以暂时把它想成一套已经调好的复杂机器。
拿到机器的关键部件,和在别人店里按按钮点一杯饮料,使用方式显然不同。
调用API时,主要计算在服务商那边发生,你购买的是访问与处理能力。
自己部署时,硬件、软件环境、调度、维护等工作,就需要由你或你的供应商承担。
这两种方式都能有用,不能只用“是不是自己的”判断好坏。
如果你每周只问几个问题,专门维持一套庞大系统,可能并不划算。
如果一家机构长期有大量任务、特殊数据要求和运维团队,自行部署的价值又可能不同。
同一台机器,放在奶茶爱好者家里,和放在每天出杯上千的店里,是两笔账。
●03 一万亿,到底有多大?先算存储,不谈跑分
假设一万亿个参数,每个参数用16位,也就是2字节来存。
只算这些数值,大约就是2万亿字节,按十进制约2TB。
这还没有计入运行时额外需要的缓存、计算空间,以及其他实现开销。
如果粗略假设每个参数压到4位,纯数值体积约500GB;实际量化格式还有额外信息,运行开销也不能省略。
以上只是量级演算,不是Mistral公布的最终下载包大小,也不是保证某种机器能够流畅运行的配置单。
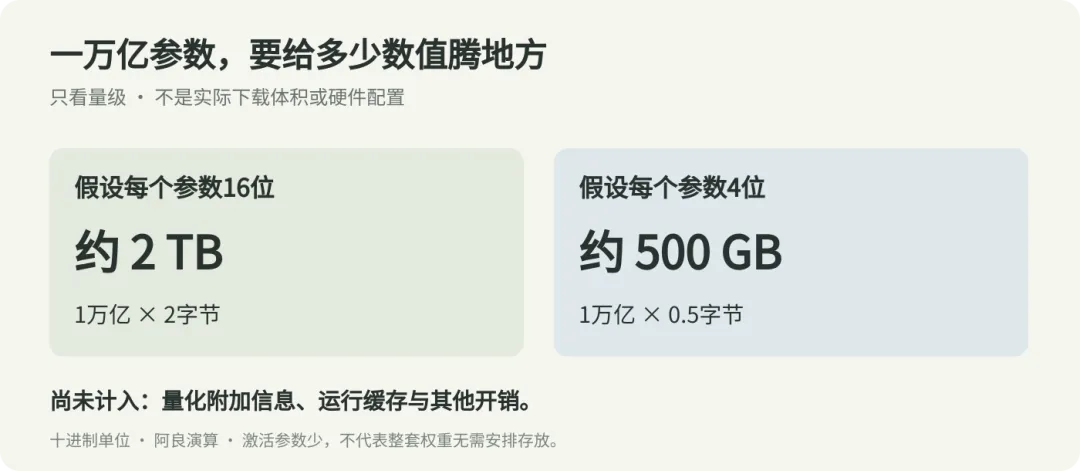
它只想告诉你:一万亿这个数字后面,是真的有东西要放。
老C:“那我买个大硬盘不就完了?”
阿良:“硬盘放得下,和计算时喂得动,是下一道题。”
存储像仓库,运行时的内存和显存像工作台。材料全堆进仓库,不代表厨师能在一张小桌子上同时处理完。
仓库和工作台之间不停搬东西,还会付出时间。
这就是为什么“下载成功”的庆祝,有时会止步于“正在加载”。
●04 可它不是只用520亿参数吗?
这个问题问得好。
Large 4采用混合专家思路,官方同时给出总参数与激活参数。可以简单理解为:每一步计算只调用其中一部分,而不是把所有参数都同样用一遍。
这有助于控制计算量。
但“这一刻只动用一部分”,不等于其余部分从存储和部署安排里彻底消失。
像一间有很多专门窗口的办事大厅。你这次只去两个窗口,不代表整座大厅只需要两张桌子。
当然,实际系统可以用分布式加载、卸载等方式安排资源,具体速度与占用取决于实现。
Hugging Face的加载文档就介绍了将模型按设备分配,在显存不足时向CPU内存、甚至磁盘卸载的办法,也提醒这类搬运存在性能代价。
激活参数描述“这步动用多少”,总参数仍影响“整套东西怎么放”。
把520亿直接当成全部部署体量,是把运行中的一道工序,当成整家工厂。
数字看懂一半,预算就可能少算一大截。
●05 开放权重,和完整开源,也别混成一个词
另一个容易被标题挤掉的区别,是“开放什么”。
有的产品允许公开试用。有的提供模型权重。有的还提供代码、训练方法或数据相关信息。不同许可对商业使用、修改、再分发,也可能有不同安排。
所以,不能听见“开”字,就自动脑补为随便下载、随便商用、免费运行、永不受限。
开放源代码促进会的Open Source AI Definition 1.0,对使用、研究、修改、分享,以及修改所需的信息提出了比“有权重可拿”更完整的要求。
这是一套具体定义,不代表新闻报道里的每次“开源”都已按同一标准审核。
对普通使用者来说,不必急着参与术语辩论。
先问自己真的需要什么:能不能在自己的环境运行,是否允许你的用途,出了更新谁负责,相关材料是否足够。
这些问题,比在评论区用一个词给模型判终身,更有助于实际选择。
这次权重尚未正式发布的部分,也不该提前替它填写许可条款。
●06 如果我跑不起,开放还有什么用?
有,而且价值未必都由你亲自部署兑现。
假设更多有能力的团队可以在许可范围内部署和改造模型,普通用户就可能通过不同产品接触到它。
有人做行业工具,有人优化服务成本,有人提供特定地区的部署,有人做更适合某类工作的界面。
这些是开放权重可能带来的路径,不是保证这款模型一定出现哪些成品。
对企业来说,能掌握运行版本、安排部署位置、根据自身需要优化,也可能具有价值。
但“我能自己管”同时意味着“有些事得自己管”。
安全更新、性能问题、服务中断、数据访问控制,不会因为模型材料可获取就自动由宇宙负责。
老C:“以前担心服务商停服务,以后担心自己停服务?”阿良:“自由有时候就是,电话响了你得接。”
开放带来的重要变化,是多一些可选择的路径。它不是附赠无限算力的购物券。
普通用户可以从更丰富的服务中受益,没必要为了支持开放,先把客厅改成机柜间。
●07 选模型之前,先问自己究竟要搬什么回家
如果你关心的是日常写作和资料整理,比较现成服务的质量、价格、数据处理方式,可能已经能解决问题。
如果你确实需要本地运行,先从符合设备能力的小模型与明确任务开始,会比盯着最大参数量更容易得到结果。
如果你代表一家组织评估部署,就得把硬件、维护、人员、实际任务质量和替换难度一起算进去。
这里没有一个“所有人都应该自建”的答案。
我的看法是,这条新闻值得关注的,不只是又出现一个大模型,而是先进能力未来可以通过哪些方式被人使用、修改和保留。
真正有意义的选择,必须同时看得到权利和成本。
只看权利,你可能高估自己能做什么。只看成本,又可能忽略多一种部署路径的长期价值。
老C最后关掉了购物车里的显卡页面。
阿良:“不买了?”
老C:“先等等正式发布,再看看我到底需要它干什么。”
“终于理性了。”
“主要是我家房东说了——”
“养猫可以,养数据中心得另谈。”
—— 阿良,下期接着聊

