GEO数据库使用2:怎么看下载后的结果
- 2026-10-13 10:34:29
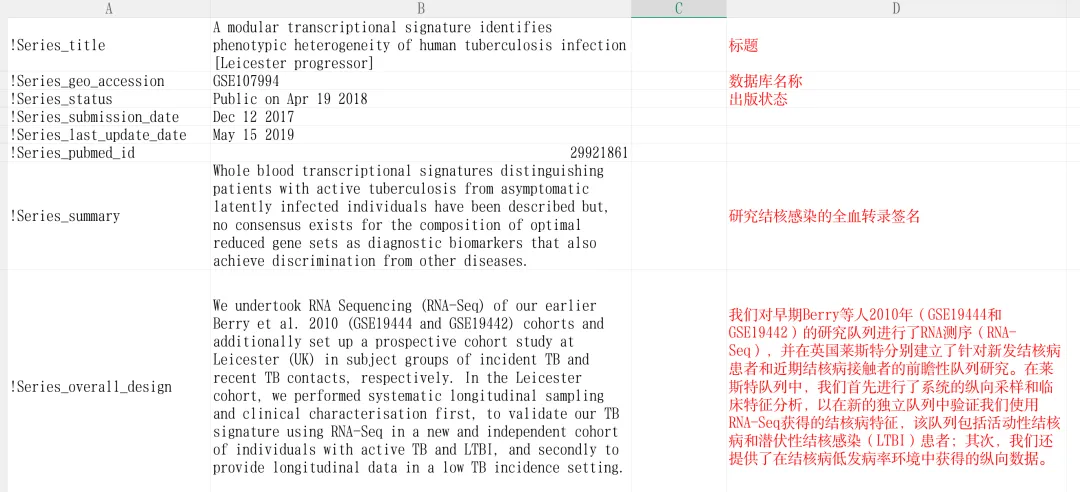
!Series_overall_design:对 Leicester 队列做 RNA-Seq,包含活动性 TB、LTBI、对照、LTBI 进展者纵向样本
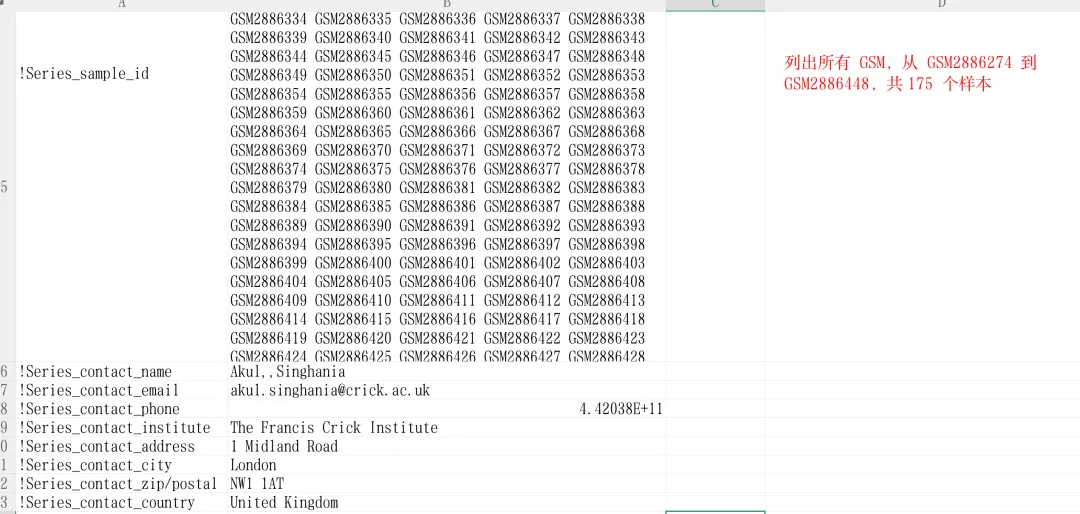
这个界面列出所有 GSM,从 GSM2886274 到 GSM2886448,共 175 个样本
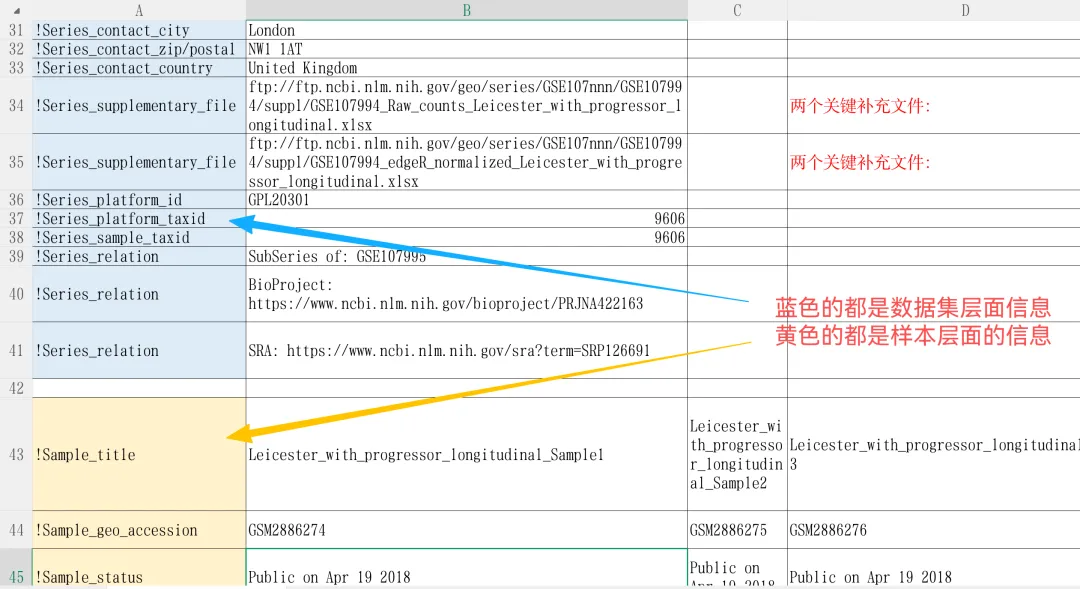
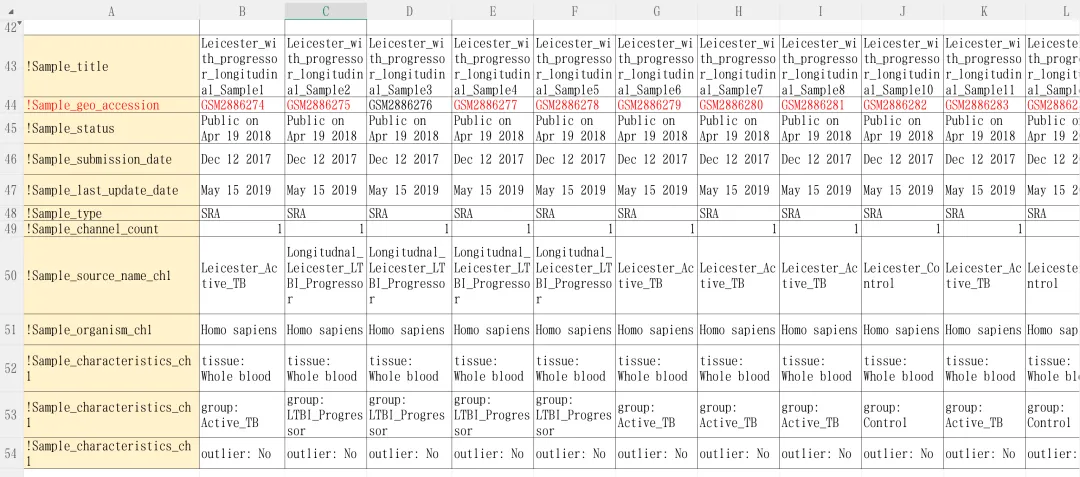
每个样本一列,从 B 列开始,对应 GSM2886274、GSM2886275……GSM2886448。也就是说,每个样本是一列,每个字段是一行。如果用 Excel 直接看,会觉得很长……
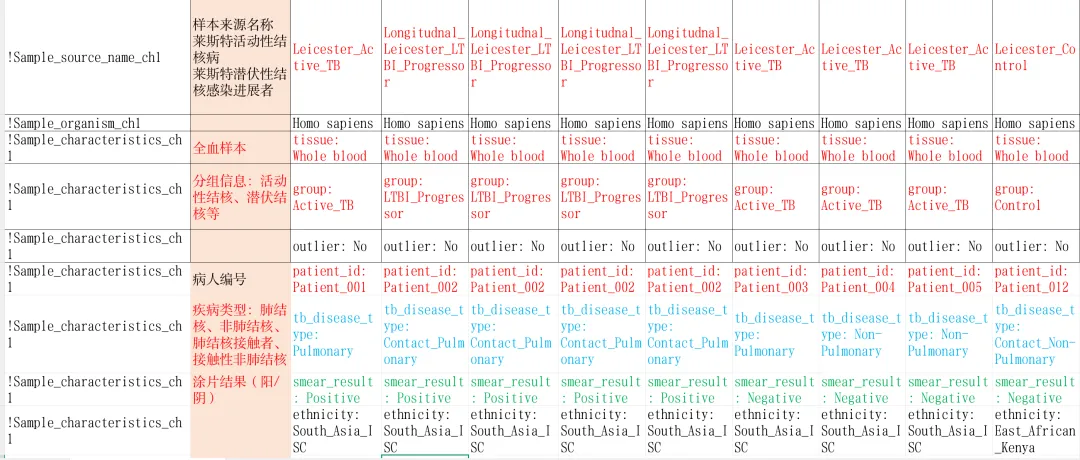
样本层面有很多重要的信息。
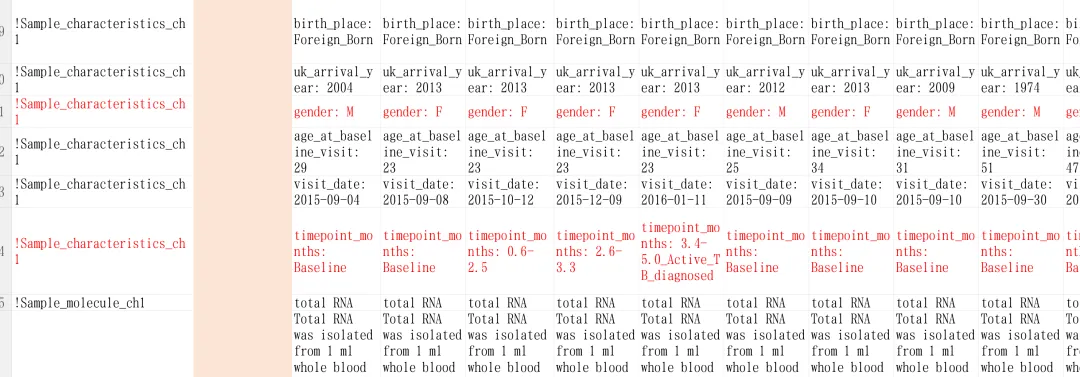
比如我看的这个数据库是结核病相关的,那我就要关注:分组的信息,是全血样本还是单个核细胞,病人的类型有哪些,然后这里也会有涂片的结果、性别、哪个时间点等信息。这个纵向随访信息是非常好的。timepoint_months 和 patient_id 可以识别同一个人的多次采样。例如某些进展者有多个时间点:
Baseline、0.6–2.5 月、2.6–3.3 月、3.4–5.0 月,且标注 Active_TB_diagnosed。这对研究从 LTBI 进展为活动性 TB 的转录变化非常关键。
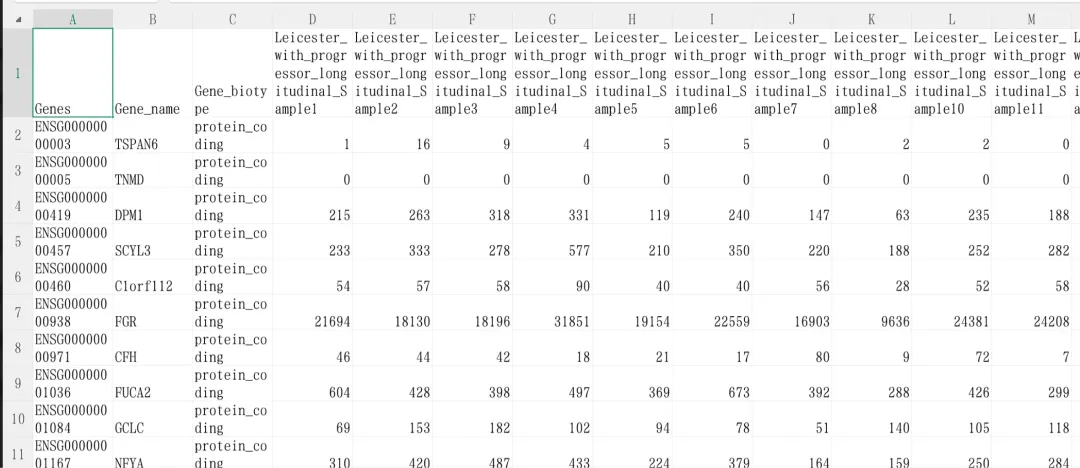
行代表基因,列代表样本。
A列 (Genes):Ensembl 基因 ID(如 ENSG00000000003),这是基因的唯一标识符。
B列 (Gene_name):基因官方名称(如 TSPAN6, TNMD, DPM1),方便人类阅读和理解。
C列 (Gene_biotype):基因类型(protein_coding,即编码蛋白质的基因)。
D列及往右(样本列):每一列代表一个样本。表头是 Leicester_with_progressor_longitudinal_Sample1、Sample2 等。
表格中间的数字(如 1, 16, 9, 0, 215 等)是RNA-Seq 测序比对到该基因上的原始 reads 数(Raw counts)。
例如,基因 TSPAN6 在 Sample1 中的原始 reads 数为 1,在 Sample2 中为 16。基因 FGR 在 Sample1 中为 21694,说明该基因在这个样本中表达量非常高。
因为不同样本的测序深度不同,原始 counts 不能直接横向比较。
GSE107994_edgeR_normalized_Leicester_with_progressor_longitudinal.xlsx(标准化后的表达矩阵)。表格整体结构结构上与 Raw Counts 完全一致: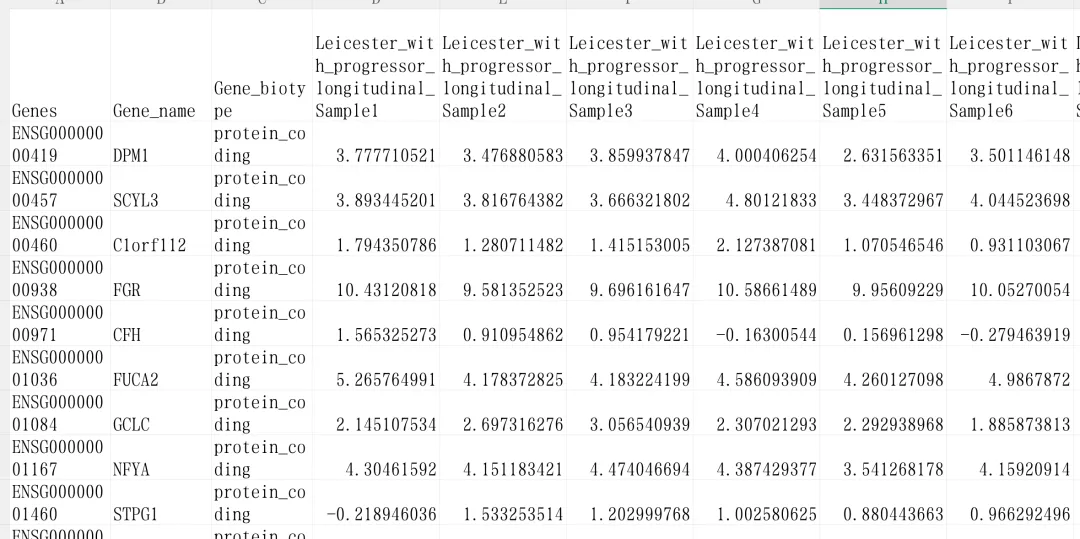
与上一张 Raw Counts 表对比,数据变成了小数和负数。(例如 3.7777, -0.1630, 10.4312)。这是测序的原始读段数经过标准化和 log2 转换后的表达值。
值越高(如 FGR 的 10.43),表示该基因在样本中表达丰度越高。
值越低甚至为负数(如 CFH 的 -0.163),表示该基因表达极低(负数是因为 log2(1) = 0,如果原始 CPM 小于 1,取 log2 后就会是负数)。

